Vercel AI SDK @ai-sdk/zai 3.0.6 更新:智谱模型接入最新解析
AI SDK 生态的持续演进
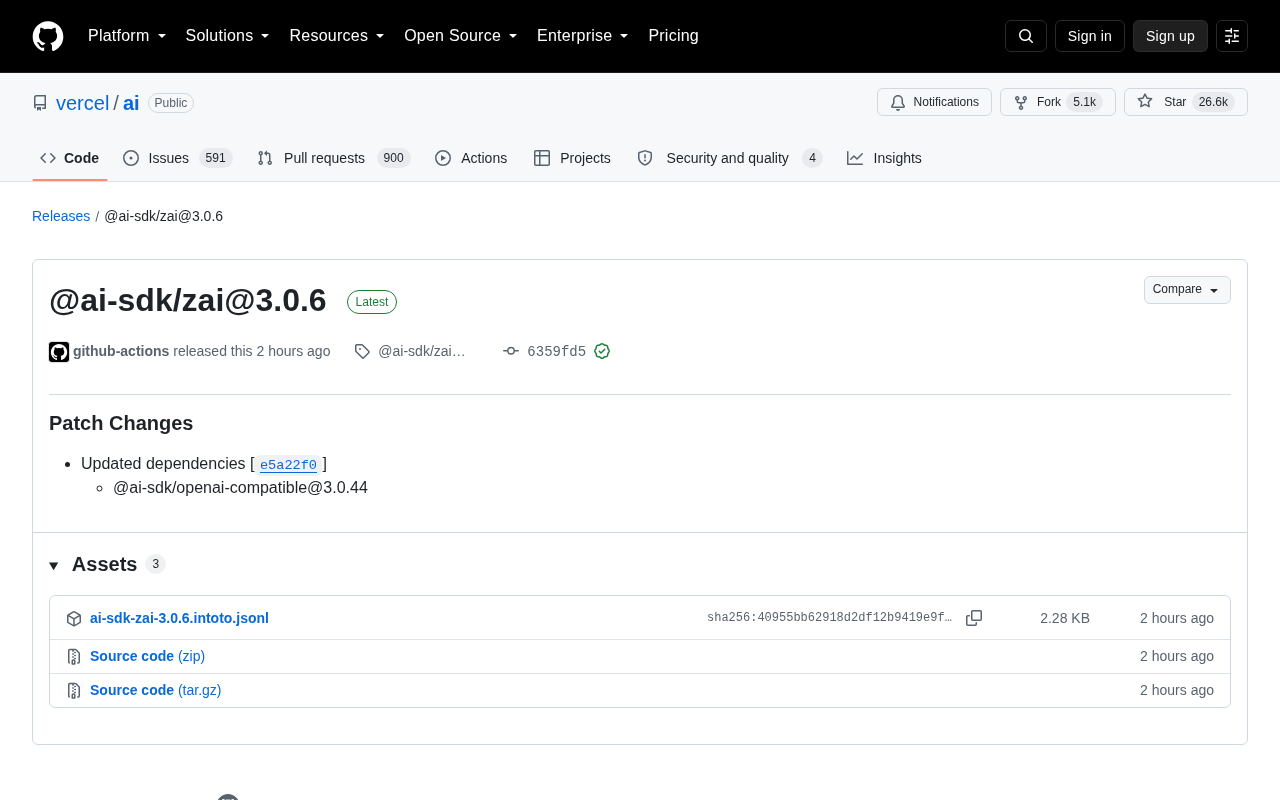
Vercel 的 AI SDK 已经成为 JavaScript/TypeScript 开发者构建 AI 应用最主流的工具链之一。截至目前,其 GitHub 仓库已累计超过 26.6k Star 和 5.1k Fork。近日,AI SDK 生态下的子包 @ai-sdk/zai 迎来了 3.0.6 版本更新,该更新于 9 月 4 日通过 GitHub Actions 自动发布并经过 GPG 签名验证。
虽然这是一个补丁级别(Patch)的小版本更新,但它展现了 Vercel AI SDK 采用的模块化、多 Provider 架构设计理念。
什么是 @ai-sdk/zai
Provider 包的定位
@ai-sdk/zai 是 Vercel AI SDK 的一个 Provider(模型提供方)适配包,用于接入智谱 AI(Z.ai / GLM 系列模型)。在 AI SDK 的架构设计中,核心库负责统一的抽象接口(如 generateText、streamText、generateObject 等),而每一个具体的模型服务商则通过独立的 Provider 包来实现对接。
AI SDK 的 Provider 架构本质上是一种策略模式(Strategy Pattern)的工程实践。每个 Provider 包实现了一组标准化的接口契约(如 LanguageModelV1 接口),包括模型实例化、请求序列化、响应反序列化、token 计数、错误映射等能力。策略模式是 GoF(Gang of Four,即《设计模式:可复用面向对象软件的基础》一书的四位作者)设计模式中的经典行为型模式,其核心思想是将一系列算法封装为独立的类,使它们可以在运行时互相替换。在 AI SDK 的语境下,每个 Provider 包相当于一个具体策略(Concrete Strategy),而 LanguageModelV1 接口则是策略接口(Strategy Interface)。这种设计的深层价值在于实现了「依赖倒置原则」(Dependency Inversion Principle,SOLID 五大原则之一)——上层业务代码依赖抽象接口而非具体实现,使得模型切换、A/B 测试、故障转移(fallback)等场景可以在运行时动态完成,无需修改任何业务逻辑。这种设计使得上层框架(如 Next.js 的 Route Handlers 或 Server Actions)可以完全不感知底层模型的具体实现差异。目前 AI SDK 已有超过 30 个官方和社区维护的 Provider 包,覆盖了从商业 API(OpenAI、Anthropic、Google Gemini)到本地推理引擎(Ollama、LM Studio)的广泛生态。
这些核心 API 分别对应了大语言模型应用中最常见的几种交互模式。generateText 用于一次性获取完整的文本响应,适合离线处理、批量分析等不需要即时反馈的场景;streamText 则通过流式传输(Server-Sent Events 或 WebSocket)逐 token 返回结果,大幅降低用户感知延迟,是聊天类应用的标配。Server-Sent Events(SSE)是一种基于 HTTP/1.1 的单向流式传输协议,服务端通过 Content-Type: text/event-stream 响应头保持连接开放,逐步推送 data: 开头的事件行。相比 WebSocket 的全双工连接,SSE 的优势在于天然兼容 HTTP 基础设施(代理、负载均衡、CDN),且在大多数 LLM 应用中,用户输入和模型输出本就是单向的——用户发送 prompt 后只需接收流式 token,无需双向通信。SSE 还具备自动重连机制(通过 Last-Event-ID 头实现断点续传),浏览器端的 EventSource API 原生支持这一协议。OpenAI 率先在 Chat Completions API 中采用 SSE 作为流式协议,后续被各家模型服务商广泛跟随,使得 SSE 成为 LLM 流式输出的事实标准传输层。
generateObject 则利用结构化输出(Structured Output)能力,让模型直接返回符合预定义 JSON Schema 的对象,省去了开发者手动解析自然语言输出的繁琐步骤。结构化输出解决了 LLM 应用开发中最棘手的问题之一:输出可靠性。传统做法是让模型输出自然语言,再用正则表达式或启发式规则解析,但这种方式极其脆弱——模型输出格式的微小变化就可能导致解析失败。结构化输出通过在推理阶段对模型的 token 采样施加约束(constrained decoding),强制输出符合预定义的 JSON Schema,从而将「概率性输出」转化为「确定性结构」。具体实现上,constrained decoding 通常基于有限状态自动机(FSA)或上下文无关文法(CFG):在每一步 token 采样时,系统会根据当前已生成内容和目标 schema 的语法规则,将不合法的 token 的概率设为零,确保最终输出一定是合法的 JSON。OpenAI 在 2024 年 8 月正式推出原生 Structured Outputs 支持,智谱 GLM-4 也提供了类似的 JSON mode 能力。AI SDK 的 generateObject API 进一步抽象了这一过程——开发者只需提供 Zod schema(TypeScript 生态中最流行的运行时类型验证库),SDK 会自动将其转换为 JSON Schema 传递给模型。
这套 API 的设计思路借鉴了数据库领域的 ORM(对象关系映射)理念——上层业务代码面向抽象接口编程,底层驱动可自由替换。正如 Prisma 或 Drizzle 让开发者用相同的查询语法操作 PostgreSQL、MySQL 或 SQLite,AI SDK 让开发者用相同的 generateText 调用操作 GPT-4、Claude 或 GLM-4。
这种设计的最大优势是:开发者可以用一套统一的 API,无缝切换 OpenAI、Anthropic、Google、智谱等不同厂商的模型,而无需重写业务逻辑。@ai-sdk/zai 正是让中国开发者便捷调用智谱 GLM 系列大模型的关键桥梁。
智谱 AI 与 GLM 系列模型
智谱 AI(Zhipu AI)是由清华大学知识工程实验室(KEG Lab)团队孵化的人工智能公司,其核心产品为 GLM(General Language Model)系列大语言模型。GLM 采用了独特的自回归填空(Autoregressive Blank Infilling)预训练方法——不同于 GPT 系列纯自回归(从左到右逐 token 预测)或 BERT 系列的掩码语言模型(随机遮蔽单个 token),GLM 通过随机遮蔽连续的文本片段(span)并以自回归方式填充,在同一架构中统一了理解和生成能力。这一设计使得 GLM 在中英文双语理解与生成方面表现突出。其旗舰模型 GLM-4 在多项基准测试中达到了与 GPT-4 可比的水平,尤其在中文语境下的表现更具优势,这得益于其训练数据中大规模高质量中文语料的配比。智谱 AI 提供的 API 服务在接口设计上大量兼容 OpenAI 的 Chat Completions 格式,包括相同的请求/响应结构、function calling 支持以及流式传输协议,这使得基于 OpenAI 兼容层的适配成为可能。对于中国开发者而言,智谱 API 还具备国内数据合规(数据不出境,符合《数据安全法》和《个人信息保护法》要求)、低延迟访问(服务器部署在国内机房,无需跨境网络)、人民币计费等实际优势。
版本号解读
3.0.6 这一版本号遵循语义化版本规范(SemVer)。主版本号 3 表明它与 AI SDK 5.x 主线保持同步演进,0.6 中的补丁位则说明这是一次向后兼容的修复性更新,不会破坏现有代码。
语义化版本规范(Semantic Versioning,简称 SemVer)是现代软件工程中最广泛采用的版本号命名约定,格式为 MAJOR.MINOR.PATCH。MAJOR(主版本号)的递增意味着引入了不向后兼容的 API 变更,开发者在升级时需要修改代码;MINOR(次版本号)递增表示新增了向后兼容的功能;PATCH(补丁版本号)递增则仅包含向后兼容的问题修复。在 Node.js/npm 生态中,package.json 中的依赖声明通过 ^(兼容主版本)和 ~(兼容次版本)前缀来控制自动升级范围。例如 ^3.0.0 允许自动升级到 3.x.x 的任何版本,但不会跨越到 4.0.0;而 ~3.0.0 则只允许升级到 3.0.x 范围内。这套规范让包管理器能够在保证兼容性的前提下自动获取最新修复,是大规模依赖管理的基石。值得注意的是,SemVer 在实践中也存在挑战:某些看似无害的补丁更新可能因行为变化导致下游代码出错(所谓「语义漂移」),因此生产环境中通常建议结合锁文件(package-lock.json 或 pnpm-lock.yaml)来固定完整的依赖树。
本次更新的核心内容
依赖项升级
根据官方 Release Notes,@ai-sdk/zai@3.0.6 的核心变更为 Patch Changes(补丁变更),具体内容是更新了其上游依赖:
Updated dependencies [e5a22f0]
- @ai-sdk/openai-compatible@3.0.44
本次更新本身并未直接引入新功能,而是同步升级了它所依赖的 @ai-sdk/openai-compatible 包到 3.0.44 版本。
为什么依赖 openai-compatible
@ai-sdk/openai-compatible 是 AI SDK 提供的一个通用适配层,专门用于对接那些兼容 OpenAI API 格式的第三方模型服务。
OpenAI 的 Chat Completions API 已经成为大语言模型服务的事实标准接口(de facto standard)。这套 API 的核心数据结构包括:请求体中的 model(模型标识)、messages(消息数组,每条包含 role 和 content)、temperature(采样温度,控制输出随机性,范围通常为 0-2,值越低输出越确定)、tools(工具定义数组,描述模型可调用的外部函数)等字段;响应体中的 choices 数组(每个 choice 包含 message 和 finish_reason,后者标识生成结束原因如 stop、length、tool_calls 等)、usage(token 用量统计,包含 prompt_tokens、completion_tokens、total_tokens)等。流式模式下,响应被拆分为多个 SSE 事件,每个事件包含一个 delta 对象(增量内容)。Tool calling(工具调用)协议则涉及 tool_calls 数组和 tool 角色消息的多轮交互——模型在响应中返回 tool_calls(包含函数名和参数),客户端执行后将结果以 tool 角色消息回传,模型再基于工具结果生成最终回答。这套协议的精妙之处在于其扩展性——服务商可以在不破坏基础格式的前提下,通过额外字段(如 extra_body)注入差异化功能。
由于 OpenAI 的先发优势和庞大的开发者生态,全球众多模型服务商——包括智谱 AI、Mistral、Groq、Together AI、Fireworks AI、Ollama 等——都选择兼容这一格式。
OpenAI Chat Completions API 之所以能成为事实标准,与其 2023 年 3 月推出 gpt-3.5-turbo API 的时机密切相关——这是大语言模型首次以极低成本(每千 token 仅 0.002 美元)向开发者开放,迅速催生了海量应用和开源工具链(LangChain、LlamaIndex 等都以 OpenAI 格式为首要支持目标)。随后 2023 年 6 月推出的 function calling、2023 年 11 月的 JSON mode、以及 2024 年 8 月的 structured outputs 功能进一步巩固了其协议地位。值得注意的是,这种趋同并非完全一致:各家服务商在兼容 OpenAI 格式的同时,往往会通过扩展字段提供差异化能力(如智谱的 web_search 工具可实现实时联网搜索、Anthropic 的 extended thinking 支持思维链推理可视化等),这也是 Provider 包需要在兼容层之上做额外适配的原因。Anthropic 的 Claude 是一个有趣的例外——它选择了完全不同的 Messages API 格式,但其开源社区工具(如 LiteLLM)仍提供了 OpenAI 格式的代理转换层。
这种「API 趋同」现象极大地降低了开发者的迁移成本和学习曲线,也催生了 openai-compatible 这类通用适配层的存在价值:只需实现一次兼容层逻辑,即可覆盖数十家服务商。
智谱 AI 的接口在很大程度上兼容 OpenAI 的调用规范,因此 @ai-sdk/zai 选择在 openai-compatible 的基础上进行封装,而非完全从零实现。这样做的好处包括:
- 减少重复代码:请求构造、流式解析、错误处理等通用逻辑复用同一套实现
- 同步获益:当
openai-compatible修复 bug 或增强功能时,zai等下游包可以通过依赖升级自动受益 - 维护成本低:Vercel 团队可以集中精力维护核心兼容层,各 Provider 包只需关注自身的差异化配置(如端点 URL、模型 ID 映射、特有参数等)
从更新方式看工程化实践
自动化发布流程
本次版本由 github-actions 账号自动发布,并采用 GitHub 的 verified signature(GPG Key ID: B5690EEEBB952194)进行签名验证。这体现了成熟开源项目在供应链安全上的实践——通过签名机制确保发布的产物未被篡改,开发者可以放心地将其纳入生产环境依赖。
软件供应链攻击近年来已成为网络安全领域最严峻的威胁之一。2021 年的 SolarWinds 事件中,攻击者将恶意代码注入构建流程,导致约 18,000 家组织(包括美国政府机构)安装了被污染的更新包;2022 年的 npm ua-parser-js 恶意代码注入事件则直接影响了每周数百万次下载量的流行包,攻击者通过劫持维护者账号发布了内含加密货币挖矿程序的版本。此外,2024 年的 xz-utils 后门事件更揭示了长期社会工程学攻击的风险——攻击者花费两年时间赢得维护者信任后植入后门。GPG(GNU Privacy Guard)签名验证是应对这一威胁的关键手段之一:发布者使用私钥对发布产物进行数字签名,消费者通过公钥验证签名的完整性和来源真实性,任何对产物内容的修改都会导致签名验证失败。GitHub 在 2022 年起大力推广 commit 和 release 的签名验证机制,带有绿色 "Verified" 标识的发布表明其确实来自声称的发布者账号。在此之上,SLSA(Supply-chain Levels for Software Artifacts,发音为 "salsa")框架定义了四个安全级别,从基本的构建过程文档化(Level 1)到完全密封的可重现构建(Level 4);Sigstore 项目则提供了无需管理长期密钥的短期签名方案(通过 OIDC 身份绑定和透明日志实现)。Vercel AI SDK 采用 GitHub Actions 自动化发布配合 GPG 签名,代表了当前开源项目在安全实践方面的较高水准。
Monorepo 与 Changesets 管理
Vercel AI SDK 采用 Monorepo(单一代码仓库)管理数十个 Provider 包。从 Release Notes 中「Updated dependencies」的表述可以看出,项目使用了类似 Changesets 的工具来自动追踪包之间的依赖关系。当底层的 openai-compatible 发布新版本时,所有依赖它的上层包(包括 zai)会被自动触发版本递增和发布。
Monorepo 是将多个逻辑上独立的包或项目放在同一个 Git 仓库中管理的策略,被 Google(其内部 monorepo 包含数十亿行代码)、Meta、Vercel 等公司广泛采用。其核心优势包括:跨包代码共享与重构的原子性提交(一次 commit 即可同步修改多个包)、统一的 CI/CD 流程(所有包共享相同的测试和发布基础设施)、以及依赖版本的全局一致性管理(避免不同仓库间的版本不同步问题)。但 Monorepo 也带来了挑战:仓库体积膨胀导致 Git 操作变慢、CI 构建时间增长、以及版本发布的复杂性——当底层包变更时,如何精确判断哪些上层包需要连锁发布?Changesets 正是为解决这一问题而生的工具。其工作流程如下:开发者在提交 PR 时运行 npx changeset 命令,生成一个 .changeset/ 目录下的 Markdown 文件,其中声明影响了哪些包以及变更类型(major/minor/patch)和变更描述。CI 流程在 PR 合并到主分支后,由 Changesets GitHub Bot 自动汇总所有 changeset 文件,计算出每个包的新版本号(包括传递依赖的级联版本递增),生成 CHANGELOG.md,并通过 changeset publish 命令批量发布到 npm。Vercel AI SDK 的 Monorepo 中管理着数十个 Provider 包(OpenAI、Anthropic、Google、智谱等),Changesets 确保了当 openai-compatible 升级时,所有依赖它的包能够自动、一致地完成版本递增和发布。
Vercel AI SDK 的 Monorepo 技术栈不仅包含 Changesets,还依赖 pnpm 作为包管理器和 Turborepo 作为构建编排工具。pnpm(performant npm)通过内容寻址存储(Content-Addressable Storage)和硬链接机制,在 Monorepo 中高效管理数十个包的依赖安装——所有版本相同的依赖包在磁盘上只存储一份,通过硬链接引用,显著节省磁盘空间和安装时间。更重要的是,pnpm 采用严格的 node_modules 布局,避免了 npm 和 yarn 的依赖提升(hoisting)带来的幽灵依赖(Phantom Dependencies)问题——即代码引用了未在自身 package.json 中显式声明的依赖,这种隐式依赖在单独发布时会导致运行时错误。Turborepo(同为 Vercel 产品,2021 年被收购)则通过任务图(Task Graph)分析包间依赖关系,实现增量构建和远程缓存——只重新构建受变更影响的包,未变更包的构建结果从本地或远程缓存中直接复用,大幅缩短 CI 时间。例如,当仅修改了 @ai-sdk/zai 的代码时,Turborepo 不会重新构建 @ai-sdk/openai 等无关包。这套工具链的组合使得管理 30+ Provider 包的开发、测试、发布成为可行且高效的工程实践。
在 Vercel AI SDK 的 Monorepo 中,依赖级联更新遵循严格的拓扑排序逻辑(即根据包间依赖关系的有向无环图 DAG 确定更新顺序)。以本次更新为例,变更路径为:openai-compatible@3.0.44 发布 → Changesets 检测到 zai 包的 package.json 中声明了对 openai-compatible 的依赖 → 自动将 zai 的补丁版本号递增至 3.0.6 → GitHub Actions 触发构建、测试、签名、发布的完整流水线。这一流程中,pnpm workspace 协议(workspace:*)扮演了关键角色——它允许 Monorepo 内部的包在开发时直接引用源码(无需先发布到 npm),获得即时的类型检查和代码跳转体验,而在发布时自动替换为具体的版本号范围(如 ^3.0.44),确保发布到 npm 的包能被外部消费者正常安装。整个级联过程通常在数分钟内完成,无需人工干预,这也是为什么我们能观察到同一时间窗口内多个 Provider 包同步发布新版本的现象。
对开发者的实际影响
是否需要立即升级
对于正在使用智谱模型的开发者而言,这是一次低风险的补丁更新。由于其本质是同步上游依赖的修复,建议在方便时升级以获得 openai-compatible@3.0.44 中包含的改进和修复。命令如下:
npm install @ai-sdk/zai@3.0.6
# 或
pnpm add @ai-sdk/zai@3.0.6
关注上游变更
由于本次核心变更来自 @ai-sdk/openai-compatible,真正想了解具体修复了什么的开发者,应当去查阅该依赖包在 3.0.44 版本的 Changelog。补丁提交哈希 e5a22f0 是追溯具体变更的关键线索——开发者可以在 AI SDK 的 GitHub 仓库中通过 git show e5a22f0 或直接访问 https://github.com/vercel/ai/commit/e5a22f0 查看该提交的完整差异。
总结
@ai-sdk/zai@3.0.6 虽是一次补丁更新,但它展现了 Vercel AI SDK 的架构哲学:统一抽象 + 模块化 Provider + 自动化依赖管理。这套设计让 AI SDK 能够快速支持全球各地涌现的新模型服务,也让开发者在多模型时代拥有了灵活切换的自由。对于国内开发者,@ai-sdk/zai 的持续维护意味着智谱 GLM 系列模型能够始终跟上 AI SDK 主线生态的演进节奏。
相关推荐

对抗AI代码腐化:规格、结果笔记与文件清单的实战方法
一位开发者用八个月、650次提交、4.3万行代码的实战,总结出防止AI智能体代码库腐化的方法:前置规格与验收标准、任务结果笔记、文件清单约束,以及用触发式钩子取代规则文件。核心洞察是——指令只是建议,机制才能在长会话中存活。

"Tokens Exhausted":一段机器人视频背后的AI焦虑
一段名为「Tokens Exhausted」的机器人视频在 Reddit 引发热议,网友已分不清它是否为波士顿动力真实作品。本文解析这段AI讽刺内容为何戳中神经,以及它折射出的合成媒体与LLM时代焦虑。

4千美元淘到全新DGX Spark:本地部署大模型的性价比之选
一位Reddit用户以4000美元在Craigslist淘到全新DGX Spark,用于本地托管AI模型。本文解析这笔交易背后的性价比、二手交易安全,以及本地部署大模型的兴起趋势。