Vercel AI SDK 发布 workflow-harness 1.0.111 补丁更新
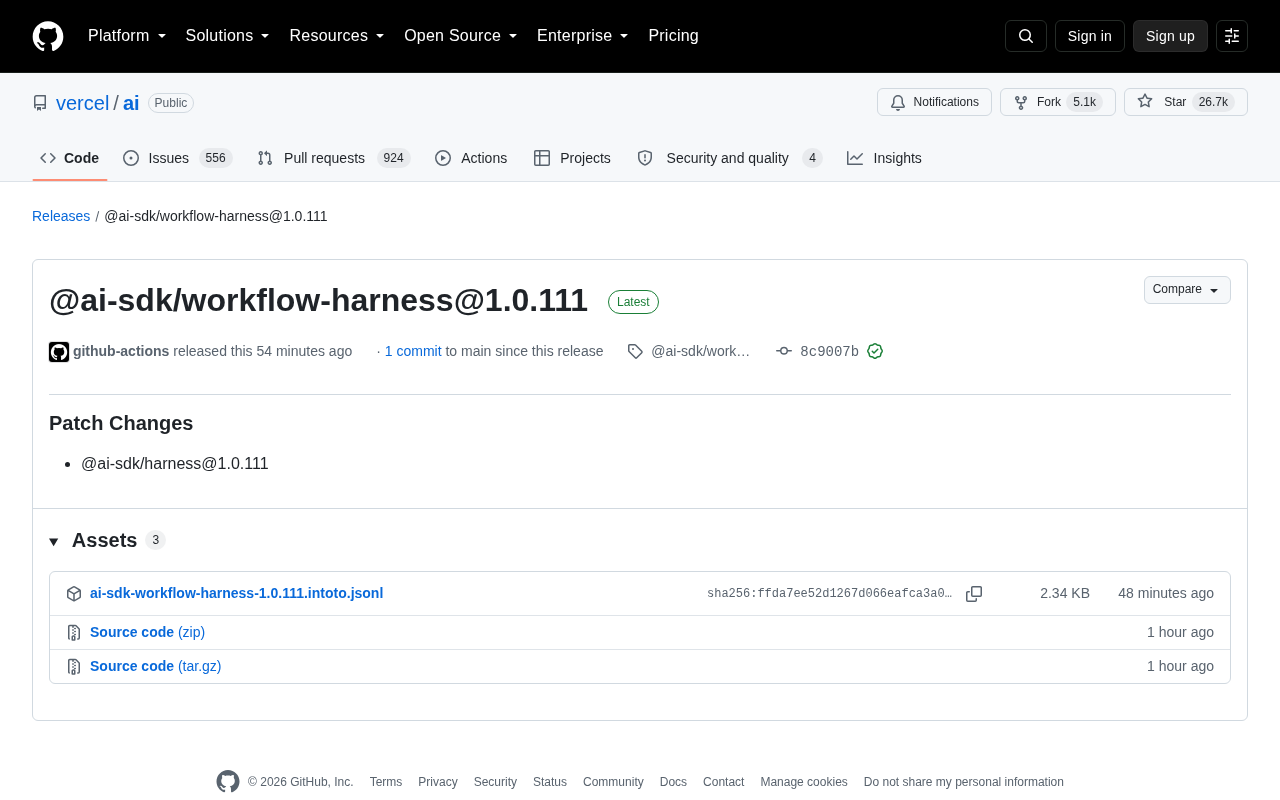
Vercel AI SDK 发布 workflow-harness 1.0.111,核心为同步底层 harness 依赖,属低风险常规补丁维护。
Vercel AI SDK 近日推出 `@ai-sdk/workflow-harness@1.0.111` 补丁版本,本次更新的唯一变更是将底层依赖 `@ai-sdk/harness` 同步升级至相同版本号,属于 monorepo 项目中常见的版本对齐操作。`workflow-harness` 是 AI SDK 生态中负责工作流测试与运行支撑的组件,帮助开发者在受控环境下验证多步 AI 流程。此次发布由 GitHub Actions 自动化完成,并经 GPG 签名验证,保证了产物可信度。对开发者而言,Patch 更新向后兼容、升级风险极低,可按常规测试后跟进,无需担心破坏性变更。该次更新也折射出 Vercel AI SDK 高频稳定的迭代节奏与成熟的工程化实践。
更新概览
Vercel 旗下的 AI SDK 项目近日发布了 @ai-sdk/workflow-harness@1.0.111 版本。作为一次补丁级别(Patch)的更新,本次发布主要涉及内部依赖的同步升级,属于版本迭代中的常规维护动作。
从发布信息来看,该版本由 GitHub Actions 自动化流程于 9 月 15 日构建并发布,提交经过 GitHub 官方 GPG 密钥验证签名,确保了发布产物的完整性与可信度。这类自动化、可验证的发布流程,是成熟开源项目工程规范的体现。
什么是 workflow-harness
workflow-harness 是 Vercel AI SDK 生态中的一个组件包。从命名与所属仓库来看,它服务于 AI 工作流(workflow)的测试与运行支撑(harness 在软件工程中通常指“测试框架/运行支架”),为开发者构建和验证基于 AI SDK 的工作流提供底层能力。
Vercel AI SDK 是当下前端与全栈开发者调用大语言模型的主流工具库之一,其 GitHub 仓库已积累超过 26.7k Star 和 5.1k Fork,社区活跃度可观。该 SDK 以统一的 API 抽象屏蔽了不同模型供应商的差异,让开发者能以一致的方式接入 OpenAI、Anthropic 等多家模型服务。
本次更新的核心内容
本次 1.0.111 属于 Patch Changes(补丁变更),根据发布说明,主要变更为依赖包的版本对齐:
@ai-sdk/harness@1.0.111
换言之,workflow-harness 随其底层依赖 harness 同步升级到相同版本号。这种“联动版本”是采用 monorepo 与 changesets 管理的项目常见做法——多个内部包保持版本一致,便于依赖管理和问题排查。
对于开发者而言,Patch 版本通常意味着向后兼容的缺陷修复或内部优化,不包含破坏性变更(Breaking Changes),升级风险较低。若你正在使用 Vercel AI SDK 的工作流相关能力,可以放心跟进此版本。
对开发者的实际意义
单看一次补丁更新,信息量并不大,但它反映出 Vercel AI SDK 保持着高频、稳定的迭代节奏。对于依赖该 SDK 构建生产应用的团队来说,持续的小版本维护意味着框架在及时响应问题、优化内部实现。
建议的实践方式:
- 使用锁文件(lockfile)管理依赖,在充分测试后再升级到最新补丁版本
- 关注 GitHub Releases 页面获取每次发布的 changesets 说明
- 对于 workflow 类组件,升级后建议跑通现有工作流测试用例,确认行为无回归
需要说明的是,本次发布说明本身较为简略,未披露具体修复了哪些问题的细节。如需了解完整变更,可查阅对应 commit 与依赖包 @ai-sdk/harness 的更新记录。
小结
@ai-sdk/workflow-harness@1.0.111 是一次常规的补丁维护更新,核心是同步底层 harness 依赖版本。它不带来新特性,但体现了 Vercel AI SDK 稳健的工程化发布流程与持续维护的健康状态。对于该生态的使用者,这是一次低风险、可跟进的更新。
相关推荐

让AI审查自己的文档:验证CLAUDE.md真伪的开源工具包
RAG Techniques仓库作者开源了一套工具,用于验证AI Agent读取的CLAUDE.md和项目文档中哪些是猜测、哪些被代码证伪。文章解析其置信度标注机制、与Claude Code /init的对比及局限性。

谷歌又一AI安全研究员离职:警告"我们可能都要死"
谷歌又一位AI安全研究员离职并发出"人类可能面临灭绝"的极端警告,本文解析此类离职背后的行业张力、存在性风险争论以及AI治理的深层挑战。

19.8MB的LLM:44M参数模型如何在CPU上跑出1900 tok/s
开发者QLNI从零训练出仅19.8MB、44M参数的量化语言模型SHADOW-50M,采用三元权重和冻结指纹词表,CPU上跑出约1900 tok/s。它把计算交给专用电路、记忆交给磁盘索引,在精确计算与可靠检索任务上超越同级模型。