VERITAS: verbalising模型计算,揭示思维链忠实度的新方法
VERITAS 用逐层 Jacobian 投影追踪推理锚点,检测并解释 CoT 不忠实。
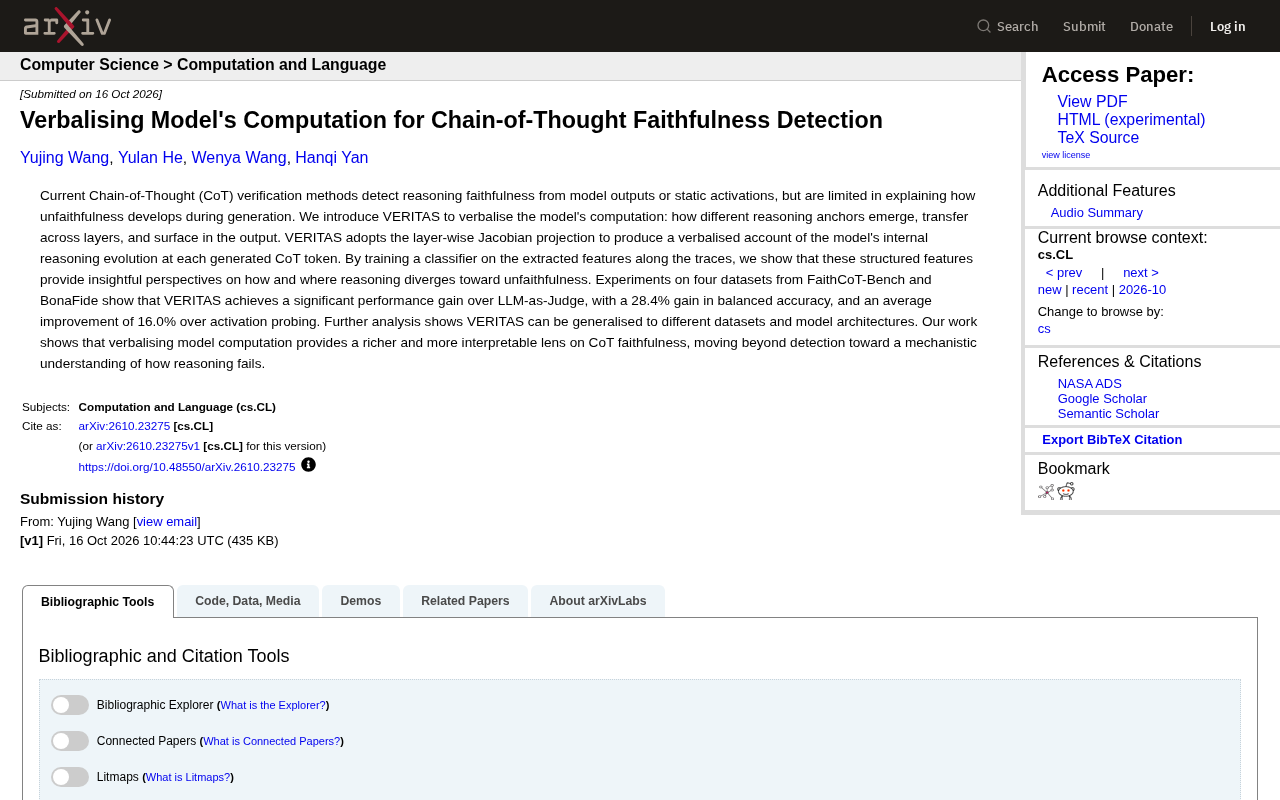
文章介绍新论文提出的 VERITAS 方法,用于检测思维链(CoT)推理是否忠实反映模型内部计算。现有方法多从输出文本或静态激活做二分类判断,只能知道结果不忠实,无法定位偏离发生在哪一层、哪个生成步骤。VERITAS 在每个 CoT token 处对模型各层做逐层 Jacobian 投影,将内部计算状态映射到可解释特征空间,结构化记录推理锚点的出现、层间传递与输出浮现,形成一条迹线,并据此训练分类器区分忠实与不忠实推理。在 FaithCoT-Bench 和 BonaFide 四个数据集上,其平衡准确率比 LLM-as-Judge 高 28.4%,比激活探测平均提升 16.0%,并展现出跨数据集、跨模型架构的泛化能力。文章认为其价值在于把忠实度从黑箱标签展开为可观察的层间动态过程,推动从检测走向机制性理解。
思维链(Chain-of-Thought, CoT)推理让大模型展示解题步骤,但这些步骤是否真实反映了模型内部的计算过程?现有验证方法多从输出或静态激活中检测不忠实,却难以解释不忠实如何在生成过程中逐步形成。一篇新论文提出 VERITAS,通过“verbalise”模型计算,逐层追踪推理锚点的出现、传递与输出,为 CoT 忠实度检测提供了更具机制解释力的视角。
现有方法的局限:只看结果,不看过程
当前 CoT 验证主要依赖两类信号:一是直接分析模型输出文本,二是探测静态激活模式。这两种方式能判断最终答案是否忠实,却无法回答一个关键问题——不忠实推理是在哪一层、哪个生成步骤中偏离的。换句话说,我们只知道“结果不对”,不知道“过程如何变坏”。
VERITAS 的出发点正是填补这一空白。它不满足于二分类式的忠实度判断,而是试图构建模型内部推理演化的“口头叙述”(verbalised account),让不忠实的形成过程变得可观察、可解释。
CoT 忠实度(faithfulness) 指的是模型输出的推理链是否真实反映了其内部实际计算过程。一个推理链即使逻辑自洽、最终答案正确,也可能并非模型得出答案的真实路径——模型可能事后编造看似合理的步骤,或在推理中途“暗中”改变了计算依据。忠实度与正确性(accuracy)是两个独立维度:正确的答案可以来自不忠实的推理,忠实的推理也可能因偶然错误而得出错误答案。现有验证方法之所以“只看结果”,是因为它们通常只检查输出文本与答案的一致性,或对某一静态层的激活做探测,因而无法定位偏离发生的层与生成步。
VERITAS 的核心机制:逐层 Jacobian 投影
VERITAS 采用逐层 Jacobian 投影(layer-wise Jacobian projection),在每个生成的 CoT token 处,将模型内部各层的计算状态投影到一个可解释的特征空间。这样做的效果是:模型在不同层中形成的“推理锚点”(reasoning anchors)如何出现、如何在层间传递、最终如何浮现在输出中,都能被结构化地记录为一条迹线(trace)。
基于这些迹线特征,研究团队训练了一个分类器来区分忠实与不忠实的推理。与 LLM-as-Judge 和激活探测(activation probing)相比,这种结构化特征不仅检测更准,还能指出推理偏离的具体位置和方式。
Jacobian 矩阵描述的是一个向量值函数对输入向量的所有一阶偏导数,其元素 J_ij = ∂f_i/∂x_j 刻画了输入第 j 个分量微小变化对输出第 i 个分量的影响。在神经网络中,Jacobian 可用来量化某一层激活对后续层或最终输出的敏感度与贡献方向。逐层 Jacobian 投影即对每一层分别计算这种局部线性化关系,再将高维的敏感度结构投影到低维、可解释的特征空间。相比只看单点激活值,Jacobian 保留了“层与层之间如何相互影响”的动态信息,因此能追踪某个推理锚点从下层到上层的传播路径,而不仅是它在某一层的瞬时强度。
推理锚点(reasoning anchor) 是 VERITAS 引入的分析单元,指模型内部承载某个具体推理要素(如中间结论、实体关系或计算中间量)的表征状态。锚点不是人工标注的文本片段,而是从逐层投影特征中识别出的、在层间稳定传递并最终影响输出的内部模式。追踪锚点的意义在于:不忠实往往表现为某个关键锚点在传递过程中被削弱、替换或绕过,而最终输出仍保持表面连贯。通过记录锚点的出现层、传递路径与输出浮现位置,VERITAS 把“过程如何变坏”转化为可比较的结构化迹线,而非单一忠实度标签。
实验表现:显著优于基线方法
在 FaithCoT-Bench 和 BonaFide 的四个数据集上,VERITAS 取得了明显的性能提升:平衡准确率(balanced accuracy)比 LLM-as-Judge 高出 28.4%,比激活探测平均提升 16.0%。更关键的是,该方法展现出跨数据集和跨模型架构的泛化能力,说明其提取的特征并非过拟合于特定设置。
论文进一步分析表明,VERITAS 不仅能检测不忠实,还能提供关于“如何”与“何处”推理发生偏离的洞察。这使其从单纯的检测工具,向机制性理解迈进了一步。
平衡准确率(balanced accuracy) 是各类别召回率的算术平均,适用于正负样本比例不均衡的二分类评估。在 CoT 忠实度检测中,忠实与不忠实的样本数量往往差异较大,普通准确率会被多数类主导,而平衡准确率能同等对待两类错误。LLM-as-Judge 指让另一个大模型充当评判者,阅读推理链并判断其是否忠实;它依赖评判模型自身的推理能力,成本高且易受评判模型偏见影响。激活探测(activation probing) 则是在模型某一层或某几层的激活上训练线性分类器来预测忠实度,属于静态、单点式的检测,难以捕捉层间动态。VERITAS 与这两类基线对比,正好说明结构化过程特征相对于“黑箱评判”和“静态探测”的优势。
从检测到理解:机制性视角的价值
VERITAS 的意义在于提出了一种新范式:通过 verbalise 模型计算来审视 CoT 忠实度。传统方法把忠实度当作一个黑箱标签,而 VERITAS 将其展开为层间动态过程,让研究者能看到推理锚点的迁移轨迹。这种视角对于构建更可靠、更可解释的推理系统具有潜在价值。
当然,该方法目前仍依赖分类器对迹线特征进行判别,距离完全自动化地“讲述”模型推理故事还有距离。但它清晰地展示了一个方向:理解推理失败,需要深入生成过程本身,而非仅检查最终输出。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。