Vibe Coding 越火,我越敬佩老派软件工程师

开发者用 Claude 逆向重写经典软件翻车,揭示 vibe coding 的适用边界。
一位开发者用 Claude 以 vibe coding 方式逆向重写几款经典软件,试图用第一性原理砍掉冗余,结果耗费大量时间和 token 却收效甚微,还不如直接买正版。原因在于老软件诞生于严苛的硬件约束下,每个字节都有存在理由,几乎没有可删的冗余。作者由此指出 vibe coding 的边界:它适合原型、胶水代码和个人小工具,但在性能敏感、资源受限、需长期维护的场景中力不从心。AI 生成代码默认继承资源充裕假设,擅长堆叠合理结构,却不擅长逐字节取舍。文章将这归结为约束文化与充裕文化的碰撞,主张在享受速度的同时保留对资源开销的敏感。
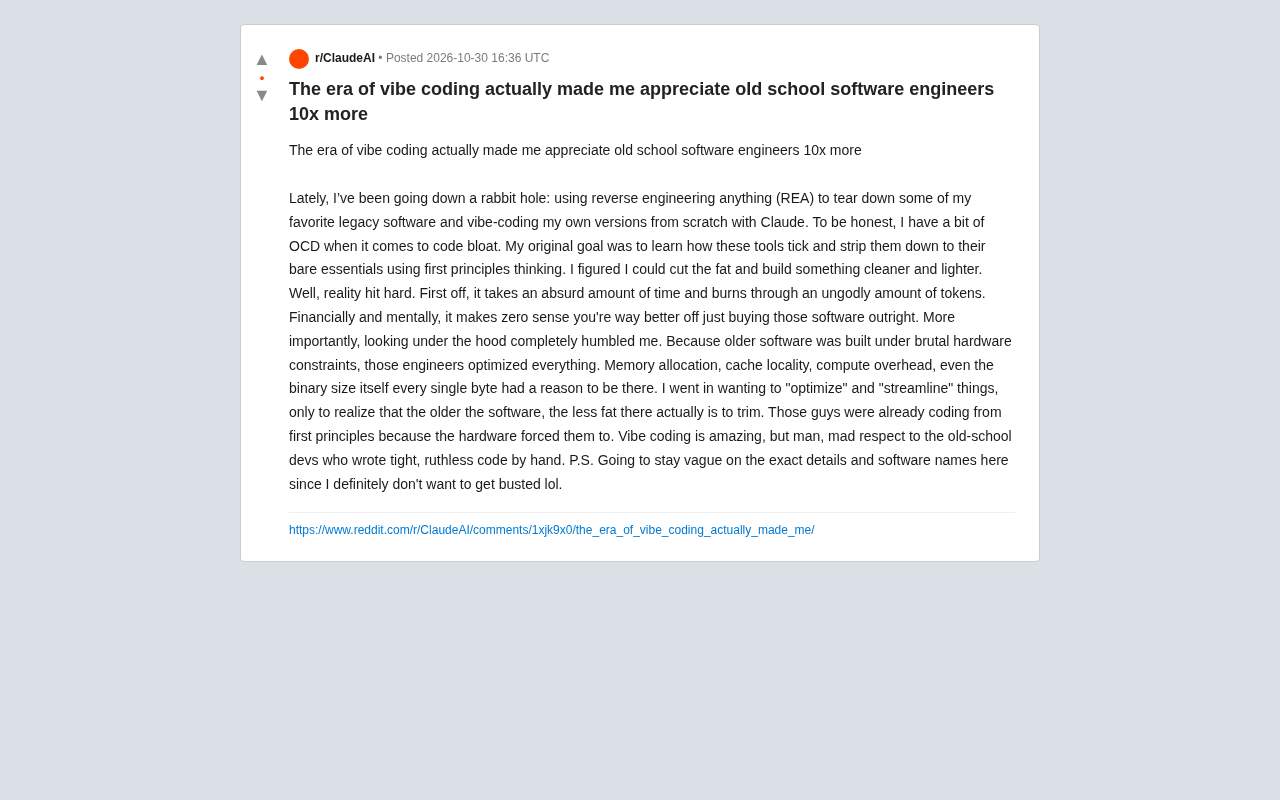
一位开发者在 Reddit 上分享了自己用 Claude 进行 vibe coding、试图逆向重写经典软件的翻车经历。他原本想用第一性原理砍掉所谓的“代码脂肪”,结果却被老一代工程师在严苛硬件限制下写出的极致紧凑代码狠狠上了一课。这个故事之所以引发共鸣,是因为它戳破了一个流行叙事:AI 编程让写软件变得前所未有的容易——但让软件变得好,依然是另一回事。
一次逆向重写,撞上现实的墙
这位开发者的出发点相当典型:他对代码膨胀有近乎强迫症的敏感,于是挑选了几款自己喜爱的经典软件,用逆向工程手段拆解其结构,再借助 Claude 从零 vibe code 出自己的版本。目标很清晰——用第一性原理还原工具的本质,去掉冗余,做出更干净、更轻量的替代品。
结果很快就失控了。他描述这一过程“耗费了荒谬的时间,烧掉了海量的 token”,从财务和心理两个维度衡量都完全不划算,不如直接买正版软件来得省事。更关键的是,当他真正潜入那些软件的底层,看到的是与自己预期截然相反的画面——那里几乎没有什么“脂肪”可以削。
这段经历的价值在于它的诚实。Vibe coding 的吸引力很大程度上来自“快速见到东西跑起来”的爽感,但当目标从“能跑”升级为“跑得更好”时,速度优势会迅速被理解成本和试错成本吃掉。
Vibe coding 是 2025 年初由 Andrej Karpathy 提出并迅速流行开来的说法,指开发者主要用自然语言向 AI 描述意图、由模型生成并迭代代码,自己更多扮演审阅者和方向把控者的角色,而非逐行手写。它的典型工作流是「描述—生成—运行—反馈—再生成」,把编程的重心从语法细节转移到意图表达和结果验证上。这一模式的效率优势在从零起步、需求模糊的探索阶段最明显,但也天然带来两个问题:一是生成代码的质量上限取决于提示与审阅的严格程度,二是开发者容易在不完全理解生成结果的情况下继续叠加新代码,导致后期调试和重构成本被推迟而非消除。
老软件里没有多余字节
作者的核心洞察是:老一代软件是在极其残酷的硬件约束下诞生的。内存分配、缓存局部性、计算开销、乃至二进制文件本身的体积,每一个字节都有存在的理由。当年的工程师没有挥霍资源的余地,硬件逼着他们从第一性原理出发写代码。
这解释了一个反直觉的现象——软件越老,能砍掉的“肥肉”反而越少。带着优化和精简的雄心进去,出来时只剩下敬佩。他在帖子里写道,向那些用手写出紧凑、无情代码的老派开发者致以极大的敬意。
这里值得多想一层。现代开发环境提供了充裕的内存、强大的 CPU 和层层抽象框架,代价是开发者对底层资源的感知变钝了。AI 生成代码时继承的恰恰是这种“资源充裕”的默认假设——它擅长堆叠合理但未必必要的结构,而不擅长在每一个字节上做取舍,因为后者需要的是对具体运行环境的深度理解,而非模式匹配。
缓存局部性(cache locality) 指程序访问内存时,尽量让相邻或近期用过的数据在物理上靠得近、在时间上挨得紧,从而命中 CPU 各级缓存、避免昂贵的主存访问。它在老一代软件中是被手工精心安排的核心优化手段:数据结构布局、遍历顺序、内存池设计都要围绕缓存行大小和层级结构来考虑。现代高级语言和框架往往把内存布局交给运行时和垃圾回收器,开发者很少直接感知缓存行为,编译器优化和硬件预取也掩盖了大部分代价。但一旦进入性能敏感路径——热循环、实时处理、嵌入式——缓存局部性仍然是决定数量级差异的关键,而这类优化恰恰依赖对具体硬件和数据访问模式的深入分析,难以靠模式匹配式的代码生成获得。
Vibe Coding 的边界在哪里
作者的态度并不否定 vibe coding,他明确说这项技术“很惊人”。真正被质疑的是它的适用边界。
- 适合的场景:原型验证、胶水代码、个人小工具、把想法快速变成可运行的东西。在这些场景里,速度就是最大的价值,代码质量的下限要求不高。
- 吃力的场景:性能敏感的系统、资源受限的嵌入式环境、需要长期维护的核心基础设施。这些领域里,每一点效率都来自对硬件的精确把握,而这正是 vibe coding 最薄弱的环节。
他在帖子里特意隐去了具体软件名称和细节,理由是“不想被抓”,这个玩笑背后也透露出逆向工程本身的灰色地带——学习目的与侵权边界之间的分寸并不总是清晰。
胶水代码(glue code) 指把两个已有系统、库或服务连接起来的那部分代码,本身不承载核心业务逻辑,只负责格式转换、调用编排、错误传递等衔接工作。它通常生命周期短、逻辑直白、对性能不敏感,却占据了实际开发中相当比例的工作量,因此是 AI 辅助生成收益最高的场景之一。与之相对的是核心基础设施代码:它被大量下游依赖、需要长期演进、每一次改动都可能引发连锁影响,对正确性、可维护性和资源开销的要求远高于胶水层。区分这两类代码,是判断「哪些可以放心交给 AI、哪些必须人工把关」的一个实用切分标准。
新旧两种工程文化的碰撞
把这件事放到更大的背景里看,它其实是两种工程文化的对照。老派工程师的代码是约束的产物:内存有限、算力有限、存储有限,每一次设计决策都被迫权衡。现代 AI 辅助开发则是充裕的产物:token 管够、算力管够,开发者更倾向于快速迭代而非精雕细琢。
两种文化各有合理性。充裕环境下诞生的软件迭代快、覆盖面广,这是老派方式难以企及的。但约束环境下锤炼出的效率意识,是充裕环境下最容易丢失的东西。真正值得追求的,或许不是站队任何一边,而是在享受 vibe coding 速度的同时,保留一份对资源开销的敏感——知道什么时候该让 AI 放手去写,什么时候该亲手接管那些关键的、紧凑的、不容浪费的部分。
那位开发者用一次代价高昂的尝试换来了这个认知,而这份认知,恰恰是 AI 暂时无法替他完成的部分。
相关推荐

DeepSeek开源DeepInfer:推理框架到底有什么用?
DeepSeek开源推理框架DeepInfer,采用Apache 2.0许可证,支持DeepSeek V4.1 Flash离线推理。本文解析其请求调度、FlashMLA/DeepGEMM计算优化、DSPark投机验证加速以及对开发者和普通用户的实际意义。

开源AI学习智能体:从拓扑图到试卷生成的全流程体验
探索开源AI学习智能体:基于DeepSeek API,通过拓扑图构建知识体系,支持自动文档生成、笔记、超级文档和试卷考试。了解其Agent工作流与设计亮点。

开源大肥鱼Pro桌宠:集成AI对话与音乐联动,全平台安装指南
大肥鱼Pro版开源桌宠集成AI对话、唱歌分声与音乐软件联动,支持Windows、Linux、macOS全平台。本文介绍其核心功能与两种安装方式,包括直接通过GitHub部署和借助AI助手代装,适合桌面美化与AI应用爱好者参考。