VICO框架:让视觉环境与视觉语言模型协同进化

VICO让视觉训练环境随模型能力动态进化,无需额外标注即可持续提供恰当难度的训练任务。
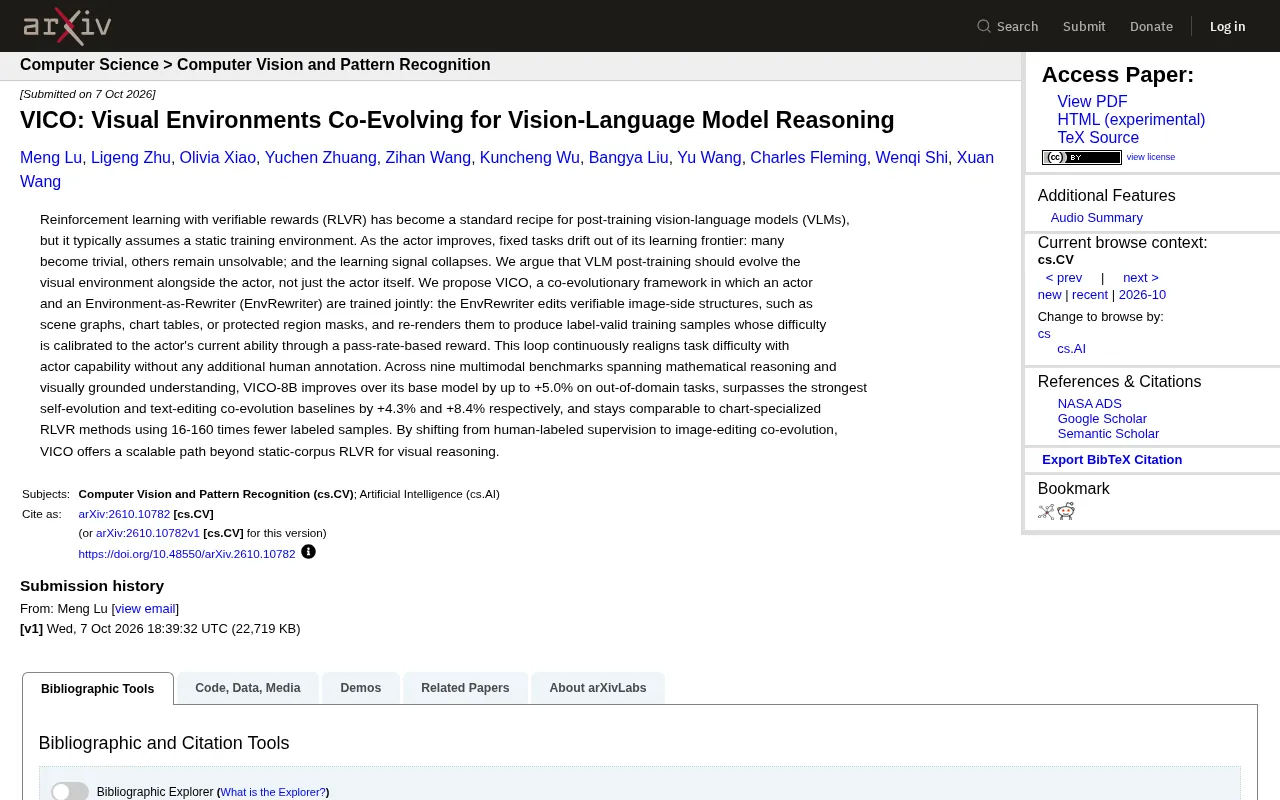
VICO(Visual Environments Co-Evolving)针对视觉语言模型后训练中静态语料库导致学习信号坍塌的问题,提出了一种协同进化框架。其核心组件EnvRewriter通过编辑场景图、图表数据表等可验证的图像结构并重新渲染,持续生成难度与模型当前能力相匹配的训练样本,全程无需人工标注。难度校准依赖通过率奖励信号:模型通过率过高则生成更难任务,过低则降低难度,形成自适应的闭环。实验在九个多模态基准上验证了这一机制,VICO-8B在域外任务上比自进化基线高出+4.3%,并以少16至160倍的标注样本达到图表专用RLVR方法的水平,展示出显著的数据效率优势。
静态训练环境的困境
可验证奖励强化学习(RLVR)已成为视觉语言模型(VLM)后训练的标准方案,但它存在一个被长期忽视的前提——训练环境是静态的。VICO论文直指这一痛点:当模型(actor)能力不断提升时,固定不变的任务会逐渐偏离它的学习前沿。
具体表现为两类问题:一部分任务对模型来说变得过于简单,失去训练价值;另一部分则始终无法攻克。结果是学习信号逐渐坍塌,模型的提升陷入停滞。这就像让一个水平不断上涨的学生反复做同一套难度固定的习题,收益注定递减。
论文提出的核心观点很鲜明:VLM后训练应该让视觉环境与模型本身一同进化,而不是只优化模型单方。
可验证奖励强化学习(RLVR)的核心思想是:用模型能否自动验证的任务结果(如数学答案是否正确、目标位置是否匹配)作为奖励信号,替代人工打分。相比传统的监督微调,RLVR不需要大量"输入-正确输出"对,只需要设计好验证函数。这使它在数学推理、代码生成等领域取得了显著成果,也因此被移植到视觉语言模型的后训练阶段。然而,RLVR的奖励信号质量极度依赖任务难度分布——任务太易则奖励饱和、梯度消失;任务太难则模型几乎从不成功、奖励稀疏。两种情况都会让训练陷入停滞。这一矛盾在静态语料库中无法自我修正,是RLVR应用于持续训练时的结构性缺陷。
VICO的协同进化机制
VICO(Visual Environments Co-Evolving)是一个协同进化框架,其巧妙之处在于引入了一个被称为"环境改写器"(Environment-as-Rewriter,简称EnvRewriter)的组件,与actor联合训练。
EnvRewriter如何工作
EnvRewriter的职责是编辑图像侧的可验证结构,比如场景图(scene graphs)、图表数据表(chart tables)或受保护的区域掩码(protected region masks),然后重新渲染这些结构,生成标签依然有效的训练样本。
关键在于,这些新样本的难度会根据actor当前的能力进行校准。校准依据是一种"基于通过率的奖励"(pass-rate-based reward)——如果模型对某类任务通过率过高,说明太简单;过低则说明太难。通过这个信号,系统持续生成难度恰到好处、落在模型学习前沿的任务。
场景图(scene graph)是一种将图像内容结构化表示的形式:以物体为节点、物体间的空间或语义关系为边,构成有向图。例如,一张图可以被表示为"猫 → 在…上方 → 桌子"。由于场景图显式编码了可验证的视觉关系,EnvRewriter可以通过修改节点属性(如颜色、数量)或边的关系,系统性地改变问答难度,同时利用图结构直接推导出新的正确答案,无需重新标注。图表数据表同理,修改单元格数值后的问题答案可以由程序自动计算得出。这种"先编辑结构化中间表示、再渲染成图像"的流程,是VICO能在不依赖人工标注的前提下生成有效训练样本的技术关键。
无需额外人工标注
这套循环机制最具价值的一点,是它能持续将任务难度与模型能力重新对齐,而全程不需要任何额外的人工标注。因为EnvRewriter编辑的是可验证的图像结构,重新渲染后的样本自带正确标签,这从根本上绕开了传统方法对大规模人工标注数据的依赖。
实验表现与数据
VICO在九个多模态基准上进行了验证,覆盖数学推理和视觉落地理解(visually grounded understanding)两大类任务。以VICO-8B模型为例,论文报告了以下几组关键数据:
- 相比基座模型,在域外(out-of-domain)任务上最高提升 +5.0%
- 超越最强的自进化基线 +4.3%
- 超越文本编辑式协同进化基线 +8.4%
- 与专门针对图表优化的RLVR方法表现相当,但所用标注样本少了16到160倍
其中最后一组数据尤其值得关注。能够在标注样本数量减少一到两个数量级的情况下,达到与专用方法相当的效果,这直接印证了协同进化路径在数据效率上的优势。
为什么这条路径有意义
VICO的真正贡献,是把VLM后训练从"人工标注监督"转向了"图像编辑协同进化"。
传统RLVR依赖静态语料库,其能力上限受限于标注数据的规模和质量。而VICO通过让环境动态生成校准难度的样本,提供了一条可规模化的新路径。模型越强,环境就生成越有挑战性的任务;两者在训练过程中相互牵引、共同成长。
这种思路与近年来AI训练中"自对弈""课程学习"的理念一脉相承,但VICO将其落地到了视觉模态这一相对更难操作的领域——毕竟编辑图像并保证标签有效,比修改文本要复杂得多。VICO通过操作场景图、图表和掩码等结构化中间表示,巧妙地解决了这个问题。
对于关注多模态大模型训练效率的研究者和工程团队而言,VICO提供了一个超越静态语料RLVR的可行方向,尤其在高质量标注稀缺的场景下更具实践价值。
课程学习(Curriculum Learning)是指按照由易到难的顺序安排训练样本,让模型在每个阶段都处于"最近发展区"——即略超出当前能力但可以通过努力习得的难度区间。自对弈(Self-Play)则更进一步:智能体通过与自身或自身的历史版本博弈来产生有挑战性的对手,AlphaGo、OpenAI Five等系统均采用了这一机制。VICO的协同进化可以看作这两种思路在视觉语言模态的融合:EnvRewriter扮演了"会根据学生能力动态出题的教师"角色,通过率奖励则自动校准课程难度,避免了人工设计课程时的主观偏差和滞后性。与纯文本领域相比,视觉模态的难点在于图像编辑必须同步保证渲染质量和标签一致性,VICO通过操作结构化中间表示而非直接编辑像素,有效规避了这一挑战。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。