video-subtitle-remover:本地AI去除视频硬字幕与水印
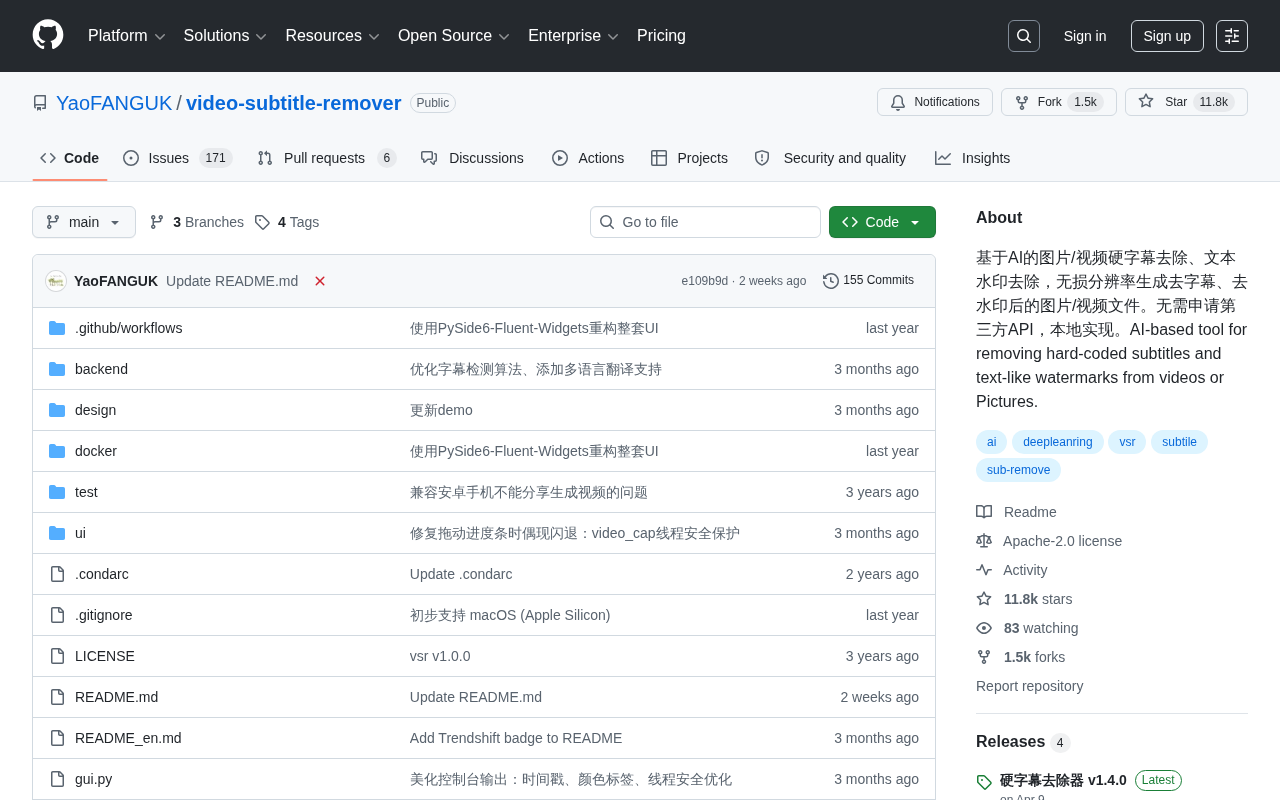
开源工具VSR借助AI图像修复技术,在本地无损去除视频硬字幕与文本水印。
video-subtitle-remover(VSR)是一个基于Python的开源项目,专注于从视频和图片中去除硬编码字幕与文本水印。与商业云端工具不同,VSR完全本地运行,无需第三方API,输出保持原始分辨率不降质。其技术核心是"检测+修复"两阶段流程:先定位字幕像素区域,再调用深度学习图像修复模型重建被遮挡的背景内容。该工具适用于二次创作素材处理、多语言字幕替换等场景,但在复杂背景和快速运动画面下修复效果会明显下降,逐帧AI推理对GPU硬件也有一定要求。使用时还需注意素材的版权合规。项目在GitHub已获超10700 Stars,是同类工具中关注度较高的选项。
在处理带有硬字幕(烧录进画面的字幕)或文本水印的视频时,传统做法往往只能靠遮挡、裁剪或马赛克,代价是牺牲画面完整性。开源项目 video-subtitle-remover(VSR)提供了另一条路径:借助AI修复算法,在本地无损分辨率下擦除硬字幕和文本水印,并对被覆盖区域进行智能填充。该项目目前在 GitHub 已累积超过 10700 Stars、1369 Forks,是同类工具中关注度较高的一个。
项目定位与核心能力
video-subtitle-remover 由开发者 YaoFANGUK 维护,使用 Python 编写,核心目标非常聚焦:从图片和视频中去除硬编码字幕(hard-coded subtitles)与类文本水印(text-like watermarks)。
与依赖云端服务的商业工具不同,VSR 强调完全本地实现,无需申请任何第三方 API。这意味着待处理的视频素材不必上传到外部服务器,对于涉及隐私或版权敏感内容的用户来说,本地处理是一个实际的优势。
项目名称中的关键词“无损分辨率”也值得留意——工具在去除字幕后生成的输出文件保持原始分辨率,而不是通过降采样或裁剪来规避字幕区域。
技术原理:从字幕检测到画面修复
硬字幕去除本质上是一个“检测 + 修复”的两阶段问题。第一步需要定位画面中字幕或水印所在的像素区域,第二步则要对这些区域进行内容填充(inpainting),让被擦除的部分与周围画面自然衔接。
VSR 的思路正是围绕这一流程展开:先识别字幕/水印区域,再调用图像修复模型对该区域重建背景。对于视频,这一过程需要逐帧处理,同时兼顾帧与帧之间的连贯性,避免出现修复痕迹在时间轴上闪烁的问题。
相比简单地用纯色块或高斯模糊遮盖字幕,基于AI的修复能够尽量还原被字幕遮挡的原始画面纹理,这也是这类工具与传统打码方式的根本区别。
图像修复(Image Inpainting)是计算机视觉领域的一个经典问题,目标是根据图像中已知区域的内容,合理推断并填充缺失或被遮挡的区域。早期方法依赖扩散方程或纹理合成,只能处理简单背景。近年来基于深度学习的修复模型——例如 NVIDIA 提出的 Partial Convolution、以及后续的 LaMa(Large Mask inpainting)等——能够利用全局语义信息生成视觉上更连贯的填充结果,使得处理复杂纹理背景成为可能。VSR 正是借助此类预训练修复模型,将字幕掩码区域交由模型重建背景,而非简单插值或克隆周边像素。对于视频场景,时序一致性是额外挑战:每一帧独立修复容易导致相邻帧间填充区域出现颜色或纹理抖动(temporal flickering),更完善的方案需要引入光流或跨帧约束来保持连贯性。
适用场景与实际价值
这类工具的典型使用场景包括:
- 二次创作与素材整理:处理带有平台水印或烧录字幕的视频素材,便于后续剪辑。
- 多语言内容处理:去除原有硬字幕后重新添加目标语言字幕。
- 图片水印清理:项目同样支持静态图片的文本水印去除。
需要强调的是,去除字幕与水印涉及内容版权与使用授权问题。工具本身是中性的,但使用者应确保对素材拥有合法的处理权利,避免用于侵犯他人版权或规避正当署名。
值得关注的局限
从技术角度看,AI 修复的效果高度依赖字幕背景的复杂程度。当字幕位于纯色或简单背景上时,修复结果通常较为理想;而当字幕覆盖在人脸、复杂纹理或快速运动的画面上时,修复难度显著上升,可能出现模糊、拖影或不自然的填充区域。
此外,逐帧AI处理对硬件(尤其是 GPU)有一定要求,处理长视频时耗时和显存占用都不可忽视。这也是本地化方案相较云端服务的天然权衡:以本地算力换取隐私与自主性。
GPU 显存需求与处理速度之间存在直接关联。以常见的消费级显卡(如 8GB 显存的 RTX 3070 级别)为参考,处理 1080p 视频时,AI 修复模型的推理速度通常远低于实时,一分钟视频可能需要数分钟乃至更长时间完成处理。若仅有 CPU 可用,速度差距可达数十倍。因此在部署前,评估本机硬件配置与待处理素材的时长和分辨率,是制定合理期望的必要步骤。对于没有独立 GPU 的用户,可考虑在云端 GPU 实例(如 Colab、Autodl 等平台)上运行 VSR,既能保持开源自主性,也能获得足够的算力支撑。
小结
video-subtitle-remover 代表了一种务实的开源工具思路——将成熟的图像修复技术封装为面向具体需求的应用,并坚持本地化、无损分辨率的实现方式。对于经常需要处理硬字幕和水印的创作者而言,它提供了一个免费且注重隐私的选项。在实际使用中,理解其技术边界、合理评估复杂画面下的修复效果,并遵守版权规范,是发挥这类工具价值的前提。
相关推荐
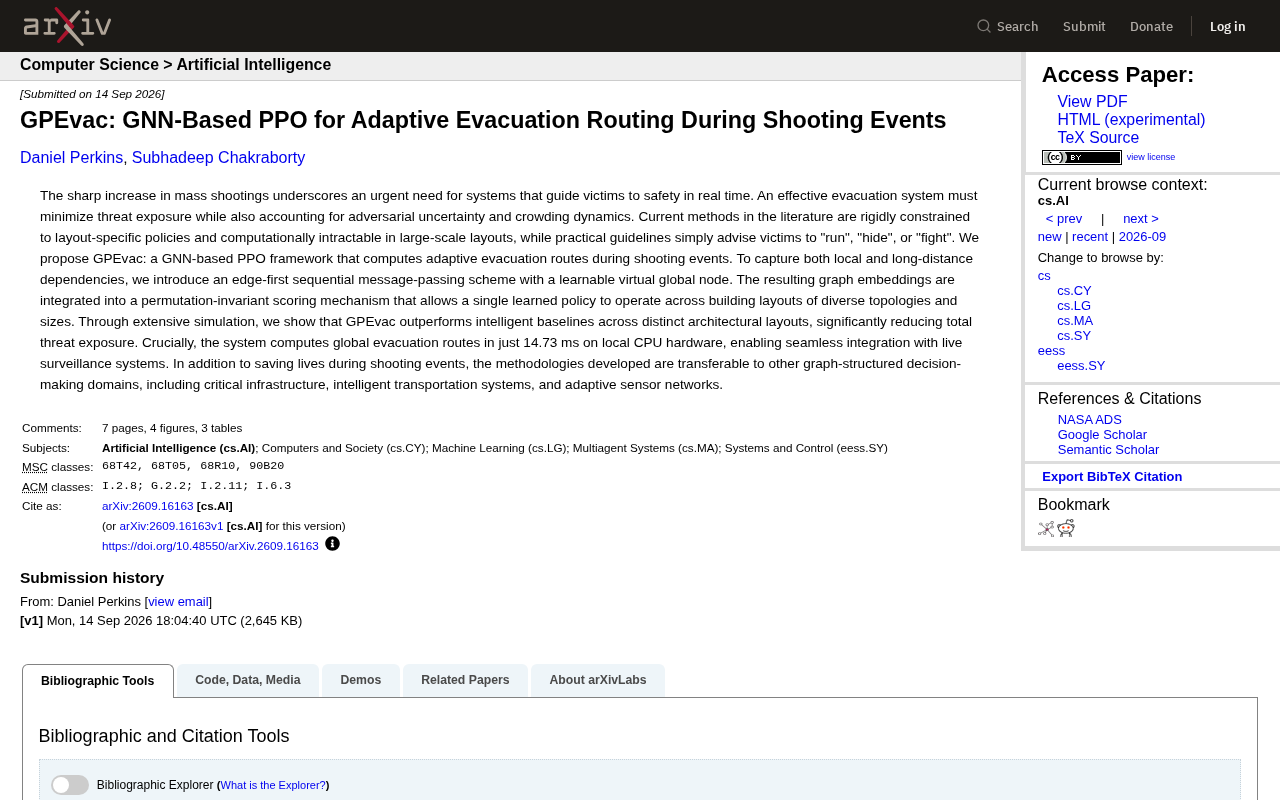
GPEvac:用GNN+PPO为枪击事件规划实时逃生路径
GPEvac 是一种结合图神经网络(GNN)与 PPO 强化学习的自适应疏散系统,能在枪击事件中实时计算逃生路径,本地 CPU 上仅需 14.73 毫秒,显著降低威胁暴露风险。
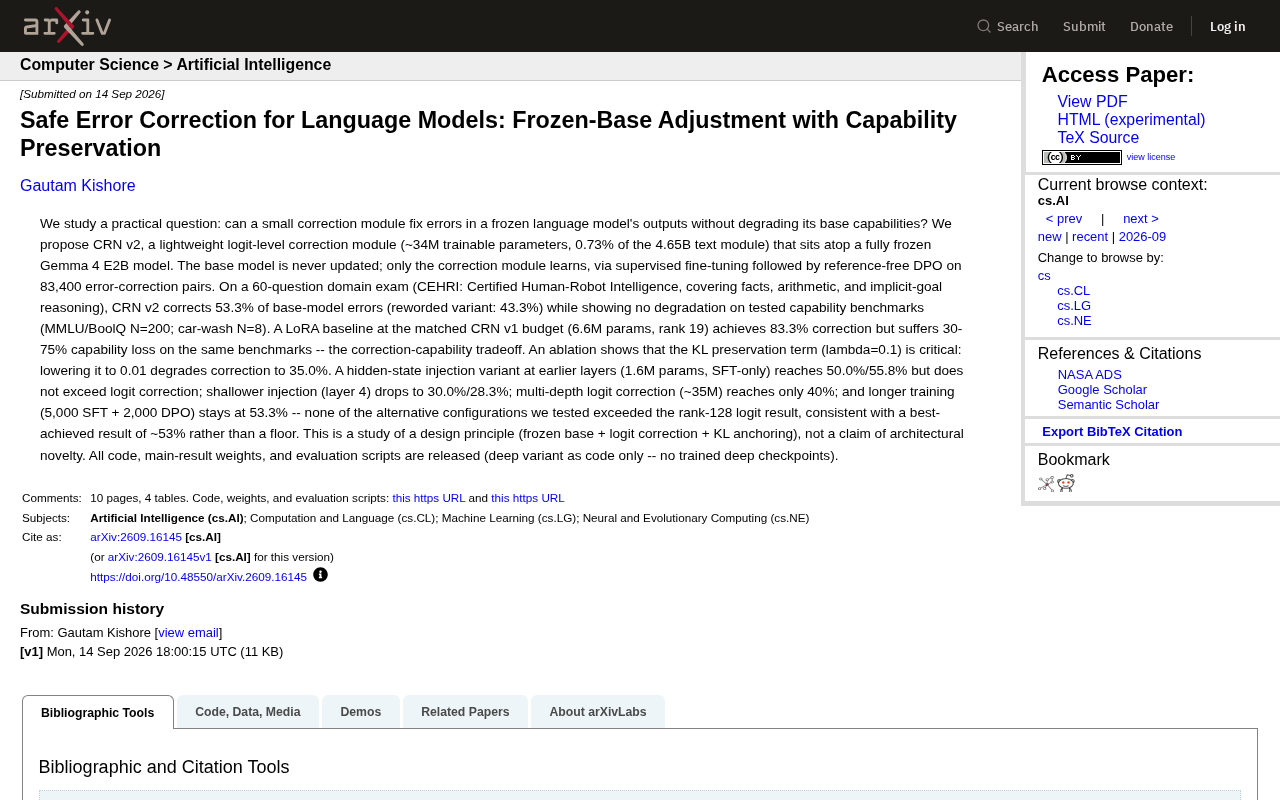
冻结基座+轻量校正:让语言模型改错不丢能力
arXiv 最新论文提出 CRN v2 轻量校正模块,在完全冻结的 Gemma 4 E2B 模型上仅用 3400 万参数纠正 53.3% 的错误,且零能力退化。本文解析其 logit 层校正、KL 锚定设计原则及与 LoRA 基线的取舍对比。
用Fisher信息距离实现神经网络最优剪枝:一种几何视角
arXiv新论文提出基于Fisher信息测地线距离的神经网络最优剪枝方法,将剪枝视为模型空间中的几何位移。该方法在全连接网络与视觉Transformer上全面超越幅值剪枝和局部Fisher基线,兼顾精度与计算效率。