Viso Now深度解析:自然语言构建计算机视觉应用的AI平台

Viso Now用自然语言零代码构建计算机视觉应用,大幅降低CV开发门槛
Viso Now是一款"自我构建的AI视觉平台",用户只需用自然语言描述需求,即可自动生成完整的计算机视觉应用和实时仪表盘,无需模型训练、数据标注和编码。它将Vibe Coding理念延伸至CV领域,底层依托多模态大模型能力,适用于零售分析、工业质检、安防管理等场景,但在识别准确率、实时推理成本和数据隐私方面仍面临落地挑战。
计算机视觉的开发门槛正在被重构
长期以来,构建一个能够真正投入使用的计算机视觉(CV)应用是一件门槛极高的工程任务。它意味着你需要收集海量数据、进行繁琐的图像标注、训练与调优深度学习模型,最后还要编写大量代码把整套推理逻辑接入到实际的摄像头或视频流中。这条链路不仅耗时,还需要跨越数据科学、机器学习工程和软件开发等多个专业领域。
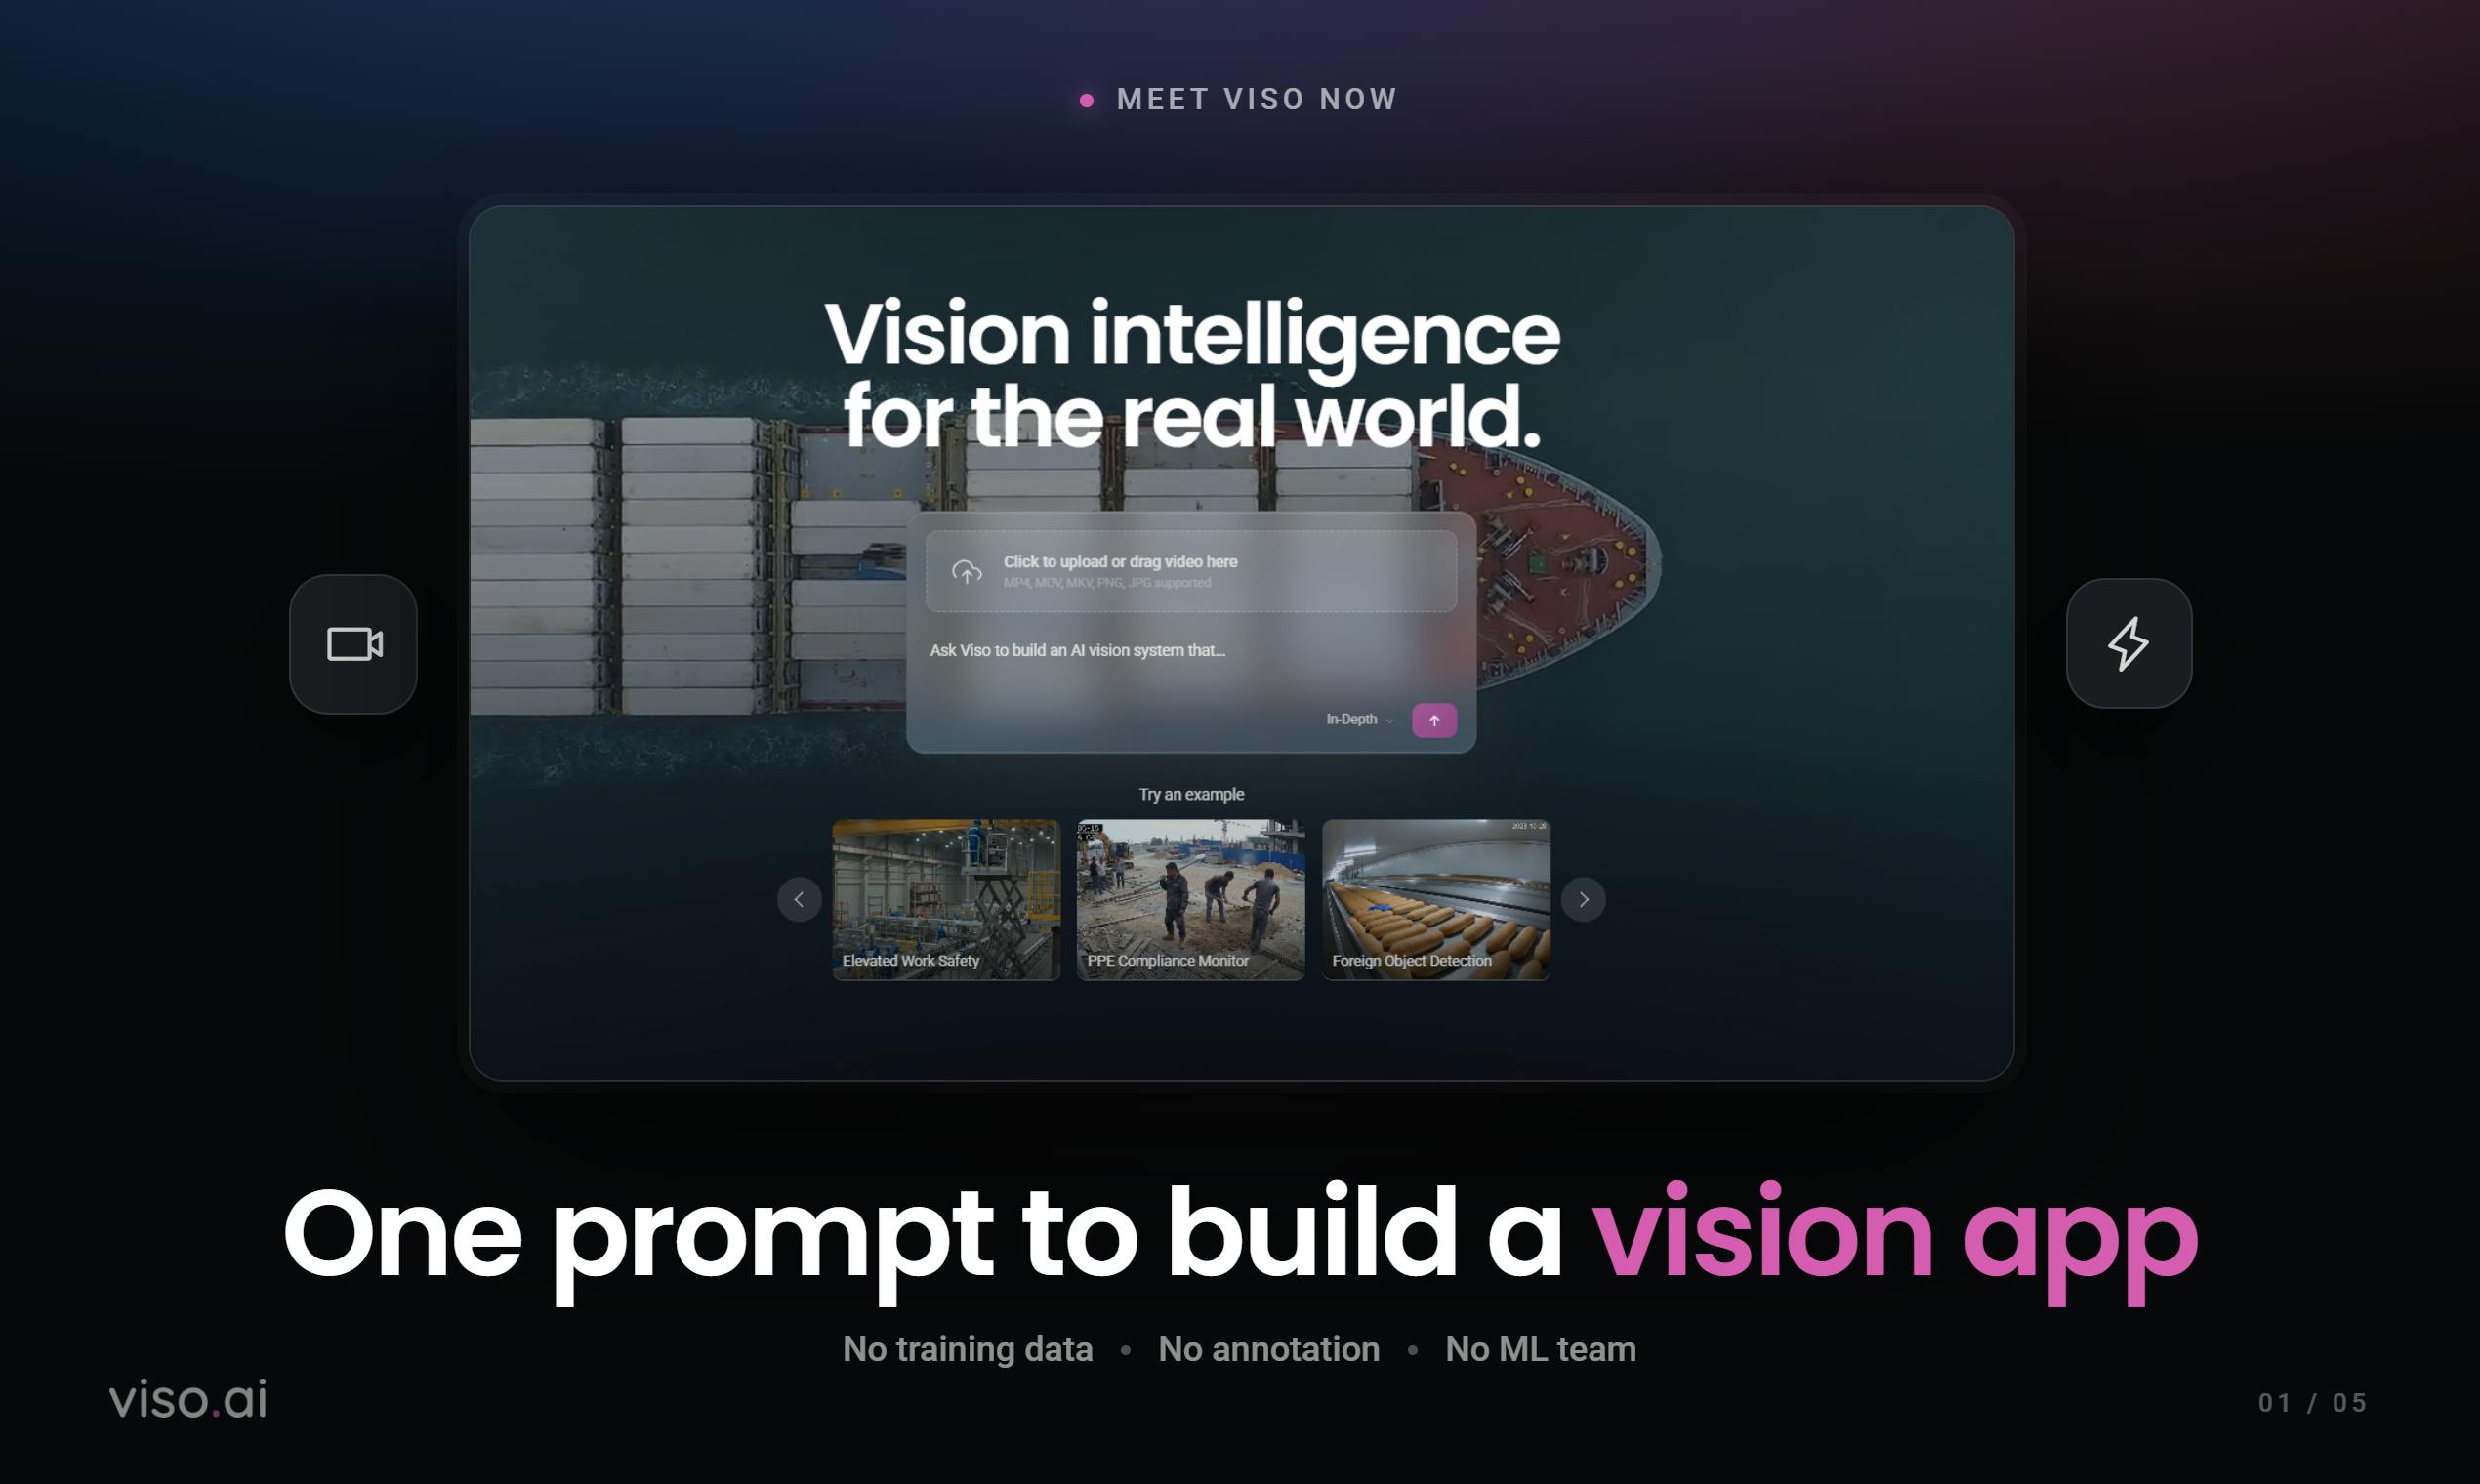
近日在 Product Hunt 上线的 Viso Now 试图彻底改变这一现状。它以"自我构建的 AI 视觉平台"(self-building AI vision platform)为定位,主张让用户只需用自然语言描述需求,平台便能自动生成完整的视觉应用逻辑与实时仪表盘——全程无需模型训练、无需数据标注、也无需编写代码。上线首日便获得了 84 个投票,位列当日榜单第 11 名。
Viso Now 的核心功能解析
从"描述意图"到"可运行的视觉应用"
Viso Now 的核心卖点可以浓缩为一句话:把图像、视频和摄像头画面转化为可工作的计算机视觉应用。用户要做的,仅仅是用自然语言描述自己想要理解或监测的内容,例如"统计进入店铺的人数"、"识别生产线上的缺陷产品"或"监控停车场空位"。
随后,Viso Now 会自动构建所谓的"agentic vision logic"(智能体式的视觉逻辑)——即由 AI 代理来编排检测、识别、计数、告警等一系列视觉任务的执行流程,并生成与之匹配的自定义实时数据看板。从需求表达到成品交付的整个过程,被压缩到了一个对话式的交互界面之中。
三个"零":Viso Now 的核心价值主张
- 零模型训练:传统 CV 项目中最耗算力和时间的模型训练环节被完全抹平;
- 零数据标注:绕开了动辄需要人工标注成千上万张图片的繁重工作;
- 零代码编写:非技术背景的业务人员也能直接上手搭建视觉应用。
这三点共同指向一个目标:让计算机视觉从少数专家的专属工具,变成任何有明确业务需求的人都能使用的通用能力。
技术趋势:Vibe Coding 如何延伸到计算机视觉领域
Viso Now 在 Product Hunt 上的分类标签颇具信号意义——除了常规的"人工智能"和"无代码(No-Code)"外,还带有一个新兴标签 Vibe Coding。
Vibe Coding 是近一年来兴起的开发理念,指开发者(乃至非开发者)通过与 AI 的自然语言协作来"感觉式"地构建软件,而不必逐行编写代码。此前这一模式主要出现在 Web 应用和后端逻辑的生成上,而 Viso Now 将其延伸到了计算机视觉这一原本高度依赖专业模型的领域。
这背后的技术底座,很可能是多模态大模型能力的成熟。当前的视觉-语言大模型(VLM)已经具备了开放词汇的目标检测、场景理解与推理能力,使得"无需为每个新任务单独训练模型"成为可能。平台只需将用户的自然语言意图解析为一组视觉理解任务,再由通用的多模态模型执行,即可覆盖大量长尾场景。
Viso Now 的潜在应用场景
凭借其低门槛特性,Viso Now 这类无代码计算机视觉工具的想象空间相当广阔:
- 零售与商业分析:客流统计、货架陈列监测、排队时长分析;
- 工业制造质检:产品缺陷检测、安全帽/防护装备合规检查、产线异常告警;
- 安防与运营管理:区域入侵检测、车辆识别、异常行为预警;
- 智慧城市建设:车流监控、停车位管理、公共空间人群密度分析。
对于中小企业和缺乏 AI 团队的组织而言,这类平台意味着无需雇佣昂贵的计算机视觉工程师,也能在数小时内搭建起一套定制化的视觉监测系统。
落地挑战:Viso Now 仍需验证的关键问题
尽管概念极具吸引力,但对于 Viso Now 这类"描述即得"的AI视觉平台,仍有几个关键问题值得在实际落地中检验。
识别准确率与可靠性
依赖通用多模态模型的开放识别,往往在标准场景下表现良好,但在光照复杂、目标遮挡、小目标密集或行业专有品类等场景下,精度可能不及专门训练的定制模型。对于工业质检、安防告警这类容错率低的场景,准确率至关重要。
实时推理性能与使用成本
视频流是持续不断的高频数据,若每帧都调用大模型推理,算力开销和延迟可能成为瓶颈。平台如何在"实时仪表盘"与"推理成本"之间取得平衡,是决定其商业可行性的核心问题。
数据隐私与合规性
摄像头画面往往涉及人脸、车牌等敏感信息,平台的数据处理方式、是否支持本地化部署,都会直接影响其在合规敏感行业中的适用性。
总结:自然语言驱动的计算机视觉时代加速到来
Viso Now 代表了 AI 应用开发范式向纵深演进的一个缩影:继网页、后端逻辑之后,连计算机视觉这样传统上高度专业化的领域,也开始被自然语言与智能体重新定义。它降低开发门槛的价值板上钉钉,尤其对广大缺乏 AI 能力的中小企业极具吸引力。
当然,从"惊艳的 Demo"到"可靠的生产系统"之间,仍隔着准确率、实时性与成本的多重考验。但可以确定的是,用一句话构建计算机视觉应用的时代,正在加速到来。
相关推荐

LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。