vLLM 集成 Chord 内核:Kimi K2.x 推理加速最高 2.15 倍
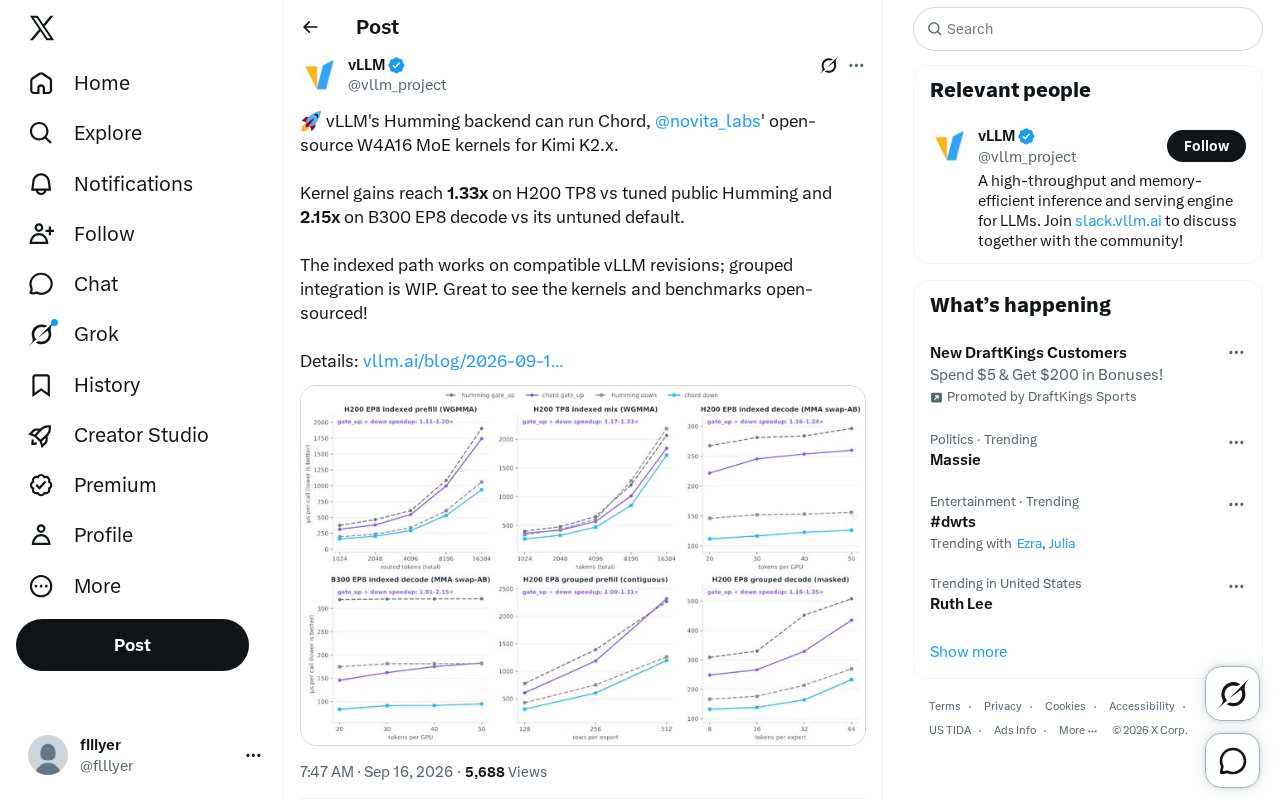
vLLM Humming 后端集成 Novita Labs 开源的 Chord W4A16 MoE 内核,在 H200/B300 上为 Kimi K2.x 推理带来最高 2.15 倍加速。
Novita Labs 开源的 Chord 内核是一套专为 Kimi K2.x 系列大规模 MoE 模型设计的 W4A16 量化推理内核,现已被整合进 vLLM 的 Humming 后端。基准测试显示,在 H200 TP8 配置下相较已调优的公开 Humming 版本实现 1.33 倍内核加速,在 B300 EP8 解码场景下相较默认实现加速达 2.15 倍。目前 indexed 路径已在兼容版本的 vLLM 上可用,grouped 集成仍在开发中。内核与基准数据均已开源,为社区提供了「W4A16 量化 + 专家并行」这一技术组合的可复现工程范本,有助于降低超大规模 MoE 模型的部署成本并推动生态适配。
vLLM 新增 Chord 内核支持
vLLM 的 Humming 后端现已能够运行 Chord —— 由 Novita Labs 开源的一套 W4A16 MoE 内核,专门针对 Kimi K2.x 系列模型进行了优化。这一进展让开源社区在大规模 MoE(混合专家)模型的高效推理上又迈出了实质性一步。
对于运行 Kimi K2.x 这类超大规模 MoE 模型的团队而言,推理成本与吞吐效率始终是核心瓶颈。Chord 提供的 W4A16 量化内核(权重 4-bit、激活 16-bit)在保持精度的同时,显著压缩了显存占用并提升了计算效率,而它被整合进 vLLM 主流推理栈,意味着更多用户可以直接受益。
W4A16 量化是一种混合精度量化策略:模型权重(Weight)以 4-bit 整数存储,而推理时的激活值(Activation)保留 16-bit 浮点精度。这种非对称设计的逻辑在于,权重在加载后是静态的,可以承受更激进的压缩;而激活值在前向传播中动态变化,保持较高精度有助于减少累积误差。相比全 FP16 推理,W4A16 能将模型显存占用降低约 50%–60%,同时在现代 GPU 上借助专用 CUDA 内核实现接近 FP16 的计算吞吐。**MoE(Mixture of Experts,混合专家)**架构则是另一个关键背景:MoE 模型由大量「专家」子网络组成,每次推理仅激活其中少数几个,参数总量庞大但计算量相对可控。Kimi K2.x 正是采用这一架构的超大规模模型。将 W4A16 量化应用于 MoE 模型的难点在于,专家路由的稀疏性与量化内核的访存模式需要协同优化,这也是 Chord 专项攻克的核心问题。
内核性能:H200 与 B300 上的实测增益
从公布的基准数据看,Chord 内核的加速幅度相当可观。在 H200 TP8(8 路张量并行) 配置下,相较于经过调优的公开 Humming 版本,Chord 实现了 1.33 倍 的内核性能提升。
更值得关注的是在 B300 EP8(8 路专家并行)解码 场景下,相较于未调优的默认实现,加速比达到了 2.15 倍。这一数字说明,在专家并行的解码路径上,优化后的 MoE 内核能够释放出更大的性能空间——而解码延迟恰恰是交互式推理与在线服务最敏感的指标之一。
需要注意基准的对照口径:H200 上的对比对象是「已调优的公开 Humming」,而 B300 上则是「未调优的默认实现」。因此 2.15 倍的增益部分来自 Chord 本身的优化,部分反映了默认配置的调优空间,解读时应结合具体场景。
张量并行(Tensor Parallelism,TP) 与专家并行(Expert Parallelism,EP) 是 MoE 模型分布式推理中的两种主要并行策略,二者的优化重心有所不同。张量并行将单个矩阵运算切分到多张 GPU 上同步执行,适合缩短单次计算的延迟,但通信开销较高。专家并行则将不同专家子网络分配到不同设备,每张 GPU 只承载部分专家,Token 根据路由结果在设备间传递——这种方式在解码阶段尤为重要,因为解码逐 token 生成,批量规模小,专家并行能更有效地利用多卡资源。B300 EP8 解码场景下 2.15 倍的加速,正是在专家并行这条路径上取得的,反映出 Chord 在处理稀疏专家激活与跨设备通信时的针对性优化效果。
集成现状:indexed 路径可用,grouped 仍在开发
就目前的落地情况而言,indexed 路径已经可以在兼容的 vLLM 版本上运行,用户在对应的 vLLM revision 上即可启用这条路径。而 grouped 集成仍处于开发中(WIP),尚未完全就绪。
这种分阶段推进的方式在开源推理框架的迭代中很常见:先交付验证充分、兼容性明确的路径,再逐步补齐更复杂的集成形态。对希望立即尝鲜的用户来说,确认自己使用的 vLLM 版本是否在兼容列表内,是第一步。
在 MoE 推理内核中,indexed 与 grouped 是两种不同的专家计算组织方式。Indexed 路径按照路由结果逐专家索引并计算,实现相对直接,适合验证正确性与基础性能;Grouped 路径则将分配到同一专家的多个 Token 聚合成批次统一处理,能够更充分地利用 GPU 的批量矩阵运算能力,在高并发场景下通常有更好的吞吐表现,但实现复杂度更高,需要处理动态批次大小与内存对齐等问题。当前 indexed 路径先行落地,grouped 路径仍在开发,符合「先跑通、再提效」的工程节奏。
开源的意义
Chord 内核与配套基准的开源,是这次进展中同样重要的一环。W4A16 MoE 内核的实现细节往往涉及大量硬件相关的底层优化,将这些内核与可复现的 benchmark 一并开放,能够帮助社区验证性能声明、复用优化经验,并加速在不同硬件与模型上的适配。
对 Kimi K2.x 用户而言,这意味着可以在 H200、B300 等主流加速卡上,以更低成本部署高效的量化推理服务;对更广泛的 MoE 生态而言,Novita Labs 的这次开源为「量化 + 专家并行」这一技术组合提供了一个可参考的工程范本。
更多技术细节可参考官方发布的说明文档。
相关推荐
Agent蔓延的隐患:一切看似正常才最危险
Agent蔓延(Agent Sprawl)是AI智能体时代的新隐患——AI Agent无序增长却表面正常,暗藏安全、成本与运维风险。本文解析为何"看似正常"最危险及应对之道。
当AI安全变成"性爱邪教":一场关于社群文化的争议
Hacker News上一个挑衅性标题"AI安全大多是性爱邪教"引发讨论。本文梳理AI安全社群、有效利他主义与理性主义圈子的文化争议,理性分析批评与反驳,探讨技术议题与社群文化该如何区分看待。
低价淘到二手硬件该留还是拆?一次采购决策的思考
一位 Reddit 用户花 500 美元买下 4 台满配二手设备后陷入纠结:该拆件转卖还是长期自用?本文从沉没成本、二手残值、太阳能供电等角度分析硬件采购决策。