vLLM v0.29.0rc3发布:高性能LLM推理引擎最新动态

vLLM v0.29.0rc3发布,功能趋于冻结,主要进行CI维护与失效测试清理,正式版即将到来。
vLLM 是当前最主流的开源大语言模型推理框架,以 PagedAttention 机制为核心技术优势,大幅提升显存利用率与并发吞吐能力。近日发布的 v0.29.0rc3 是正式版前的第三个候选版本,标志着新版本功能已基本冻结,团队进入稳定性验证阶段。本次 rc3 的主要改动集中在 CI 层面——移除了因上游 NVIDIA Nemotron 模型下架而失效的测试项,体现了团队对工程质量的细致打磨。对于生产环境用户,RC 版本适合在测试环境中提前验证兼容性;对于社区开发者,这是体验新特性的最佳时机。随着正式版临近,vLLM 在分布式推理、量化支持等方向的持续演进值得重点关注。
vLLM v0.29.0rc3 发布概览
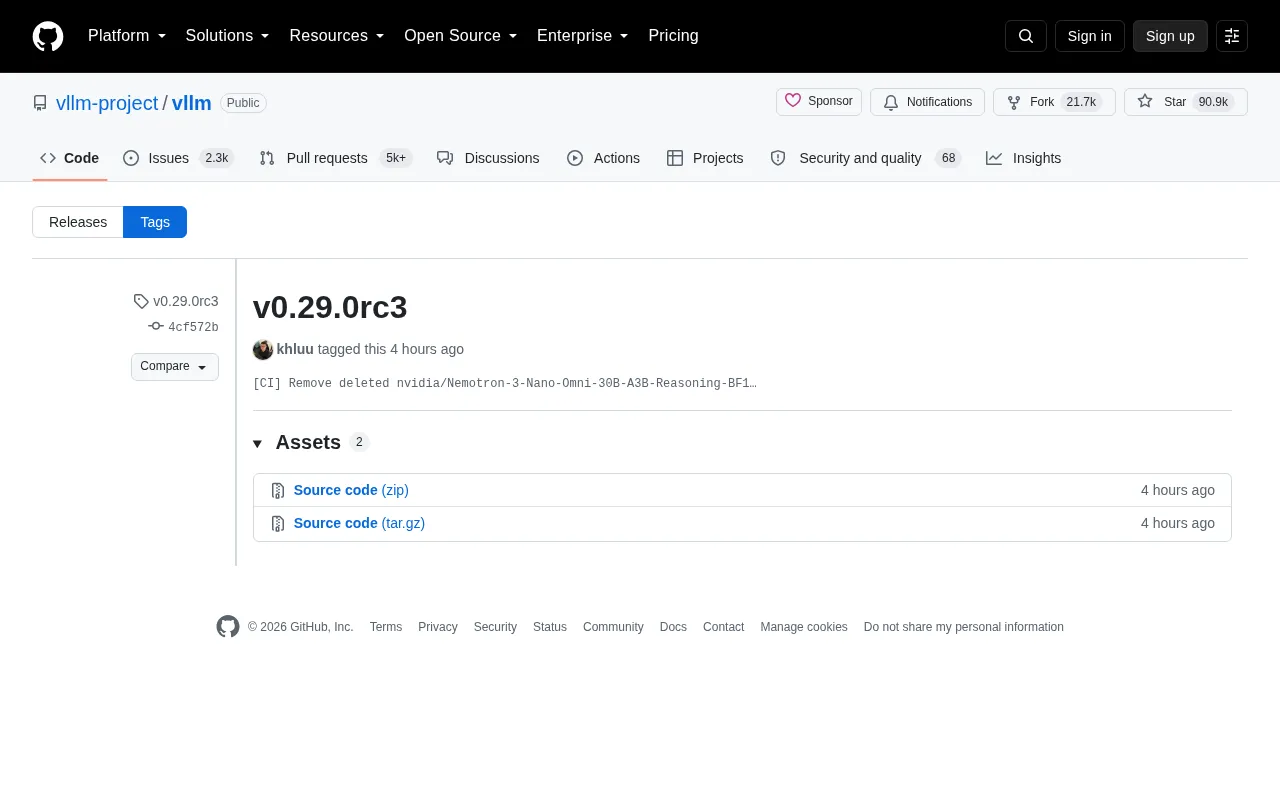
vLLM 作为当下最受欢迎的大语言模型推理与服务框架之一,近日发布了 v0.29.0rc3 版本(Release Candidate 3,即候选发布版)。该版本由核心维护者 khluu 于9月4日打标签发布,是 v0.29.0 正式版本前的重要预览迭代。
作为一个在 GitHub 上已收获超过 9万 Star、被 Fork 超过 2.17万次 的明星开源项目,vLLM 每一次版本更新都牵动着整个 AI 基础设施社区的关注。rc3 版本的推出,标志着 v0.29.0 正式版即将到来,也意味着新版本的核心特性已趋于稳定。
为什么 vLLM 如此重要
对于不熟悉这个项目的读者,有必要先了解 vLLM 的定位。vLLM 是一个专注于高吞吐、低延迟大语言模型推理的开源引擎,其最核心的技术创新是 PagedAttention 机制——借鉴操作系统虚拟内存分页的思想,高效管理注意力计算中的 KV Cache,从而大幅降低显存碎片、提升并发处理能力。
凭借这一核心优势,vLLM 已成为众多企业与研究机构部署 LLM 推理服务的首选方案。无论是自建推理服务,还是作为在线 API 的后端引擎,vLLM 都提供了接近生产级的性能表现,同时保持与 OpenAI 兼容的 API 接口,极大降低了迁移成本。
候选发布版(RC)意味着什么
此次的 rc3 属于候选发布版本。在软件工程实践中,RC 版本意味着功能已经冻结,团队主要进行最后的稳定性验证与 Bug 修复。对于追求稳定的生产环境用户,可以借此机会提前在测试环境中验证兼容性;而对于社区贡献者与尝鲜者,这是体验新特性的最佳时机。
PagedAttention 是 vLLM 的核心技术突破,由加州大学伯克利分校团队于2023年提出。传统 LLM 推理中,每个请求的 KV Cache(键值缓存)需要预先分配一块连续的显存空间,但由于序列长度不可预知,这往往导致大量显存碎片与浪费——实测中高达60%~80%的显存可能被低效占用。PagedAttention 借鉴操作系统管理内存的「分页」思想,将 KV Cache 切分为固定大小的「块」(Block),按需动态分配,不同请求的块可以非连续存放,显存利用率因此大幅提升。这一机制还天然支持多个请求共享相同前缀的 KV Cache(Prefix Caching),在系统提示词(System Prompt)较长的场景下能显著减少重复计算,进一步提升吞吐量。
本次发布的关键调整
从发布记录来看,rc3 版本包含了持续集成(CI)方面的维护性调整。其中一个明确的改动是移除了已被删除的 nvidia/Nemotron-3-Nano-Omni-30B-A3B-Reasoning 相关测试项。
这一细节虽然不大,却体现了 vLLM 团队对模型生态变化的敏捷响应。随着上游模型仓库(如 NVIDIA 的 Nemotron 系列)的调整,vLLM 需要同步更新 CI 流水线,确保测试的准确性与构建的稳定性。这种对细节的持续打磨,正是一个成熟开源项目工程质量的体现。
RC 版本的迭代节奏
从 rc1 到 rc3 的快速迭代,说明团队在正式发布前进行了密集的测试与修复工作。这种谨慎的发布策略有助于避免正式版本出现重大问题,也为下游依赖 vLLM 的项目提供了更可靠的升级路径。
持续集成(CI,Continuous Integration) 是现代软件工程中的重要实践:每次代码提交后,自动触发构建、测试流水线,快速发现引入的问题。对于 vLLM 这类需要支持数十乃至上百种模型、多种硬件后端(NVIDIA GPU、AMD GPU、CPU 等)的复杂项目,CI 流水线的维护成本极高。Nemotron 相关测试项的移除,是因为上游模型权重或配置已从 Hugging Face Hub 下架,继续保留该测试会导致 CI 流水线因拉取不到模型而持续报错,影响其他无关功能的正常验证。及时清理失效测试,是保持 CI 「绿灯率」、维护工程可信度的必要工作。
如何获取与安装 vLLM rc3
对于希望尝鲜的开发者,可以通过 GitHub 的 Releases 页面获取该候选版本的构建产物(Assets)。需要注意的是,RC 版本通常不建议直接用于关键生产环境,更适合在隔离的测试环境中验证功能与性能。
典型的安装方式仍然是通过 pip 指定预发布版本进行安装,或从源码构建。升级前建议仔细阅读完整的更新日志,确认与现有部署栈的兼容性,尤其是在多 GPU 分布式推理、量化模型加载等复杂场景下。
结语:大模型推理引擎的持续进化
vLLM v0.29.0rc3 的发布,虽然表面上是一次常规的候选版本迭代,但它折射出整个大模型推理基础设施领域的高速演进。在大模型应用日益普及的当下,推理效率直接关系到服务成本与用户体验,而 vLLM 正处于这一赛道的核心位置。
随着 v0.29.0 正式版的临近,我们有理由期待更多性能优化、更广泛的模型支持以及更完善的分布式推理能力。对于任何关注 AI 工程落地的团队来说,持续跟踪 vLLM 的版本演进,都将是一项值得投入的工作。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。