vLLM v0.30.0 发布:混合注意力与推测解码全面升级

vLLM v0.30.0发布,多项优化聚焦混合注意力、分层缓存与推测解码,大幅提升推理效率。
vLLM v0.30.0 是一次覆盖面广、工程深度扎实的版本更新,762次提交与315位贡献者共同构成其技术厚度。核心性能改进集中在三条主线:针对多款主流模型的混合注意力热点路径优化,通过算子融合与稀疏GQA降低显存与延迟;HiSparse分层稀疏缓存在GPU显存吃紧时仅按需回填top-k数据,降低硬件门槛;Model Runner V2将EAGLE3风格草稿生成与自适应验证引入流水线并行,让推测解码的加速红利惠及大规模分布式部署。功能层面则新增双密钥Gumbel-max水印、基于CUDA IPC的Fast Start快速启动,以及对GLM-5.3-Flash等多款新模型的支持,进一步完善了生产级部署所需的工程化能力。
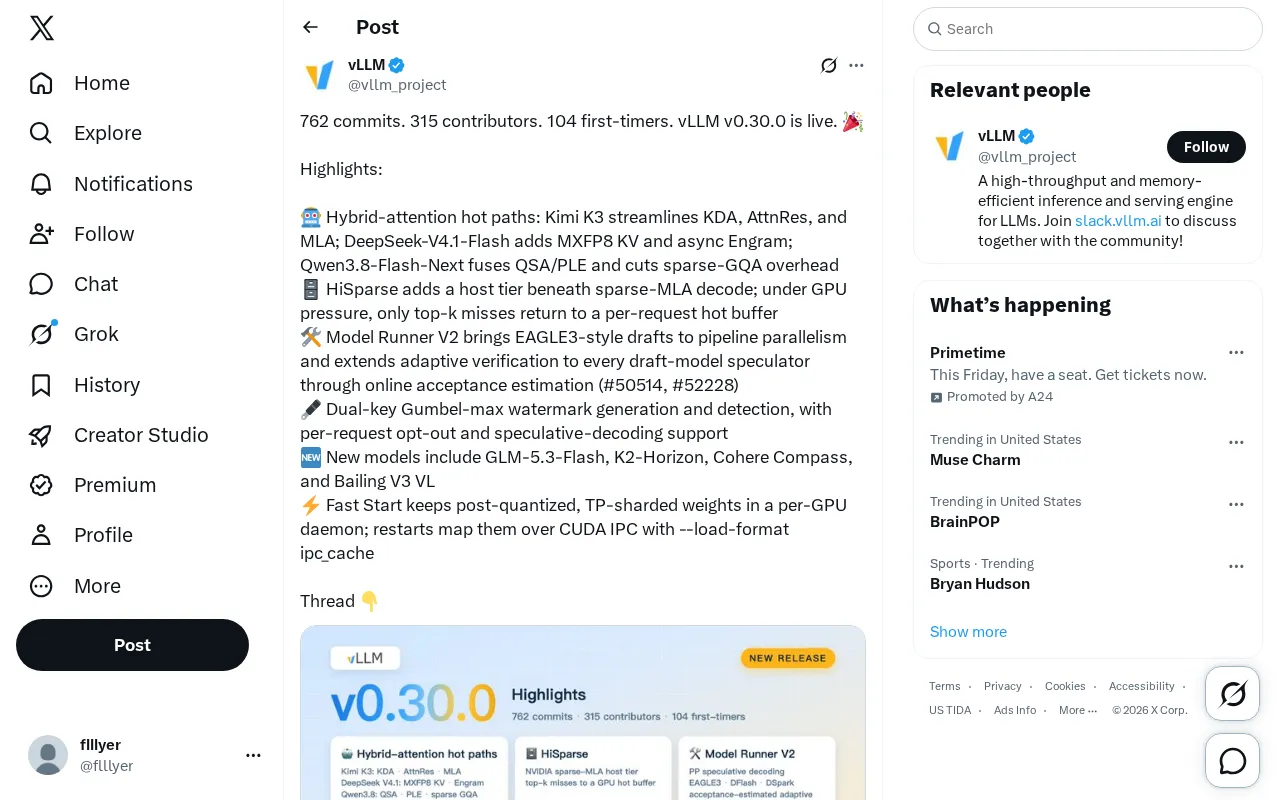
开源大模型推理引擎 vLLM 迎来 v0.30.0 版本。据官方在 Twitter 上公布的发布信息,本次更新累计 762 次提交、315 位贡献者参与,其中包含 104 位首次贡献者。这一系列数字背后,是 vLLM 社区持续扩张的活跃度,也反映出该项目在大模型推理领域的核心地位。
混合注意力的热点路径优化
本次版本的一大重心是围绕「混合注意力」(Hybrid-attention)热点路径的深度优化,针对多款主流模型进行了专门适配。
根据发布说明,vLLM 为不同模型引入了差异化的加速策略:一是简化了 KDA、AttnRes 与 MLA 相关的执行流程;二是为部分模型加入 MXFP8 KV 缓存与异步 Engram 机制;三是将 QSA/PLE 进行算子融合,并削减稀疏 GQA(分组查询注意力)的额外开销。
这些改动的共同目标,是在保证精度的前提下降低注意力计算与 KV 缓存的显存与延迟成本。对于长上下文和高并发场景,混合注意力路径的优化往往能带来可观的吞吐提升,这也是当前推理引擎竞争的关键战场。
HiSparse 分层稀疏解码
显存压力始终是大模型推理绕不开的难题。v0.30.0 引入的 HiSparse 在稀疏 MLA 解码之下增加了一层「主机层」(host tier),构建出更精细的分层缓存结构。
其工作机制颇具巧思:在 GPU 显存吃紧时,系统仅将命中 top-k 的缺失数据回填到每个请求的热缓冲区(hot buffer),而非无差别地占用宝贵的显存资源。这种按需回填的设计,本质上是在 GPU 显存与主机内存之间做动态权衡,让有限的显存服务于最关键的解码路径。
对于部署资源受限的团队而言,这类分层机制意味着可以用更低的硬件成本承载更大的模型或更高的并发量。
Model Runner V2 与推测解码增强
推测解码(Speculative Decoding)是本次更新的另一亮点。全新的 Model Runner V2 将 EAGLE3 风格的草稿生成引入流水线并行(pipeline parallelism),并通过在线接受率估计(online acceptance estimation),把自适应验证扩展到每一个草稿模型推测器(对应 PR #50514、#52228)。
简单来说,推测解码通过让小模型「预写」候选 token、再由大模型批量验证,从而加速生成。而 vLLM 此次的改进在于让验证过程更加自适应——系统能根据实时的接受率动态调整验证策略,减少无效计算。将这一能力扩展到流水线并行,也意味着大规模分布式部署同样能享受推测解码的加速红利。
推测解码的核心思路是利用「小模型猜、大模型验」的不对称成本来提速:一个轻量级草稿模型(draft model)连续生成若干候选 token,主模型只需一次前向传播便可并行验证全部候选,接受符合分布的 token 并从第一个被拒绝处重新生成。只要接受率足够高,单位时间内输出的有效 token 数就会大幅超过纯自回归方式。EAGLE(Extrapolation Algorithm for Greater Language-model Efficiency)是一类基于特征层预测的草稿方法,EAGLE3 是其最新迭代,通过更精准的隐层特征复用进一步提升草稿质量。在线接受率估计则让系统无需人工调参,就能根据当前请求流的实际情况动态决定每步推测多少个 token,从而在不同负载下都保持近似最优的加速比。
水印、快速启动与新模型支持
除性能优化外,v0.30.0 在功能层面也有多项值得关注的补充。
内容水印:新增双密钥 Gumbel-max 水印的生成与检测能力,支持按请求维度选择退出(opt-out),并兼容推测解码。这一功能顺应了大模型内容可追溯与合规的行业趋势。
Fast Start 快速启动:将量化后、经张量并行(TP)分片的权重保存在每 GPU 的常驻守护进程中,重启时通过 CUDA IPC 直接映射,使用 --load-format ipc_cache 即可启用。这对频繁重启服务、追求高可用的生产环境非常实用,能显著缩短冷启动时间。
新模型支持:本版本新增了对 GLM-5.3-Flash、K2-Horizon、Cohere Compass 与 Bailing V3 VL 等多款模型的支持,进一步扩大了 vLLM 的模型生态覆盖。
双密钥 Gumbel-max 水印是一种基于随机数种子的统计水印方案:生成每个 token 时,用密钥对词表进行随机排列,使被水印文本在统计上偏向特定 token,而普通读者无法察觉。「双密钥」设计将生成密钥与检测密钥分离,机构可公开检测能力,同时保护生成端的私钥不被伪造,兼顾可审计性与安全性。支持「按请求 opt-out」意味着特定场景(如代码补全、高创意写作)可豁免水印,避免对输出质量造成干扰。Fast Start 利用 CUDA IPC(进程间通信)将已量化并完成张量并行分片的权重常驻于守护进程内存,重启时直接映射而无需重新加载和切分,可将冷启动时间从分钟级压缩到秒级,对滚动升级或故障快速恢复的生产环境意义显著。
小结
vLLM v0.30.0 延续了该项目一贯的高频迭代节奏,从混合注意力优化、分层稀疏缓存到推测解码增强,几乎每一项改动都指向同一个目标:在有限硬件上榨取更高的推理效率。配合水印、快速启动等工程化能力与不断扩充的模型支持,vLLM 正持续巩固其作为主流开源推理引擎的地位。对于关注大模型部署与推理优化的开发者,这一版本值得尽快评估升级。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。