vLLM v0.30.0 发布:修复 DeepGEMM CUDA 12.9 构建问题

vLLM v0.30.0 修复了 DeepGEMM 在 CUDA 12.9 下的构建失败问题,CUDA 12.9 用户建议升级。
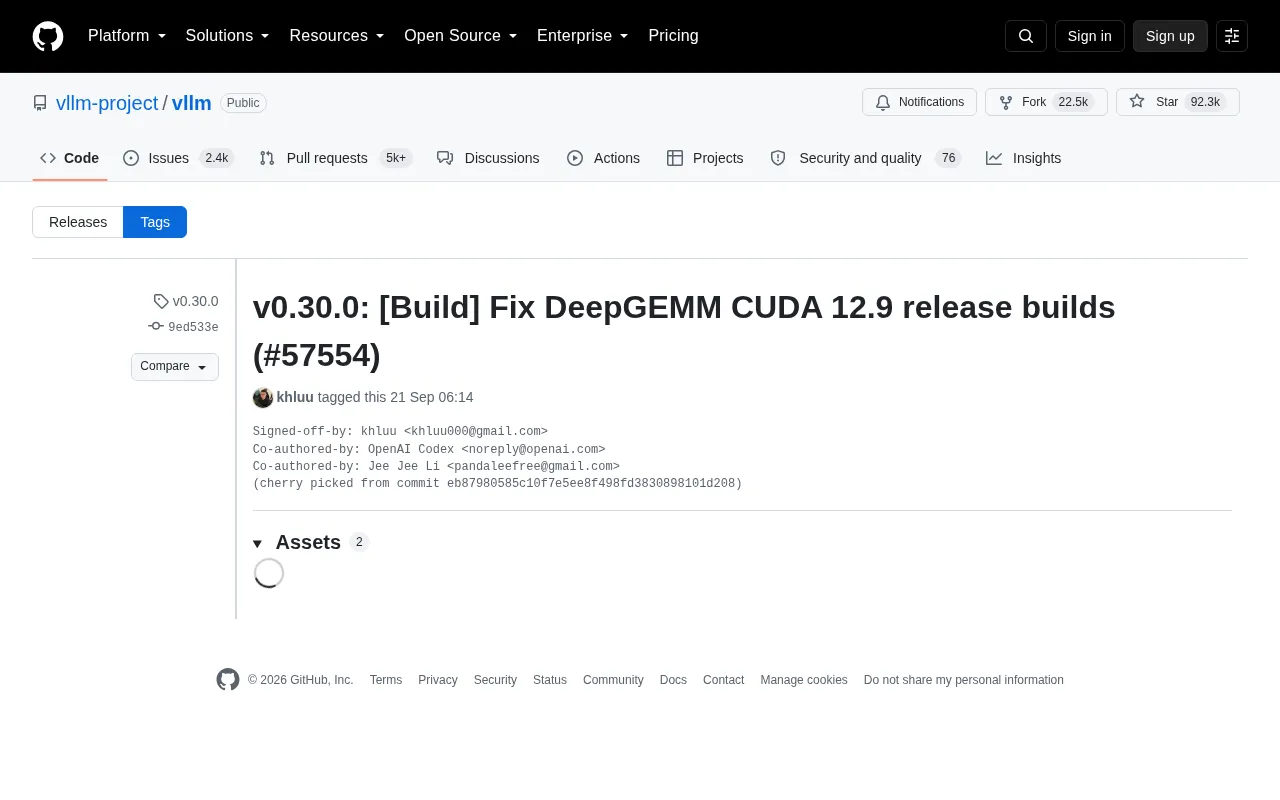
vLLM 发布 v0.30.0 版本,这是一次以稳定性为核心的维护性更新,主要修复了 DeepGEMM 组件在 CUDA 12.9 环境下的发布构建失败问题(PR #57554)。DeepGEMM 是专为大语言模型推理加速设计的高性能矩阵乘法库,CUDA 工具链升级至 12.9 后出现兼容性断层,导致官方二进制包无法正常构建。对于使用最新 CUDA 版本的部署团队而言,这一问题会阻断使用官方包的路径,修复意义直接而实际。此次修复通过 cherry-pick 方式快速合入发布分支,体现了项目维护的高效响应。使用 CUDA 12.9 环境的用户建议直接升级,旧版 CUDA 用户升级也无破坏性风险。
vLLM 项目发布了 v0.30.0 版本,本次更新的核心是修复了 DeepGEMM 在 CUDA 12.9 环境下的发布构建(release build)问题(PR #57554)。对于依赖 vLLM 进行大模型推理部署的开发者而言,这是一次值得关注的稳定性修复。
版本要点
此次 v0.30.0 的关键改动集中在构建层面。根据发布说明,问题定位为 DeepGEMM 组件在 CUDA 12.9 版本下的发布构建失败,修复由贡献者 khluu 主导提交,并有 OpenAI Codex 与 Jee Jee Li 参与协作。该修复通过 cherry-pick 方式从主线提交(commit eb879805)合并至发布分支。
DeepGEMM 是面向 GPU 的高性能矩阵乘法(GEMM)实现,通常被用于加速大语言模型推理中的核心计算。当 CUDA 工具链升级到 12.9 后,构建流程出现兼容性问题,会直接导致官方发布的二进制包在新版 CUDA 环境下无法正常编译或运行。
GEMM(General Matrix Multiplication,通用矩阵乘法)是深度学习推理中最核心的计算原语之一。大语言模型的线性层(Linear Layer)、注意力机制中的 QK^T 计算,本质上都可归结为矩阵乘法。DeepGEMM 是由 DeepSeek广告 团队开源的专为 FP8 精度优化的 GEMM 内核库,专门针对 NVIDIA Hopper 架构(H100/H800)的 Tensor Core 进行了深度调优,能够在保持计算精度的同时显著提升吞吐量。vLLM 集成 DeepGEMM 后,可在支持的硬件上自动选用该内核以替代 cuBLAS 等通用实现,从而降低推理延迟。由于 DeepGEMM 与底层 CUDA PTX 指令和编译工具链深度绑定,CUDA 版本变更时出现构建兼容性问题并不罕见。
为什么这次修复重要
vLLM 作为当前最受欢迎的开源大模型推理引擎之一,在 GitHub 上已获得超过 9.2 万颗 Star、2.25 万次 Fork,是生产环境中广泛采用的推理框架。构建层面的问题看似琐碎,但对实际部署影响巨大——如果发布版本在特定 CUDA 版本下无法构建,使用该 CUDA 环境的用户就无法获得可用的官方包。
CUDA 12.9 是较新的 NVIDIA 计算工具链版本,许多希望使用最新驱动与硬件特性的团队会采用该版本。此次修复确保了这部分用户能够顺利使用官方发布的 vLLM 版本,避免了自行打补丁或降级 CUDA 的额外成本。
cherry-pick 是 Git 版本控制中的一项操作,指将某个特定提交(commit)从一条分支单独摘取并应用到另一条分支,而不合并整个分支的历史。在大型开源项目中,主线(main/master)分支通常持续接收新功能和实验性改动,而发布分支(release branch)则保持相对稳定。当主线上出现关键 bug 修复时,维护者会通过 cherry-pick 将该修复精准地"移植"到发布分支,避免将尚未稳定的新功能一并带入正式版本。此次 vLLM 团队将 commit eb879805 cherry-pick 至 v0.30.0 发布分支,正是这种敏捷维护策略的体现——用户可在不等待下一个完整功能版本的情况下,尽快获得已验证的修复。
对使用者的建议
如果你正在 CUDA 12.9 环境下部署 vLLM,建议直接升级到 v0.30.0,以获得已修复的发布构建。对于仍在旧版 CUDA 环境(如 12.1、12.4)运行的用户,此次修复不会带来功能上的破坏性变化,但升级到最新稳定版本仍是保持依赖同步的良好实践。
值得提醒的是,从发布说明看,本次更新是一次以构建修复为主的维护性版本,并未提及大规模的新功能或推理性能改进。团队通过 cherry-pick 的方式将修复快速合入发布分支,也体现了 vLLM 项目在版本维护上的敏捷性。
小结
vLLM v0.30.0 是一次聚焦稳定性的发布,核心解决了 DeepGEMM 在 CUDA 12.9 下的构建失败问题。虽然改动范围有限,但对使用新版 CUDA 工具链的大模型部署团队来说,是一次必要且及时的修复。持续关注 vLLM 的版本迭代,有助于在推理框架的性能与兼容性之间保持最佳平衡。
相关推荐
“黑色十月”:AI挖出史上3%严重漏洞?
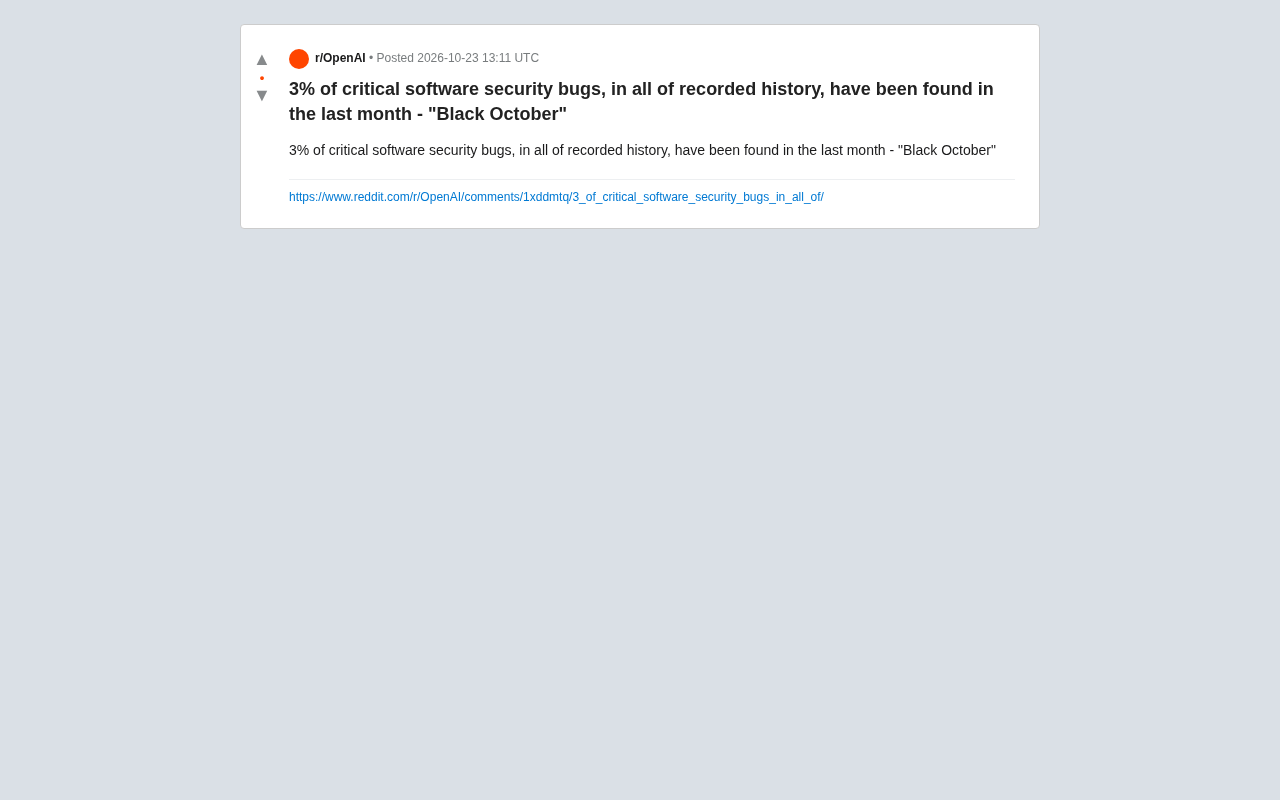
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。

微软Project Gecko:用AI为非洲农民架起语言桥梁
微软Project Gecko项目推出PharmaChat应用,让非洲农民用母语提问,通过AI返回精准视频片段和农耕书籍章节。项目还发布三个交互式手册,推动包容性AI发展。
Node.js语音笔记App:语音转文字API选型指南
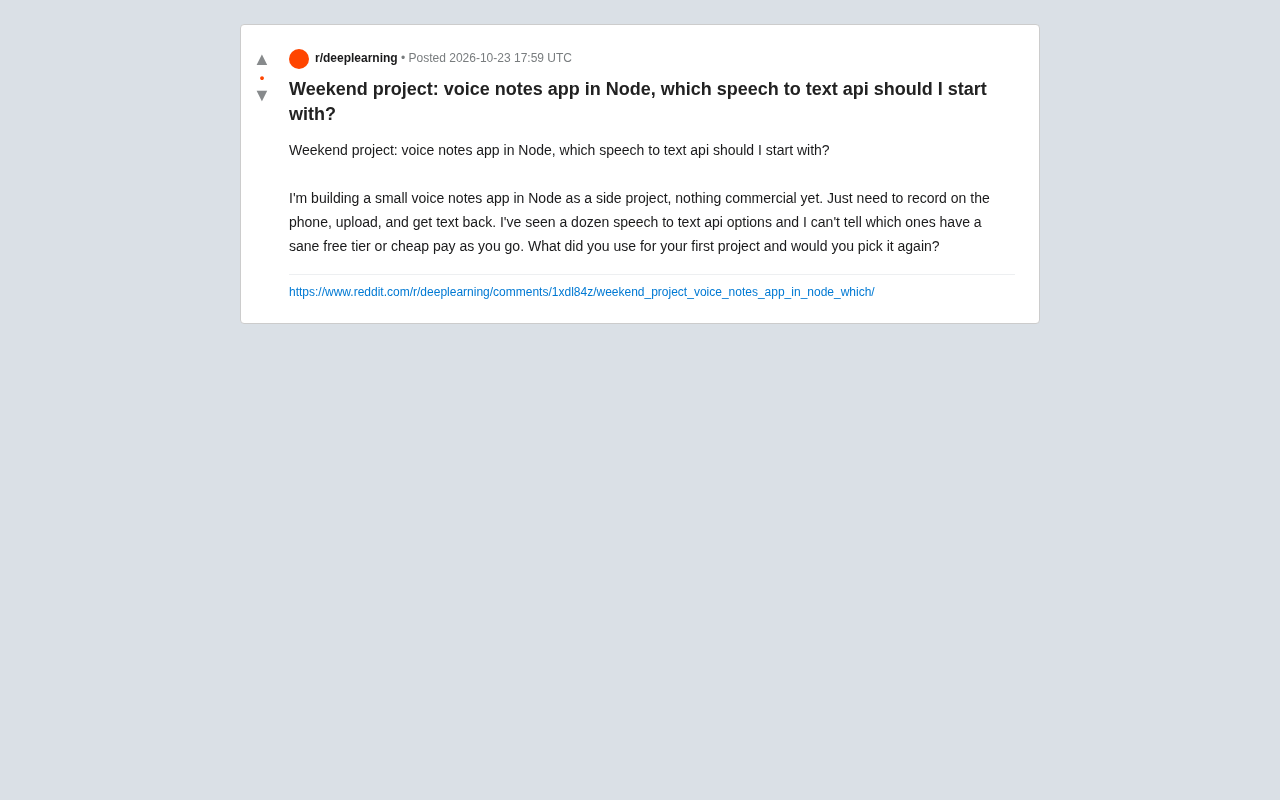
为Node.js语音笔记应用选择语音转文字API?对比AssemblyAI、Deepgram、Google Cloud和Whisper的免费额度、定价与Node集成体验,给出分阶段选型建议。