vLLM v0.31.0rc3发布:Model Runner V2引入随机化虚拟输入

vLLM v0.31.0rc3 为 Model Runner V2 引入随机化虚拟输入,提升显存估算与推理预热的准确性。
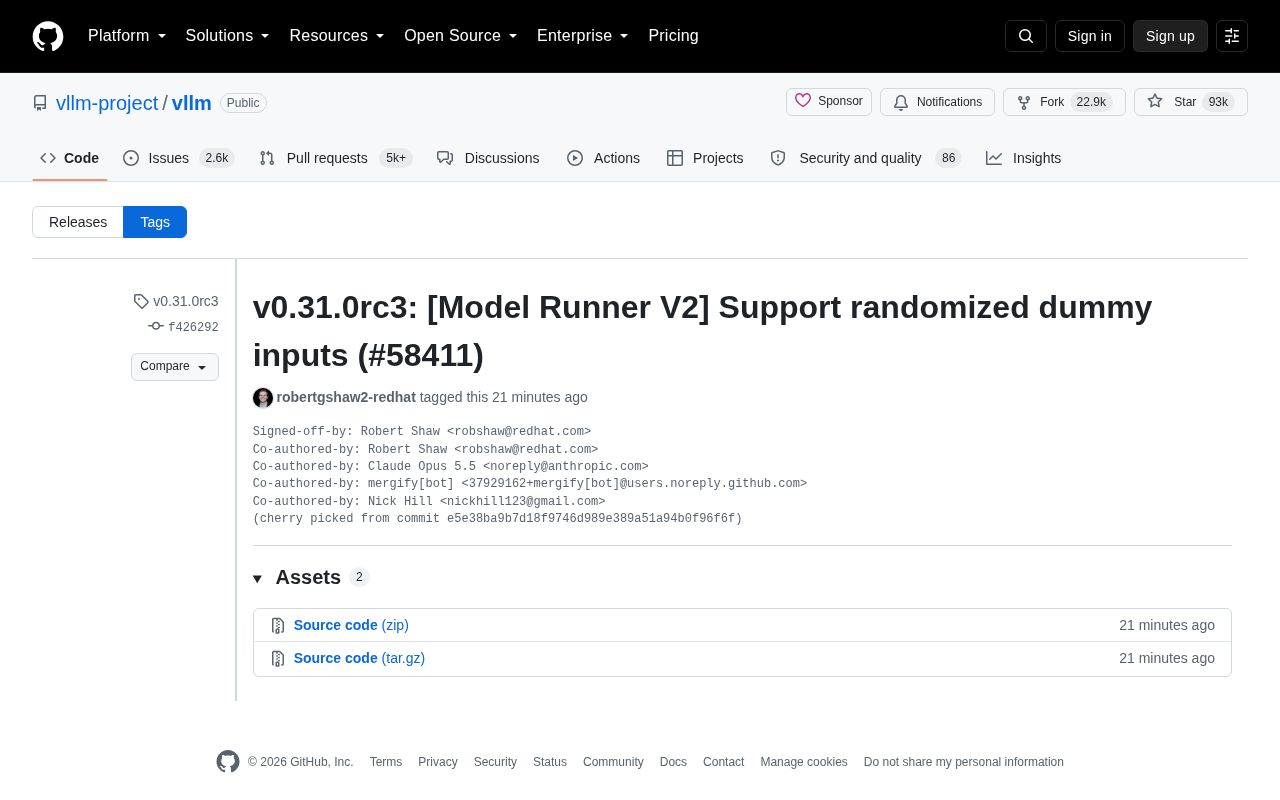
vLLM 发布了 v0.31.0rc3 候选版本,核心改动是为重构后的 Model Runner V2 执行层新增随机化虚拟输入(Randomized Dummy Inputs)支持。虚拟输入用于模型启动阶段的显存预分配、CUDA 内核预热和性能剖析,传统零填充方案在量化或稀疏计算路径下可能导致估算失真;引入随机化数据后,预热阶段的内存分布和算子执行路径更贴近真实推理,从而降低生产部署中的 OOM 风险并减少显存浪费。此版本为候选版,生产环境建议等待正式稳定版发布,感兴趣的开发者可在非关键业务上提前验证并向社区反馈问题。
vLLM v0.31.0rc3 发布概览
vLLM 项目近日发布了 v0.31.0rc3 版本(候选版本),本次更新的核心亮点是为 Model Runner V2 引入了随机化虚拟输入(Randomized Dummy Inputs)支持。作为当前最受欢迎的大语言模型推理与服务框架之一,vLLM 在 GitHub 上已积累超过 9.3 万 Star 和 2.29 万次 Fork,其每一次版本迭代都备受社区关注。
该版本由 Red Hat 的 Robert Shaw 等多位开发者协作完成,提交记录中还出现了 Claude Opus 等 AI 协作署名,体现出当下开源项目开发中人机协作的新趋势。本次更新通过 cherry-pick 的方式合入主分支相关提交,属于正式版本发布前的候选阶段。
Model Runner V2 的意义
Model Runner 是 vLLM 推理引擎中负责实际执行模型前向计算的核心组件。V2 版本是 vLLM 对其执行层架构的重要重构,旨在提升推理调度的灵活性与执行效率,更好地支撑连续批处理(continuous batching)、分页注意力(PagedAttention)等关键机制。
什么是随机化虚拟输入
虚拟输入(Dummy Inputs)在推理框架中有着重要用途。在模型加载、显存预分配和性能剖析(profiling)阶段,框架需要构造一批“假”的输入张量来预跑计算图,从而确定内存占用峰值、预热 CUDA 内核以及验证执行路径的正确性。
传统做法往往使用固定的或零填充的虚拟数据,这在某些场景下可能导致两个问题:一是无法真实反映运行时的内存分布,二是部分依赖输入数值分布的算子(如某些量化路径或稀疏计算)可能在虚拟运行阶段表现与真实推理不一致。引入随机化虚拟输入后,框架可以用更接近真实数据分布的随机张量进行预热与剖析,使显存估算和性能测量更为准确。
连续批处理(Continuous Batching)是 vLLM 区别于传统静态批处理的核心调度机制:推理服务器无需等待一个批次中所有请求同时完成,而是在每个解码步骤后动态地将已完成的请求移出、将新请求插入批次,从而大幅提升 GPU 利用率和整体吞吐量。分页注意力(PagedAttention)则借鉴操作系统虚拟内存的分页思想,将 KV Cache(键值缓存)按固定大小的块(Block)进行非连续存储与动态分配,彻底消除了传统方法中因预留最大序列长度而产生的显存碎片与浪费。Model Runner V2 的重构目标之一,正是为这两项机制在更复杂的调度场景下提供更健壮的执行层支撑。
CUDA 内核预热(Warm-up)是 GPU 推理中不可忽视的工程细节。CUDA 内核在首次执行时需要经历 JIT 编译、内核选择(autotuning)等耗时操作,导致第一批次推理延迟异常偏高。通过在服务启动阶段用虚拟输入预跑计算图,可以提前触发这些初始化流程,使后续真实推理从第一个请求起就能享受稳定的低延迟。量化模型(如 INT4/INT8 量化)和稀疏计算路径对输入数值分布尤为敏感——例如某些动态量化算法会根据输入的实际数值范围动态调整缩放因子,若预热时全用零张量,量化算子可能走入与真实推理完全不同的代码路径,导致显存占用估算失真。随机化虚拟输入正是为了覆盖这类边缘情况而引入。
对开发者与部署者的影响
对于在生产环境中部署 vLLM 的工程团队而言,更精准的显存剖析意味着可以更安全地设定 GPU 内存利用率上限,减少因估算偏差导致的 OOM(显存溢出)风险,或避免显存资源的过度保守浪费。这对于在有限 GPU 资源上跑大模型、追求最大吞吐的场景尤为关键。
对模型开发与框架贡献者来说,Model Runner V2 的持续完善也为后续支持更多模型结构、更复杂的调度策略打下基础。随机化虚拟输入是这类底层能力建设的一环,虽然对终端用户不可见,却是保证推理稳定性与性能可预测性的基础设施。
候选版本的使用建议
需要强调的是,v0.31.0rc3 是一个 Release Candidate(候选版本)而非正式稳定版。rc 版本通常用于社区提前测试新功能、发现潜在缺陷。对于生产环境,建议继续使用已标记为 stable 的正式发行版,待该系列正式版发布后再行升级。
有兴趣尝鲜的开发者可以通过 pip 指定版本号安装该候选版,并在非关键业务上验证 Model Runner V2 相关特性的表现,同时将遇到的问题反馈至项目的 GitHub Issues,帮助项目更快走向稳定。
小结
从提交内容看,这是一次典型的基础设施层面优化,面向的是框架内部的正确性与性能剖析精度,而非面向用户的显著功能变化。但正是这类看似不起眼的底层改进,持续夯实着 vLLM 作为高性能推理引擎的工程质量。随着 Model Runner V2 架构的逐步成熟,可以预期 vLLM 在大模型推理领域将保持其性能与易用性上的领先优势。
相关推荐
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。