vLLM v0.31.0rc4 发布:修复MTP在FULL图下的问题
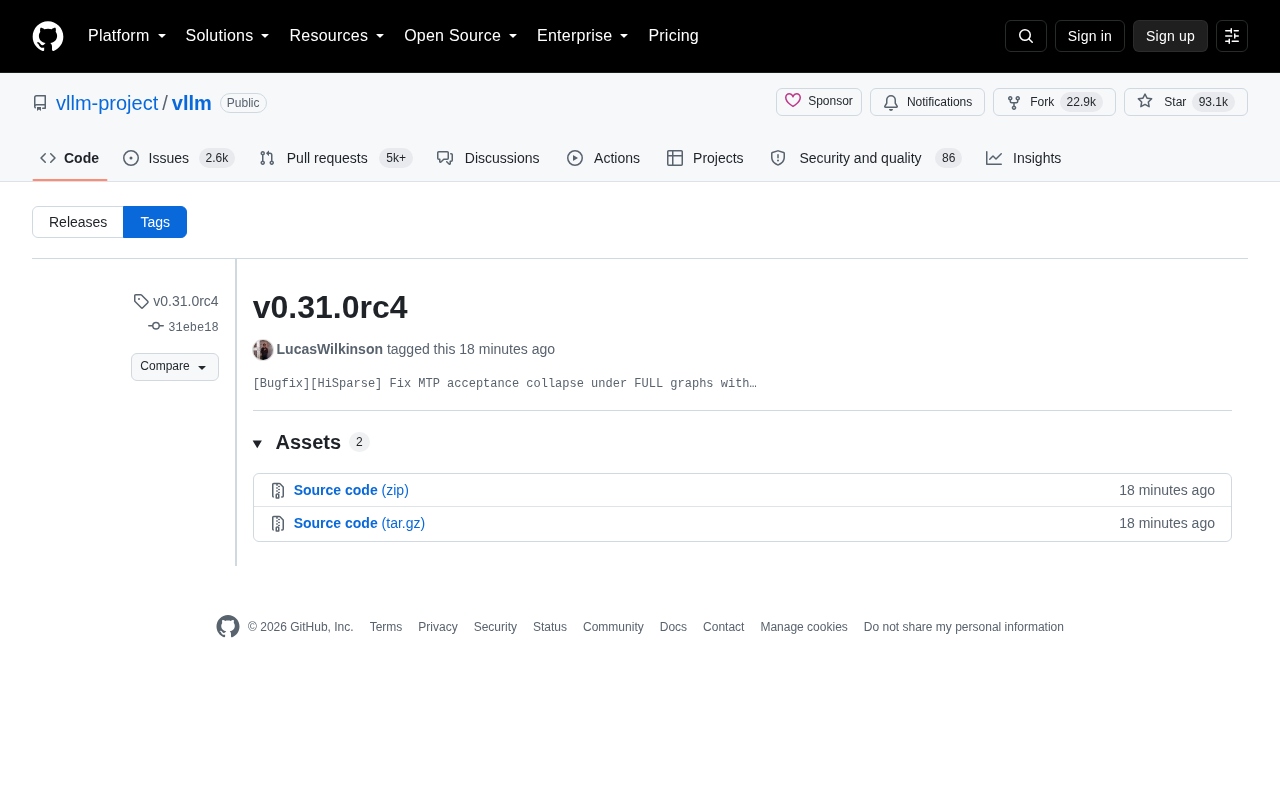
vLLM 发布 v0.31.0rc4,核心修复 MTP 推测解码在 FULL CUDA 图模式下接受率崩溃的缺陷。
vLLM 近日发布 v0.31.0rc4 候选版本,这是一个以稳定性修复为主的迭代,核心解决了 MTP(多 token 预测)在 FULL CUDA 图捕获模式下出现「接受率崩溃」的问题。MTP 是通过主模型附加预测头一次生成多个候选 token 并验证接受的推理加速技术,而 CUDA Graph 则通过预录制计算图减少 GPU 调度开销;两者结合时的状态管理问题可导致加速收益完全失效。对生产环境用户而言,建议在测试环境中先行验证 rc4,稳定性要求高的团队可等待正式版 v0.31.0 发布后再评估升级。目前 vLLM 在 GitHub 上已累积逾 9.3 万 Star,社区活跃度持续攀升。
vLLM 发布 v0.31.0rc4 候选版本
vLLM 项目近日在 GitHub 上标记了 v0.31.0rc4 这一候选发布版本(Release Candidate)。作为当前最受欢迎的大模型推理引擎之一,vLLM 目前在 GitHub 上已累积超过 93,000 颗 Star,拥有约 22,900 次 Fork,社区活跃度持续走高。此次 rc4 版本由维护者 LucasWilkinson 标记,延续了项目高频迭代的一贯节奏。
从命名来看,rc(Release Candidate)意味着该版本已接近正式发布状态,主要工作集中在稳定性修复与回归问题的解决上,而非引入大量新特性。对于希望提前体验或测试新版本的用户而言,这类候选版本提供了一个相对稳定的验证窗口。
核心修复:MTP 在 FULL 图模式下的接受率崩溃问题
此次版本提交信息中明确提到了一项关键修复:[Bugfix][HiSparse] Fix MTP acceptance collapse under FULL graphs。这涉及到推测解码(Speculative Decoding)相关的 MTP(Multi-Token Prediction,多 token 预测)机制。
MTP 是近年来大模型推理加速的重要技术路径之一,通过一次前向预测多个后续 token,再由主模型进行验证接受,从而显著提升生成吞吐。而「acceptance collapse」(接受率崩溃)指的是在某些配置下,MTP 预测出的 token 被接受的比例大幅下降,导致加速收益消失甚至出现性能倒退。
此次修复专门针对 FULL graphs(完整 CUDA 图捕获)模式下出现的这一问题。CUDA Graph 是降低推理内核启动开销的常用手段,但在与 MTP 等复杂解码逻辑结合时,容易出现状态管理上的边界问题。HiSparse 标签则暗示该修复可能与稀疏计算路径相关。
推测解码(Speculative Decoding)的基本原理是:用一个较小的「草稿模型」快速生成若干候选 token,再交由大模型(主模型)并行验证,如果候选 token 与主模型分布吻合则「接受」,否则「拒绝」并重新采样。理想情况下,大多数 token 都能被接受,从而在不损失输出质量的前提下大幅提升吞吐量。MTP(Multi-Token Prediction)是这一思路的变体,不依赖独立的草稿模型,而是在主模型自身结构上附加多头预测层,直接预测未来多个位置的 token。DeepSeek广告 等模型训练时已原生支持 MTP,使其在推理阶段可以自然地与推测解码结合,无需额外的草稿模型部署开销。
CUDA Graph 是 NVIDIA 提供的一种将一系列 GPU 操作(kernel 启动、内存拷贝等)预先录制为静态计算图、之后整体重放的机制。在传统逐 kernel 调度模式下,每次操作都有 CPU 侧的调度开销;而 CUDA Graph 将这些开销摊销为一次性的「图启动」,在小 batch、高并发推理场景下可显著降低延迟。vLLM 的 FULL graphs 模式即尽可能将整个前向计算录制为 CUDA Graph。然而,MTP 的验证逻辑涉及动态的 token 接受/拒绝判断,若相关状态更新未能正确反映在静态图的输入张量中,便会导致验证结果失效,表现为接受率骤降。此次 rc4 的修复正是针对这一状态同步的边界问题。
候选版本的意义与升级建议
对于生产环境用户,候选版本通常不建议直接部署,但它是正式版发布前的重要测试环节。如果你的部署场景恰好用到了 MTP 推测解码并开启了 FULL CUDA 图模式,且此前遇到过加速效果异常下降的情况,那么 rc4 值得优先在测试环境中验证。
如何获取该版本
用户可以通过 GitHub 的 Releases 页面选择对应标签进行下载,或关注 PyPI 上 vLLM 对应预发布版本的推送。候选版本一般会在经过一段时间社区验证后,进一步合并为正式的 v0.31.0 版本。
关注后续正式版
从 rc4 的编号可以推断,v0.31.0 已经经历了多轮候选测试。建议对稳定性要求较高的团队等待正式版发布,并仔细阅读完整的 Release Notes 和 Breaking Changes,以评估升级对现有服务的影响。
小结
vLLM v0.31.0rc4 是一个以缺陷修复为主的候选版本,核心解决了 MTP 在 FULL 图模式下接受率崩溃的问题。这类修复虽然不如新功能那样引人注目,却直接关系到推理加速技术在真实场景中的可用性与稳定性,体现了 vLLM 在高性能推理工程细节上的持续打磨。由于当前公开信息有限,建议读者以官方完整发布说明为准,全面了解此版本的变更内容。
相关推荐

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。

AI Agent工具权限失控?Citadel Identity360用MCP注册表治住
Citadel Identity360如何治理AI Agent的工具访问?通过跨平台发现Agent、绑定人类owner、建立MCP注册表可视化访问路径,并用OAuth门控和函数白名单实现工具级授权,堵住Agent权限盲区。

Claude Code额度消耗快?上下文窗口管理技巧省35%
Claude Code额度消耗过快怎么办?本文拆解上下文窗口膨胀的根源,分享按任务节点清理、关闭闲置连接器、精简CLAUDE.md等实用技巧,实测同样20项任务token消耗降低约35%,API成本从5.94美元降至3.91美元。