vLLM多伦多见面会官宣:Cohere、NVIDIA联合主办

vLLM将于10月15日在多伦多举办免费线下见面会,联合Cohere、NVIDIA AI和Inferact共同探讨框架未来方向。
vLLM官方宣布将于10月15日在加拿大多伦多举办线下技术见面会,由vLLM团队联合企业级大语言模型公司Cohere、硬件生态代表NVIDIA AI及推理服务方Inferact共同主办,活动免费参加。核心议程围绕vLLM未来发展方向的技术分享展开,并设有与各团队成员面对面交流的环节。主办阵容覆盖了从底层硬件、推理框架到模型应用的完整技术栈,体现出vLLM在当前LLM推理生态中的枢纽地位。对于身处多伦多及周边、从事大模型推理部署或关注开源AI基础设施的从业者而言,这是获取一手路线图信息、建立行业人脉的难得机会。
vLLM社区落地多伦多
vLLM官方近日在社交平台发布消息,宣布将于10月15日在多伦多举办一场线下技术见面会(Meetup)。本次活动由vLLM团队联合Cohere、NVIDIA AI以及Inferact共同主办,面向对大模型推理优化感兴趣的开发者与从业者免费开放。
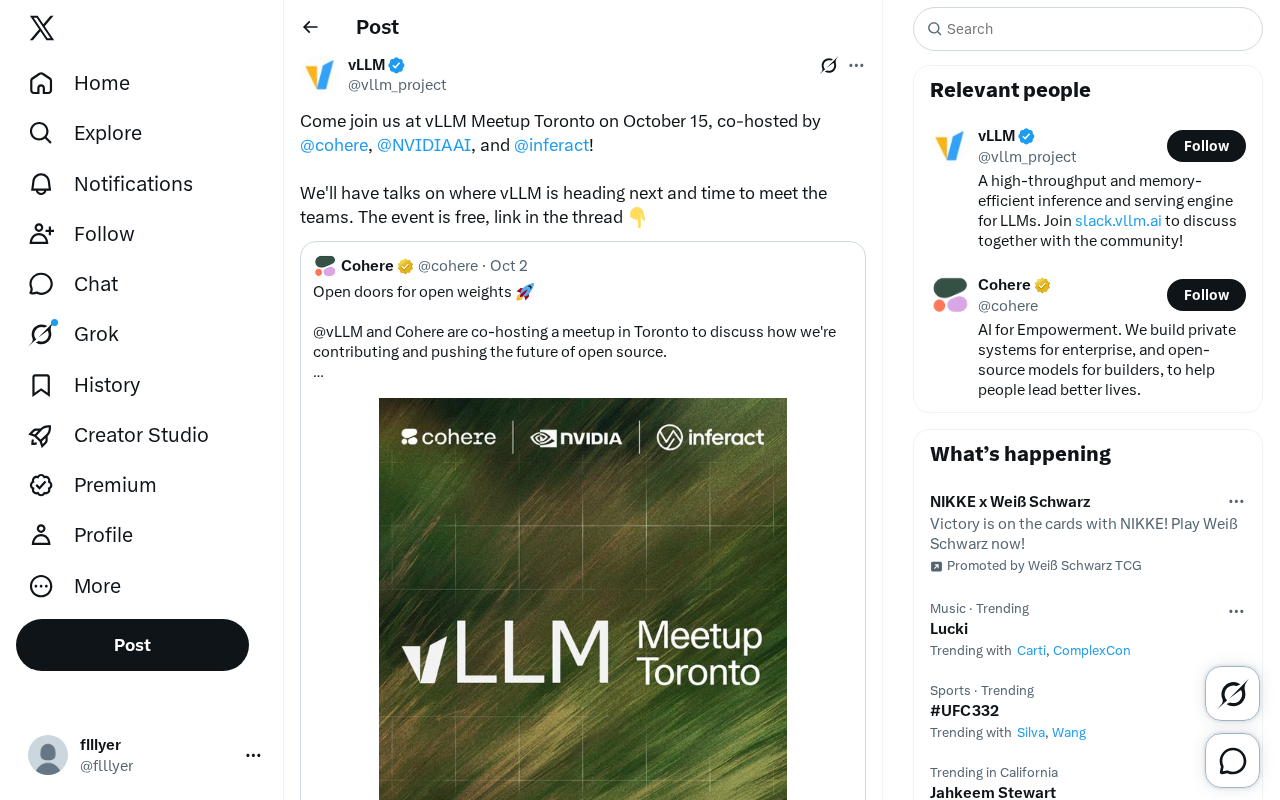
根据官方说明,这场见面会的核心议程将围绕vLLM的未来发展方向展开,同时为与会者提供与各合作团队面对面交流的机会。活动免费参加,报名链接在原帖的讨论串中公布。
为什么这场活动值得关注
vLLM作为当前最受关注的开源大模型推理与服务框架之一,凭借PagedAttention等核心技术,在吞吐量和显存利用率上的表现让它迅速成为业界部署LLM服务的主流选择之一。此次由框架团队亲自出面举办的线下活动,往往意味着会分享一手的路线图信息。
从主办阵容也能看出活动的分量。Cohere是专注于企业级大语言模型的公司,NVIDIA AI则代表着底层算力与推理加速的硬件生态,再加上Inferact这样的推理服务参与方,三方与vLLM同台,覆盖了从硬件、框架到模型应用的完整链条。这种组合本身就反映出vLLM在整个推理技术栈中的枢纽地位。
PagedAttention是vLLM的核心创新技术,由UC Berkeley团队提出。其灵感来自操作系统的虚拟内存与分页机制:传统LLM推理框架会为每个请求预先分配连续的KV Cache(键值缓存)显存空间,导致大量显存碎片化浪费;PagedAttention则将KV Cache切分为固定大小的"页",按需动态分配和释放,使不同请求之间可以共享物理显存块。这一设计让vLLM在相同硬件上能够并发处理更多请求,实测吞吐量相比Hugging Face Transformers等方案可提升数倍,是vLLM迅速成为主流推理框架的技术基础。
议程重点:vLLM的下一步
官方透露,活动将设置关于"vLLM接下来走向何方"的技术分享。对于长期跟踪该项目的开发者而言,这类官方路线图演讲通常比文档更具参考价值——它往往会提前释放出即将支持的新特性、性能优化方向以及生态协作计划的信号。
除了技术演讲,活动还安排了与各团队成员直接交流的时间。对于正在生产环境中使用或评估vLLM的工程师来说,能够当面向核心开发者和合作方提问,是线上渠道难以替代的价值。
Inferact是一家专注于LLM推理服务商业化落地的公司,在vLLM生态中扮演工程化与生产部署的角色。与主要面向研究和开源社区的框架团队不同,此类推理服务参与方通常积累了大量真实生产环境下的性能调优经验——包括批处理策略、延迟与吞吐的权衡、多租户隔离等工程细节。其参与本次活动,意味着与会者不仅能听到框架层面的演进方向,也能接触到来自生产一线的实践反馈,这对评估vLLM落地可行性的工程师尤具参考价值。
参会信息
- 时间:10月15日
- 地点:加拿大多伦多(线下)
- 主办方:vLLM团队、Cohere、NVIDIA AI、Inferact
- 费用:免费
- 报名方式:见原帖讨论串中的链接
对于身处多伦多及周边地区、从事大模型推理部署或对开源AI基础设施感兴趣的读者,这类聚集了框架团队与硬件、模型厂商的线下活动,是了解行业动向并建立人脉的难得机会。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。