VRAM停车问题:如何消除60%的GPU闲置税

企业将静态模型常驻GPU显存造成严重闲置浪费,动态多路复用可节省67%成本。
文章提出并剖析了企业AI基础设施中的“VRAM停车问题”:将静态模型检查点永久加载到专用GPU的HBM中,导致综合利用率不足28%,8节点H100集群每节点每年浪费约16万美元。根本原因在于传统单体推理引擎要求模型常驻显存以避免冷启动。Logic42的基准测试显示,静态预留集群月成本高达12.6万美元,而朴素Serverless虽有10秒级冷启动,统一多路复用基座则以4.2万美元月成本、低于45毫秒的冷启动取得最佳平衡,节省67%费用。文章给出三条工程规则——围绕共享基础主干与Multi-LoRA整合、通过PCIe Gen5 NVMe与GPUDirect Storage实现亚秒级权重流式传输、构建分时出站与批处理套利网关,并建议FinOps团队监测有效GPU功耗饱和度等三项指标,将计算效率从25%提升到85%以上。
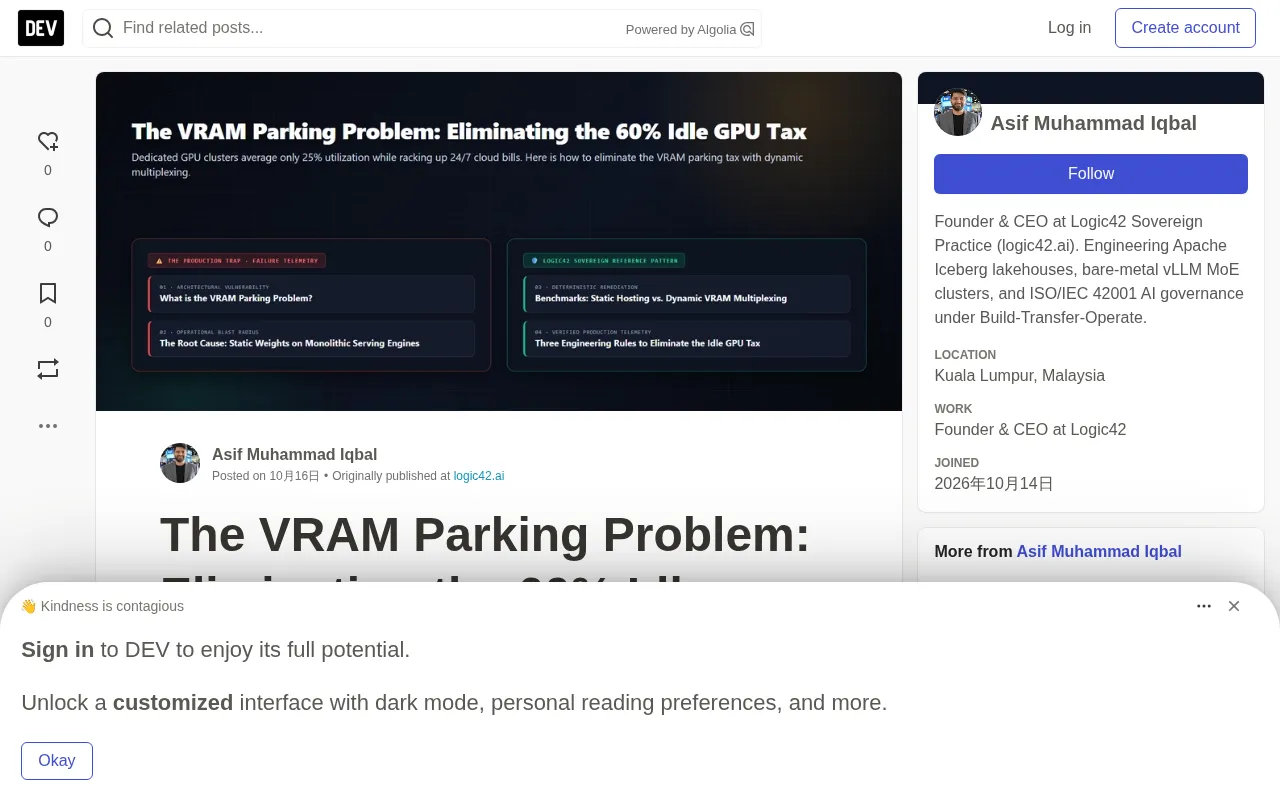
什么是VRAM停车问题?
VRAM停车问题(VRAM Parking Problem)指的是企业将静态模型检查点永久加载到专用GPU的高带宽内存(HBM)中,无论实际用户并发量如何,都持续预留昂贵的计算资源。这种模式下,一台8卡H100节点在非高峰时段闲置,却仍以每小时35美元的价格计费,成为企业级AI基础设施中一种难以辩护的财务浪费。
问题的核心在于资源分配逻辑的错位。当平台团队为法律分析或内部客服部署一个专用70B参数模型时,往往会独占2到4块H100 GPU。工作时间内,模型处理稳定请求;但到了夜间、周末或用户交互间隙,模型完全空闲。由于传统深度学习服务框架要求模型常驻内存以避免冷启动,企业不得不为这些“零计算”的GPU支付全额小时费率。
闲置到底浪费了多少资金?
根据Logic42在企业客户审计中收集的生产遥测数据,专用内部LLM实例在30天窗口内的综合计算饱和度不足28%。在一个典型的8节点H100集群上,这种闲置容量意味着每节点每年约16万美元的浪费。对于运行多个专用模型的企业而言,这种“GPU闲置税”会迅速累积成七位数的年度无效支出。
根本原因:单体服务引擎上的静态权重
传统推理架构将GPU内存视为实体房地产:一个容器一个模型,一组GPU对应一个容器。这种静态分配模式在企业流量模式下迅速崩溃。
当企业托管五个不同的微调模型时,如果在五个独立专用集群上部署,流量并没有变成五倍,只是闲置内存开销变成了五倍。每个模型都独占一个GPU组,在大部分时间里消耗电力却不做任何有效计算。
静态分配(VRAM停车陷阱)
节点1(8x H100 — $35/小时):法律-70B模型常驻,其余VRAM在一天中72%的时间闲置。
节点2(8x H100 — $35/小时):金融-70B模型常驻,其余VRAM在一天中65%的时间闲置。
总成本:$70/小时($50,400/月),平均利用率仅约25%。
相比之下,动态VRAM虚拟化方案使用统一基础权重加多路复用:单个共享节点(8x H100 — $35/小时)在HBM中加载基础基座权重(如Llama-3.3-70B主干),同时加载多个LoRA适配器(法律、金融等),配合动态PagedAttention池和亚秒级NVMe适配器缓存,总成本降至$35/小时($25,200/月),持续利用率可达78%。
LoRA(低秩适配,Low-Rank Adaptation) 是微软于2021年提出的一种参数高效微调方法。其核心思想是冻结预训练模型的全部原始权重,仅在每个Transformer层的注意力矩阵旁注入一对小型低秩矩阵(A和B),训练时只更新这两个小矩阵。由于秩通常取8到64,可训练参数量往往只有原模型的0.1%–1%,因此微调成本极低且产物只有几十到几百MB。更关键的是,多个LoRA适配器可以共享同一份基础权重,在推理时按请求动态切换或合并,这正是后文“Multi-LoRA共享主干”方案得以成立的技术前提。
PagedAttention 是vLLM推理引擎引入的显存管理机制,借鉴操作系统虚拟内存分页思想,将KV缓存切分为固定大小的block并按需分配,从而消除传统实现中因预留最大序列长度而产生的显存碎片。它使显存利用率从约60%提升到90%以上,并天然支持多请求共享同一份基础权重,是多路复用服务引擎能够承载高并发、多适配器的关键底层组件。
基准测试:静态托管 vs 动态VRAM多路复用
Logic42的内部基准测试揭示了静态专用实例与动态多路复用服务之间的财务差异。
| 架构模式 | 峰值VRAM饱和度 | 非高峰浪费 | 月成本(5个工作负载) | 冷启动开销 |
|---|---|---|---|---|
| 静态预留集群 | 31% | 82% | $126,000 | 0 ms |
| 朴素Serverless冷启动 | 92% | 0% | $24,000 | 8,000–14,000 ms |
| 统一多路复用基座 | 84% | 14% | $42,000 | < 45 ms |
朴素Serverless云端点确实节省了闲置时间费用,但其10秒级的冷启动会摧毁交互式业务应用的用户体验。真正的工程目标是动态多路复用:保持基础权重热驻留,同时以毫秒级速度热切换任务适配器。统一多路复用基座在成本($42,000/月)和延迟(<45ms)之间取得了最佳平衡,相比静态预留集群节省67%的费用。
消除闲置GPU税的三条工程规则
无需牺牲低延迟推理来停止烧钱。实施以下三项架构转变即可显著改善单位经济性。
1. 围绕共享基础主干与Multi-LoRA进行整合
停止微调完整模型检查点。如果你有三个领域任务(合同、代码审查、客户支持),将它们微调为低秩适配(LoRA)适配器,叠加在单个共享基础模型(如Llama 3.3 70B)之上。基础模型只需加载一次到VRAM中,请求时使用vLLM或S-LoRA等现代服务引擎,针对每个传入的token批次动态应用特定适配器权重。这样,一个集群就能服务50个专门任务,无需复制基础内存。
2. 通过PCIe Gen5 / NVMe实现亚秒级权重流式传输
当某个专门模型15分钟内没有收到流量时,将其适配器权重从VRAM分页到本地高速PCIe Gen5 NVMe存储中。利用GPUDirect Storage(GDS)等内核旁路技术,可以在新请求到达网关时,不到40毫秒内将适配器权重流回HBM。用户不会察觉到冷启动,而VRAM分配器可回收60%的工作内存。验证GDS到GPU内存的吞吐量:gdscheck -p,确保NVMe到VRAM带宽超过每插槽24 GB/s。
GPUDirect Storage(GDS) 是NVIDIA推出的一项内核旁路(kernel-bypass)技术,允许NVMe固态硬盘等存储设备通过PCIe总线直接与GPU显存进行DMA传输,绕过CPU主机内存和操作系统的页缓存拷贝路径。传统路径下数据需经“存储→CPU内存→GPU显存”两次拷贝,GDS将其压缩为一次直接传输,显著降低延迟与CPU占用。这正是文章所述“40毫秒内将适配器权重流回HBM”的物理基础——若走传统拷贝路径,即便NVMe带宽充足,额外的中转和上下文切换也会令延迟成倍上升。部署GDS需满足特定驱动、文件系统(如ext4、XFS)与CUDA版本要求,并可用gdscheck -p工具验证通路是否启用。
3. 构建分时出站与批处理套利网关
企业内部工作负载有明显的时序边界。分析批处理任务(日志摘要、语义重索引、合规审计)不需要即时响应。配置AI网关在非高峰夜间窗口(晚10点至早6点)排队后台批处理任务。当交互式人类用户休息时,用延迟的后台工作饱和你的热GPU集群,将计算效率从25%提升到85%以上。
FinOps团队在下一预算周期前必须衡量的指标
在管理层锁定下一财年IT资本预算之前,从集群遥测中提取以下指标。
有效GPU功耗饱和度:通过DCGM指标测量实际的Tensor Core活动,而不仅仅是内存是否已分配。如果你的GPU在700W TDP上限下仅消耗180W,说明集群处于停车状态。
适配器与主干整合比:目标是在每个常驻基础模型上至少运行4个活跃LoRA任务适配器。
非高峰Token吞吐量:白天交互式Token与夜间批处理Token的比率。健康的比率接近1:1。
DCGM(Data Center GPU Manager) 是NVIDIA官方的GPU集群监控与管理工具集,可采集包括SM(流多处理器)占用率、Tensor Core活跃度、显存带宽、功耗、温度在内的数百项细粒度指标,并支持导出到Prometheus、Grafana等可观测性平台。文章强调的“有效GPU功耗饱和度”正依赖DCGM的功耗与Tensor Core活动字段:若一块TDP上限700W的H100在实际负载下仅消耗180W,说明计算单元大部分时间处于空闲,即便显存显示已分配,也意味着集群正处于“停车”状态。仅看显存占用率会产生误导,因为静态停放的模型同样占满显存却不产生任何算力输出。
核心结论
购买专用GPU集群并让它们固定于静态模型检查点,相当于租赁整栋办公大楼却只在每天开灯两小时。高带宽内存是地球上最昂贵的硅片,其单位经济性必须与实际业务需求相匹配。停止在VRAM中停放无效权重,统一你的基础主干,从NVMe流式传输适配器,让AI基础设施的账本反映真实的商业价值而非资源浪费。
对于正在评估这一架构瓶颈的团队,Logic42提供了交互式诊断工具,可在3.5分钟内完成第一阶段阻塞检测并生成可下载的董事会PDF档案。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。