VSArena 1.0发布:具身AI的开放浏览器基准测试来了
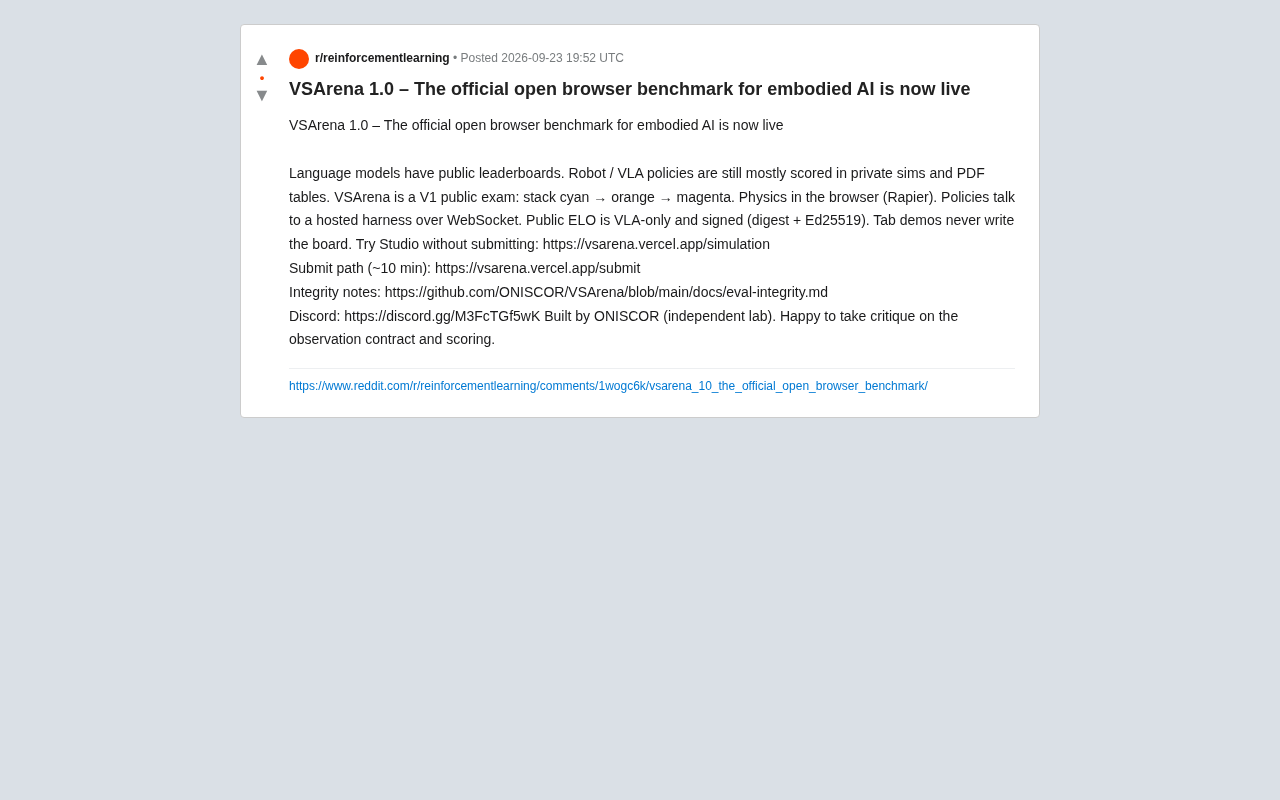
VSArena 1.0将具身AI/VLA策略评测搬进浏览器,用ELO榜单和数字签名打造可公开验证的开放基准。
独立实验室ONISCOR推出的VSArena 1.0,是首个在浏览器内运行物理仿真的具身AI开放基准测试。其核心任务为让VLA策略按指定颜色顺序堆叠方块,仿真由Rapier引擎驱动,策略通过WebSocket与评测框架通信。榜单采用ELO评分机制,每条成绩经digest加Ed25519数字签名验证,确保可追溯、防篡改。系统区分Studio演示模式与正式提交两条路径,演示不写入榜单。VSArena的核心价值不在于单一任务本身,而在于它试图为碎片化的具身AI评测领域建立透明、可复现、带防作弊机制的公开对比框架,填补类似语言模型开放排行榜在机器人领域的空白。
语言模型有公开的排行榜,而机器人和VLA(Vision-Language-Action,视觉-语言-动作)策略至今仍主要在私有仿真环境中评测,成绩藏在一张张PDF表格里,缺乏统一、可复现的公开对比标准。独立实验室ONISCOR推出的VSArena 1.0,正是想打破这一现状——它把具身AI的评测搬进了浏览器,做成了一个公开可验证的"考场"。
什么是VSArena
VSArena自我定位为面向具身AI(embodied AI)的官方开放浏览器基准测试。它的核心任务设计相当直观:让策略模型完成一个物体堆叠任务——按照"青色 → 橙色 → 品红"的顺序把方块堆叠起来。
这个看似简单的任务背后是一套完整的评测机制。物理仿真直接跑在浏览器里,由Rapier物理引擎驱动,意味着任何人打开网页就能看到真实的物理交互,而不需要在本地配置复杂的仿真环境。策略模型则通过WebSocket与托管的评测框架(harness)通信,把决策发回给仿真环境执行。
这种"浏览器即考场"的形态,降低了参与和验证的门槛。对于长期依赖私有sim的机器人评测领域来说,这是一次把过程透明化的尝试。
Rapier 是一款用 Rust 编写、可编译为 WebAssembly 的高性能物理引擎,专为在浏览器和轻量级运行时中实现实时刚体仿真而设计。与 MuJoCo、PyBullet 等主流机器人仿真器不同,Rapier 无需本地安装任何依赖,仿真状态完全在浏览器沙箱内运行,具备跨平台可复现性。这一特性使 VSArena 能够让任意访客在同一物理环境下验证策略行为,而不会因本地仿真器版本差异产生结果偏差——这正是可复现基准测试的核心要求之一。
VLA(Vision-Language-Action)模型是近年具身AI的主流范式,它将视觉感知、语言理解与动作输出统一到同一模型框架中,代表性工作包括 Google 的 RT-2、OpenVLA 等。这类模型接收图像和语言指令作为输入,直接输出机器人关节控制信号或末端执行器姿态,本质上是将大规模预训练语言/视觉模型迁移到机器人操作任务。VSArena 的评测对象正是此类策略模型:通过 WebSocket 接收来自仿真环境的观测数据,再将动作指令发回执行。
ELO排行榜与评测可信度
VSArena借鉴了语言模型领域公开排行榜的思路,为VLA策略引入了ELO评分机制。这里有几个关键设计值得关注。
首先,公开的ELO榜单只针对VLA策略,且成绩经过签名验证——使用摘要(digest)加Ed25519数字签名。这是为了保证榜单上每一条成绩都是可追溯、防篡改的。在一个人人可提交的开放系统里,防作弊和结果可信度是排行榜能否立得住的根本。
其次,项目明确区分了"演示"和"正式提交"两条路径。网页上的Tab演示(Studio模式)永远不会写入正式榜单,用户可以先在 Studio 里试玩、调试,感受观测契约(observation contract)和任务机制,而不必担心污染排行榜数据。想正式参与排名时,再走提交流程,整个提交过程官方称大约只需10分钟。
ELO 评分系统最初由物理学家 Arpad Elo 为国际象棋设计,核心思想是通过胜负对局动态更新选手评分:击败强者得分增加多,击败弱者得分增加少。近年来它被引入 LLM 评测领域(如 LMSYS Chatbot Arena),用于处理"策略 A 在任务 X 上优于策略 B"这类无法直接量化的相对排名问题。在机器人策略评测中,ELO 机制的挑战在于任务场景较少、提交样本稀疏,早期分数方差较大,排名稳定性需要积累足够多的对局数据才能显现。这也是 VSArena 作者主动征求社区反馈的重要背景。
Ed25519 是一种基于椭圆曲线的数字签名算法,以高性能和抗侧信道攻击著称,被 OpenSSH、TLS 1.3 等广泛采用。在 VSArena 的语境中,每条提交结果都附带由服务端私钥生成的 Ed25519 签名和内容摘要(digest),任何人可用公钥独立验证某条成绩是否由官方评测框架真实产生、有无被事后篡改。这种机制将"可信任"从依赖平台信誉转移到了密码学保证层面。
如何参与
对想尝试的开发者,VSArena提供了几条清晰的入口:
- 免提交试玩:直接进入Studio模式体验仿真,地址为 vsarena.vercel.app/simulation
- 正式提交:约10分钟即可完成,入口为 vsarena.vercel.app/submit
- 评测完整性说明:项目在GitHub上公开了 eval-integrity 文档,详述签名与防作弊机制
- 社区交流:官方开设了Discord频道
项目由独立实验室ONISCOR开发,作者在发布时明确表示欢迎针对"观测契约"和"评分机制"提出批评意见。这种主动征求同行审视的姿态,对一个刚发布的V1版本基准来说是合理且必要的——基准测试的价值恰恰建立在社区共识与持续质疑之上。
为什么这件事值得关注
具身智能与VLA模型近来热度攀升,但评测标准的碎片化一直是行业痛点。不同团队用不同的仿真器、不同的任务设置、不同的指标各说各话,横向比较几乎无从谈起。
VSArena的意义不在于它当前的单一堆叠任务本身,而在于它试图为这个领域建立一个可公开验证、可复现、带防作弊机制的对比框架。把物理仿真放进浏览器、用数字签名保证成绩可信、区分演示与正式榜单,这些设计都指向同一个目标:让具身AI的评测像语言模型排行榜那样透明。
当然,作为1.0版本,它仍有大量待观察之处——任务的丰富度、观测契约是否足够通用、ELO机制在稀疏任务下的稳定性,都需要更多提交样本和社区反馈来检验。但作为一次开源、开放的尝试,VSArena为具身AI评测的标准化开了一个值得跟进的头。
相关推荐
Opus 5.5 一键生成动画短片:$3.21 API 费用背后的自主创作实验
一位 Reddit 用户用 Opus 5.5 通过单条提示词自主生成手绘风格动画短片,OpenRouter API 花费仅 3.21 美元,调用 8 个 API 完成脚本、图像、配音到动画全流程。本文解析其成本结构与 AI Agent 自主编排能力。
Bessemer募资57.5亿美元加码AI:豪赌AI原生公司高增长
老牌风投Bessemer募集57.5亿美元新基金全力押注AI,称AI原生公司增长速度超过历史上任何技术。本文解析这笔巨额资金背后的行业逻辑与潜在风险。
从研究项目到开源生态:学术界PyTorch项目走向PyTorchCon
PyTorch 官方向学术界发出征集,邀请高校与研究机构将基于 PyTorch 的科研项目带到 PyTorchCon NA 大会。本文解析学术项目走向开源生态的价值、机会与实践建议。