外部引导何时真正帮助大模型推理?GA-GRPO的偏差-方差理论

GA-GRPO用统一数学框架首次量化外部引导何时有效,并给出最优引导权重闭式解。
《When Does External Guidance Help LLM Reasoning?》提出GA-GRPO框架,将外部引导建模为随机算子,统一了LUFFY、ExPO、PAPO、TAPO与vanilla GRPO等主流方法。论文系统证明三个核心结论:引导以O(1/√T)速率收敛但止步于偏差邻域;存在最优引导权重闭式解λ*,揭示训练早期应重引导、后期应降权重的退火规律;以及Ω(δ²T)偏差项因匹配极小极大下界而不可避免。在Qwen2.5-Math-7B的九个数学基准上,采用最优权重的GA-GRPO性能匹配或超越所有对比方法,同时GPU成本降低31%。这项工作为RLVR训练中"何时引入外部知识、引导权重如何动态调整"提供了可操作的原则性答案,也从理论上划清了外部引导方法的能力边界。
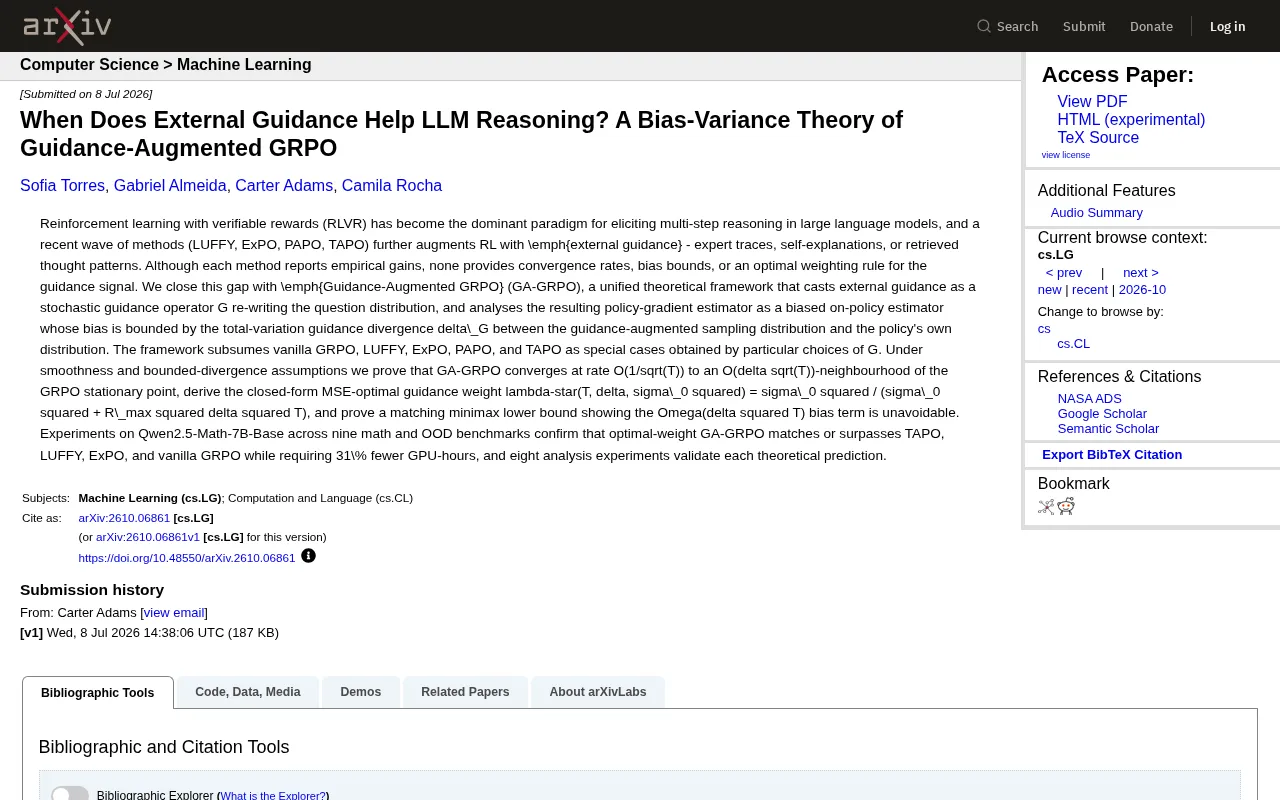
强化学习驱动的多步推理已经成为提升大语言模型能力的主流路径,而近期一批方法(LUFFY、ExPO、PAPO、TAPO)在此基础上引入了"外部引导"——专家轨迹、自我解释或检索到的思维模式。这些方法各自报告了实验增益,却始终没人能回答一个根本问题:外部引导究竟在什么条件下有效?引导信号应该赋予多大权重才最优?
一篇名为《When Does External Guidance Help LLM Reasoning?》的新论文给出了系统性的理论答案,提出了统一框架 Guidance-Augmented GRPO(GA-GRPO),首次为这一类方法提供了收敛速率、偏差界限和最优加权规则。
问题的核心:引导带来增益,也带来偏差
带可验证奖励的强化学习(RLVR)已是激发大模型多步推理的主导范式。在标准做法之上,研究者尝试注入各种外部知识来加速或改善训练。直觉上,专家轨迹能让模型"少走弯路",但这里存在一个被长期忽视的代价:当引导信号偏离模型自身的采样分布时,策略梯度估计会产生偏差。
此前的 LUFFY、ExPO、PAPO、TAPO 等方法都是经验性地调参、报告收益,缺乏对"偏差有多大""何时该信任引导"的定量刻画。这正是 GA-GRPO 想要填补的理论空白。
GRPO(Group Relative Policy Optimization)是当前主流的RLVR训练算法,由DeepSeek广告团队提出,作为PPO的轻量替代方案。它的核心思路是:对同一问题采样一组输出,以组内相对奖励代替绝对奖励来估计优势函数,从而省去价值网络,大幅降低训练成本。标准GRPO是完全on-policy的——用于估计梯度的样本与当前策略完全一致,保证了估计的无偏性。当外部引导介入后,部分训练样本来自专家轨迹或检索到的思维链,这些样本并非由当前策略生成,导致重要性权重偏离1,策略梯度估计随之产生系统性偏差。这正是"外部引导"与on-policy算法之间天然的张力所在。
统一框架:把外部引导建模为随机算子
GA-GRPO 的关键思路,是把外部引导抽象成一个随机引导算子 G,它重写了问题的分布。原本 on-policy 的策略梯度,在引导下变成了一个有偏的 on-policy 估计器。
论文证明,这个偏差的大小由"引导散度" delta_G 控制——即引导增强后的采样分布与模型自身分布之间的总变差距离(total-variation divergence)。散度越大,引导离模型越"远",偏差也越大。
这个框架的优雅之处在于它的普适性:通过选择不同的 G,vanilla GRPO、LUFFY、ExPO、PAPO、TAPO 都成为该框架的特例。换句话说,这些看似不同的方法,本质上只是在引导算子上做了不同选择。
总变差距离(Total Variation Distance,TV距离)是衡量两个概率分布差异的经典度量,定义为两分布在所有可测集合上概率差值的最大值,取值范围在0到1之间。TV距离为0意味着两分布完全相同,为1意味着两分布的支撑集完全不重叠。在强化学习中,TV距离常被用来量化重要性采样的偏差程度:采样分布与目标分布的TV距离越大,用前者估计后者期望时引入的偏差上界也越大。GA-GRPO用TV距离定义"引导散度"δ_G,直接建立了引导信号"离模型有多远"与"偏差有多大"之间的定量联系,使得不同引导方法的偏差风险可以在同一尺度上比较。
三个核心理论结果
在光滑性与有界散度的假设下,论文给出了三个值得关注的结论:
收敛速率与偏差邻域
GA-GRPO 以 O(1/√T) 的速率收敛到 GRPO 驻点的 O(δ√T) 邻域。也就是说,引导能加速训练,但最终会停留在一个由散度决定的"偏差球"内,而非精确收敛到无偏目标。
最优引导权重的闭式解
这是最具实践价值的结果。论文推导出使均方误差(MSE)最小的最优引导权重:
λ*(T, δ, σ₀²) = σ₀² / (σ₀² + R_max² · δ² · T)
这个公式揭示了一个清晰的动态规律:训练早期(T 小)、模型自身方差大(σ₀² 大)时,应多信任外部引导;随着训练推进、引导偏差的累积效应(δ²T)增大,就应逐渐降低引导权重。这为"引导退火"策略提供了理论依据。
这个公式本质上是偏差-方差权衡(Bias-Variance Tradeoff)在时序训练中的具体展开。分子σ₀²代表模型自身梯度估计的方差——训练初期模型输出随机性高,梯度噪声大,此时外部引导作为低方差的"锚点"能有效压缩估计误差。分母中的R_max²·δ²·T项代表引导偏差随时间累积的代价:每一步训练都在偏差方向上积累,步数T越多,这一惩罚越重。当两者之比决定权重时,策略自然从"早期重引导"向"后期重自身"过渡,形成自适应退火。这与学习率调度、动量衰减等工程实践背后的直觉一致,但此处给出了具体的解析形式,可直接用于计算每步的最优λ值而无需网格搜索。
匹配的极小极大下界
论文还证明了一个匹配的 minimax 下界,表明 Ω(δ²T) 这一偏差项是不可避免的。这意味着只要引导分布与模型分布存在差异,就必然付出偏差代价——没有任何加权技巧能完全消除它。这个结论从根本上界定了外部引导方法的能力边界。
极小极大下界(Minimax Lower Bound)是理论计算机科学与统计学中证明"最优算法性能上限"的标准工具。其含义是:无论设计何种算法,在最坏情况下都至少会遭受某一量级的误差或代价。当论文证明偏差项Ω(δ²T)满足极小极大下界时,意味着这一代价不是某个具体算法设计缺陷导致的,而是问题本身的内禀困难——即便使用理论上最优的引导加权策略,只要引导分布与策略分布之间存在TV距离δ,经过T步训练后的累积偏差就必然达到δ²T量级。这个结论的实践含义是:若引导源质量不高(δ较大),延长训练反而会放大偏差,此时应果断降低引导权重甚至停止使用外部引导,而非继续依赖经验调参。
实验验证:性能持平或更优,GPU成本降31%
理论之外,论文在 Qwen2.5-Math-7B-Base 上,跨越九个数学及分布外(OOD)基准进行了验证。结果显示,采用最优权重的 GA-GRPO 在性能上匹配或超越 TAPO、LUFFY、ExPO 和 vanilla GRPO,同时所需 GPU 小时数减少了 31%。
更关键的是,另有八组分析实验分别验证了每一条理论预测的正确性——这让该工作不只是一个新方法,而是一套可被实验反复检验的理论体系。
为什么这项工作值得关注
当前大模型推理训练领域充斥着各种经验性技巧,缺乏理论根基。GA-GRPO 的意义在于:
- 它把一批零散的引导增强方法纳入同一数学框架,让它们可以被统一比较;
- 它给出了"引导权重该如何随训练动态调整"的可操作公式,而非靠人工调参;
- 它用下界证明划清了外部引导的能力极限,避免研究者在无法改善的方向上浪费算力。
对于正在设计 RLVR 训练流程的团队来说,这套偏差-方差视角提供了一个判断"何时该引入外部知识、何时该相信模型自身"的原则性工具。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。