完美的模型也会把因果关系搞反:聊聊因果机器学习的do算子

因果ML核心:高精度预测模型学的是相关性,用do算子才能区分观察与干预
本文以一个药物与疾病的反直觉例子,清晰阐释了机器学习中相关性与因果性的根本区别。模型可以以极高精度学到"服药者患有某病"的规律,但这一规律的因果方向恰好相反——是患病导致用药,而非用药导致患病。若将预测模型直接用于决策,就可能得出"停药即可治病"的荒谬结论。因果机器学习通过引入 do 算子,将"主动干预"与"被动观察"在数学上严格区分。对于任何以决策和干预为目标的AI应用场景——医疗、金融、营销等——仅靠传统监督学习拟合观测数据是不够的,必须建立因果结构,才能正确回答"改变X会带来什么结果"这一核心问题。
相关性不等于因果性:一个经典陷阱
机器学习模型擅长在数据中找规律,但找到的规律并不一定代表真实的因果方向。一个精度极高、看似完美的模型,仍然可能把因果关系彻底搞反。
原始素材里举了一个直击要害的例子:模型基于数据得出结论——"如果病人服用了这种药,那么他们就患有这种疾病"。从统计关联上看,这个结论完全正确,药物和疾病之间确实高度相关。
于是你可能会天真地想:既然吃药和得病高度相关,那我们停掉这种药,病人不就不会得病了吗?这显然是荒谬的。真实的因果链条恰恰相反——是因为病人患了病,医生才给他们开了这种药,而不是药导致了病。
观察 vs. 干预:do 算子的核心价值
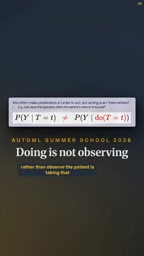
这个例子揭示了因果机器学习(Causal ML)与传统预测建模的根本区别。普通模型回答的是"我观察到病人在吃药,那他有多大概率得病",而因果推断要回答的是"如果我主动让病人吃药(或停药),会发生什么"。
这两者在数学上是完全不同的操作。因果推断中用 do 算子(do-operator) 来表达这种主动干预:do(给病人用药) 和 观察到病人在用药 是两码事。
当你执行 do 操作、强行改变某个变量时,你实际上切断了这个变量原本的"来路"。在用药的例子里,一旦你决定让所有病人都吃药——不管他们有没有病——那么"吃药"这个变量就不再携带任何关于疾病的信息了。因为用药的决定来自你,而不再来自病情。
do 算子由统计学家 Judea Pearl 在其因果推断框架(Pearl Causality)中正式提出,是结构因果模型(Structural Causal Model,SCM)的核心符号工具。在数学上,P(Y | X=x) 表示"在观测到 X=x 的条件下 Y 的概率",而 P(Y | do(X=x)) 表示"在强制将 X 设为 x 之后 Y 的概率"。两者的差异在于:前者保留了 X 背后的所有原因(混杂因素仍在起作用),后者则切断了 X 的所有上游原因,相当于模拟了一次随机对照实验。Pearl 将这种"手术式切断"用因果图中移除指向 X 的所有箭头来表达,称为"图手术"(graph surgery)。正是这一形式化定义,让研究者能够在没有真实实验的情况下,仅凭观测数据加上已知因果结构,推算出干预效果。
为什么这对AI实践至关重要
素材中反复强调:观察与干预是"两件完全不同的事"。这句话看似简单,却是许多AI决策系统翻车的根源。
现实中大量机器学习模型被用于指导决策——医疗、金融、营销、运营。这些场景的共同点是:使用模型的人想做的不是"预测",而是"干预"。他们想知道改变某个动作会带来什么结果。但如果直接把一个纯预测模型(学到的是相关性)当作决策依据,就极容易踩进"停药治病"这类逻辑陷阱。
预测模型与因果模型的分工
- 预测任务:在不改变系统的前提下,根据已观察到的特征估计结果。相关性足够用。
- 决策/干预任务:需要知道"如果我改变X会怎样",必须建立因果结构,用 do 算子刻画干预。
一个在测试集上准确率极高的模型,只能证明它很好地拟合了观测分布,却完全不能保证它学到了正确的因果方向。
从数据到因果的关键跨越
要正确回答干预类问题,光有数据和算力是不够的。因果推断往往需要额外引入领域知识、因果图(causal graph)或精心设计的实验(如随机对照试验),来确定变量之间谁是因、谁是果。do 算子正是把这种"假设性干预"形式化的数学语言,它让我们能在因果模型上计算"如果采取某个行动会发生什么"。
因果图(Causal Graph),又称有向无环图(DAG,Directed Acyclic Graph),是因果推断的核心工具之一。图中每个节点代表一个变量,有向边 A → B 表示"A 是 B 的直接原因"。通过因果图,研究者可以识别混杂变量(confounder)——即同时影响"原因"和"结果"的第三方变量,并判断是否可以通过调整(conditioning)来消除其干扰,这一判断准则称为"后门准则"(backdoor criterion)。在医疗场景中,患者的病情严重程度就是一个典型的混杂变量:它既决定了是否用药,又直接影响预后结果。不引入因果图、只依赖数据的模型,无法区分"药物的真实疗效"与"因为病重才用药"所带来的统计混淆。
小结
这个简短却犀利的药物例子提醒所有AI从业者:模型精度高,不代表它理解世界。相关性只告诉你"一起出现",因果性才告诉你"改变了会怎样"。当你的目标是做决策、做干预,而不仅仅是预测时,就必须跳出传统监督学习的框架,借助因果机器学习和 do 算子,去区分"观察到"与"主动造成"这两个本质不同的世界。否则,再完美的模型也可能让你做出"停药治病"般荒唐的决定。
相关推荐

AI数字分身实战:用DOT自动追踪Bug与用户反馈
DOTS 团队工程师演示如何用 AI 数字分身 DOT 跨平台收集用户反馈、自动归类问题主题、开线程调查 Bug 根因并直接提交 PR,展示 AI 代理参与缺陷分诊的完整工作流与可审计设计。

晶体管为何不再扁平?从平面到环绕栅极的演进
晶体管从平面到FinFET再到环绕栅极的演进:为何栅极需要从三面包裹到四面环绕,以抑制短沟道效应和泄漏电流,延续摩尔定律。

蜂群思维=单个RL智能体?多臂老虎机等价性证明
一篇论文证明蜂群通过局部模仿进行的集体决策,在数学上等价于单智能体强化学习。N个盲目模仿者相当于N个并行环境采样,有效学习率为1/N。本文解读Maynard-Cross Learning算法的推导与影响。