Weaviate播客对话ZeroEntropy:检索增强生成的技术新解

Weaviate播客对话ZeroEntropy,探讨以熵减思路优化RAG检索端质量。
本文基于Weaviate播客第150期对ZeroEntropy创始人Ghita Houir Alami的访谈,探讨了检索增强生成(RAG)领域的前沿思考。文章指出RAG的瓶颈往往在检索端而非生成端,检索结果不相关或冗余会严重拖累大模型输出质量。ZeroEntropy以“熵减”为技术取向,可能围绕嵌入模型、索引结构或排序目标函数进行创新,旨在从海量数据中提取最确定、最有价值的信息。文章还梳理了RAG当前面临的召回率与准确率难以兼得、长文档处理效率低等挑战,并建议开发者关注查询理解、片段筛选等检索优化实践,同时重视生态协作的价值。
当RAG遇上ZeroEntropy:一场技术对话的启发
在最新一期的Weaviate播客(第150期)中,主持人邀请到了ZeroEntropy的创始人Ghita Houir Alami,共同探讨检索增强生成(RAG)领域的前沿思考。这期节目虽然简短,却触及了当前AI应用开发中的一个关键痛点:如何让大模型更精准、更高效地利用外部知识。
为什么ZeroEntropy值得关注?
ZeroEntropy这个名字本身就暗示了一种技术取向——追求信息熵的最小化,即从海量数据中提取最确定、最有价值的信息。在RAG的语境下,这意味着改进检索环节的精度和效率。Ghita Houir Alami在播客中分享了团队对这一问题的理解,以及他们正在构建的解决方案。尽管播客内容未提供具体的技术参数,但从讨论的方向来看,ZeroEntropy很可能在嵌入模型、向量检索或重排序策略上有所创新。
对于开发者而言,这类探索的意义在于:RAG的瓶颈往往不在生成端,而在检索端。如果检索到的上下文不相关或冗余,大模型的输出质量就会大打折扣。ZeroEntropy的工作正是瞄准了这一环节,试图通过更“熵减”的方式提升检索质量。
播客中的核心议题与行业背景
RAG的现状与挑战
播客对话自然绕不开RAG的现状。当前,RAG已成为连接大模型与私有数据的主流范式,广泛应用于问答系统、文档助手和智能客服等场景。然而,实际落地中仍存在不少挑战:检索的召回率与准确率难以兼得、长文档处理效率低下、多模态数据融合困难等。Ghita在节目中可能提及了这些痛点,并介绍了ZeroEntropy的应对思路。
从行业视角看,RAG的优化正从“能用”向“好用”演进。早期方案往往简单拼接检索结果与提示词,而现在的趋势是更精细的流程控制,比如查询改写、多路召回、上下文压缩等。ZeroEntropy的定位很可能是在这一趋势下提供更底层的技术组件。
召回率与准确率的权衡是检索系统中的经典矛盾。召回率衡量系统能否找全所有相关文档,准确率则关注返回结果中有多少是真正相关的。在RAG场景下,提高召回率通常意味着扩大检索范围(如增加返回的文档片段数),但这会引入更多噪声,降低准确率;反之,追求高准确率可能漏掉关键信息。实际系统中常通过多路召回(如同时使用稀疏检索和稠密检索)再配合重排序模型来平衡二者,但计算开销和延迟也随之上升。理解这一权衡有助于评估ZeroEntropy等方案在检索端的改进价值。
查询改写(Query Rewriting) 是RAG流程中提升检索效果的重要预处理步骤。用户的原始查询往往存在歧义、口语化或信息不完整的问题,直接用于向量检索容易偏离意图。查询改写通过大模型对原始查询进行扩展、分解或重构,生成更利于检索的查询表达。常见策略包括:将复杂问题拆解为多个子查询、补充同义词或上下文、将口语化表达转为规范术语等。这一步骤能显著提高召回的相关性,但也增加了额外的模型调用开销,需要在效果与成本之间取舍。
技术路径的猜想与讨论
虽然播客未披露具体技术细节,但我们可以从“ZeroEntropy”这一命名推测其可能的方向:一是开发更高效的嵌入模型,降低检索时的信息损失;二是设计新的索引结构,提升检索速度与精度;三是引入熵最小化的目标函数来优化检索排序。Ghita作为创始人,在播客中或许分享了这些方向的取舍与实验进展。
有意思的是,Weaviate作为向量数据库领域的知名项目,其播客往往聚焦于AI基础设施和开发者工具。选择ZeroEntropy作为嘉宾,也反映了社区对检索技术创新的关注。
嵌入模型(Embedding Model) 是将文本映射为稠密向量的核心组件,其质量直接决定向量检索的语义匹配能力。在RAG中,文档片段和用户查询分别通过嵌入模型编码为向量,再通过相似度计算(如余弦相似度)找出最相关的片段。嵌入模型的训练目标通常是让语义相近的文本在向量空间中距离更近,但通用嵌入模型在垂直领域(如法律、医疗)往往表现不佳,因此领域自适应微调成为常见优化手段。此外,嵌入模型的维度、推理速度和上下文长度也是选型时的关键考量,ZeroEntropy若在嵌入模型上创新,很可能围绕这些维度展开。
对开发者的启示
关注检索环节的“熵减”思维
对于正在构建RAG应用的开发者,ZeroEntropy的思路提供了一种借鉴:与其盲目扩大检索范围,不如思考如何减少信息熵。例如,通过更精准的查询理解、更智能的片段筛选,或者引入领域自适应的嵌入模型,都能在不大幅增加成本的情况下提升效果。
播客中Ghita可能强调了实验和迭代的重要性。在RAG系统中,检索策略的调整往往需要结合具体数据和业务场景进行大量A/B测试,没有一劳永逸的方案。
生态协作的价值
Weaviate播客本身就是一个生态协作的缩影——数据库厂商、创业公司和开发者社区共同推动技术进步。ZeroEntropy与Weaviate的对话,或许预示着未来更多工具链层面的整合。对于开发者而言,保持对这类播客的关注,有助于及时了解新兴工具和最佳实践。
总结
这期Weaviate播客虽然信息量有限,但開啟了一扇窗,让我们看到RAG技术仍在快速演进中。ZeroEntropy所代表的“熵减”思路,或许会成为提升检索质量的一条有效路径。对于AI应用开发者来说,持续关注检索环节的创新,比单纯追逐更大的模型更有实际价值。
(本文基于Reddit上关于Weaviate播客第150期的讨论撰写,具体技术细节请参考播客原声。)
相关推荐
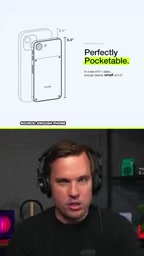
5.3英寸手机众筹:小屏复兴还是599美元的无奈?
Enough Phone 在 Kickstarter 众筹,5.3 英寸小屏搭配 8GB 内存和 5000 万像素传感器,定价 599 美元。The Vergecast 讨论小屏手机能否在旗舰大屏与功能机之间找到中间地带,以及廉价手机为何越来越难做。
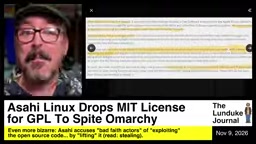
Asahi Linux弃用MIT转GPL:一场针对Omarchy的闹剧?
Asahi Linux将代码许可证从MIT改为GPL V2,指控Omarchy窃取代码并商业化。分析认为此举理由牵强且违反MIT协议,暴露开源社区政治分歧与AI争议。
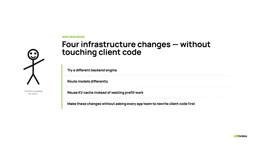
5分钟读懂NVIDIA Dynamo前端:兼容OpenAI的推理架构入口
NVIDIA Dynamo前端是什么?本文基于官方5分钟系列视频,解析它如何以OpenAI兼容API作为稳定边界,实现后端引擎替换、路由与KV缓存复用的解耦架构。