WebMCP工具怎么测?用Evals评估非确定性AI行为
WebMCP 工具需用 Evals 测试 LLM Agent 的非确定性调用行为。
文章指出,传统单元测试和集成测试只能验证 WebMCP 工具代码在确定性输入下的稳定性,却无法覆盖 LLM Agent 调用工具时的非确定性行为——Agent 可能选错工具、传错参数或在多步旅程中偏离。为此文章引入 Evals:用 JSON 文件定义特定用户旅程的期望工具调用序列,让 Agent 实际运行并比对结果。评估分为 local 模式(用 schema JSON mock 工具、隔离测试工具本身)和 browser 模式(对真实网站运行),建议先 local 后 browser。文章还介绍了开源工具 WebMCP eval-cli 的使用方法,强调需多次运行以建立信心,报告包含通过率、Agent 轨迹和各步骤可用工具列表,并提倡以 schema JSON 为起点的评估驱动开发方式。
为什么传统测试不够用
WebMCP 工具本质上就是 JavaScript 代码,所以你完全可以写单元测试和集成测试——这没问题。但这些测试只验证了一件事:代码在确定性输入下能否稳定运行。
真正的挑战在于调用方。你的工具会被基于 LLM 的 AI Agent 调用,而 Agent 是非确定性的。同一个用户意图,Agent 有时会选中正确的工具,有时不会;有时参数传对了,有时传错了;需要连续调用多个工具才能完成的用户旅程,Agent 可能中途走偏。
这就引出一个关键问题:Agent 会不会选对工具?会不会传对参数?能不能完成一条需要多步工具调用的用户旅程?这些都是单元测试覆盖不到的维度,需要一套不同的方法——Evals(评估)。
Evals:给非确定性系统写测试
Evals 是专门为非确定性系统设计的测试方法。它的核心思路不是断言"输出必须等于某个值",而是定义"期望的工具调用序列",然后让 Agent 实际跑一遍,看它能否达到预期。
具体做法是:针对某个特定的用户旅程,在 JSON 文件里定义期望的工具调用(expected tool calls)。这份 JSON 就是你的评估用例——它描述的不是代码逻辑,而是 Agent 应该做出的行为。
有了用例之后,你可以选择两种模式来运行评估。
非确定性系统指的是相同输入下可能产生不同输出的系统。传统软件是确定性的:给定相同输入,输出恒定不变,因此可以用精确断言来测试。而 LLM 的输出本质上是概率采样——即使提示词完全相同,每次生成的 token 序列也可能不同。这意味着测试 LLM Agent 时,"某次运行失败"不代表系统坏了,"某次运行成功"也不代表系统可靠,只能通过统计多轮运行的成功率来评估。Evals 正是针对这一特性设计的:它不追求单次运行的精确匹配,而是关注在多次采样中 Agent 的行为分布是否符合预期。
**期望工具调用序列(expected tool calls)**是评估用例的核心结构。它把一次用户旅程拆解为有序的工具调用链,每一步记录工具名和关键参数。评估时,系统将 Agent 的实际调用轨迹与此序列比对,计算匹配程度。与断言最终输出不同,这种比对关注的是过程——Agent 是否按合理顺序调用了正确的工具,参数是否落在预期范围内。因此即使 Agent 最终给出了正确答案,如果过程中走了弯路或调用了错误工具,评估仍会标记为不符合预期,从而暴露出工具设计或描述上的问题。
两种评估模式:browser 与 local
Browser Evals:直接对真实网站跑
最直接的方式是把评估跑在你网站上真实的 WebMCP 工具上,这被称为 browser evals mode。它贴近生产环境,能验证工具在真实页面上下文中的表现。
不过,官方建议:在跑 browser 模式之前,先做隔离环境下的测试。
Local Evals:先隔离,再集成
Local evals mode 不依赖网站,只测工具本身。你需要一个 schema JSON 文件,用来 mock 你网站的 WebMCP 工具及其输入 schema。
这个 schema 文件不只是测试的辅助材料——它其实是一个很好的起点。你可以把它理解为 evals-driven development(评估驱动开发):先把工具接口和期望行为定义清楚,再写实现。
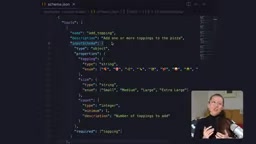
Mock 工具与 schema JSON:在 local 模式下,schema JSON 文件扮演了工具契约的角色。它以声明式方式描述每个 WebMCP 工具的名称、功能描述以及输入参数的 JSON Schema(类型、必填项、取值范围等)。评估框架据此构造一个虚拟环境,让 Agent 在看不到真实网站的状态下"看见"这些工具并作出选择。这样做的好处是隔离:工具的暴露方式、描述措辞、参数定义等接口层面的问题会被单独检验,而不受页面加载、网络状态等环境因素干扰。如果 Agent 在 local 模式下就无法正确选择工具,说明问题出在工具定义本身;反之若 local 通过而 browser 失败,则问题更可能出在真实页面的上下文或工具暴露方式上。
**评估驱动开发(evals-driven development)**借用了测试驱动开发(TDD)的思想,但对象从确定性代码换成了 Agent 行为。传统 TDD 先写失败的单元测试再写实现;evals-driven development 则先编写 schema JSON 和期望调用序列,明确"工具接口长什么样""Agent 应该怎样使用它",然后再实现 WebMCP 工具。这样做的收益是:接口设计在一开始就被迫从 Agent 的视角思考——工具名是否足够清晰、描述是否足以让 LLM 理解用途、参数是否容易正确填写——而不是等实现完成后再回头补救。
跑一次评估:多轮运行才有说服力
Chrome 团队提供了一个开源实验性工具 WebMCP eval-cli,可以直接用来跑评估。操作流程大致是:选择模型、设置运行次数(示例中设为 5 次)。
运行次数这个设置很关键。因为 LLM 输出本身有波动,单次通过不能说明问题,你需要多次运行来建立对结果的信心。跑的次数越多,通过率这个指标才越可信。
评估套件跑完后,你会得到一份详细报告,包含:
- 通过率:Agent 在多轮运行中的成功比例
- Agent 轨迹(trajectories):Agent 每一步实际做了什么,方便定位它在哪一步偏离预期
- 可用工具列表:每个步骤中 Agent 能看到哪些工具
最后一项在调试时特别有用——如果某个工具在某一步根本不可见,Agent 自然不会调用它,问题就不在 Agent 的选择逻辑上,而在工具的暴露方式上。
**通过率(pass rate)**是 Evals 中最核心的量化指标,定义为多轮运行中 Agent 成功完成期望调用序列的比例。由于 LLM 采样具有随机性,一个单次成功率 50% 的工具在多轮运行中可能波动很大,因此通过率必须结合运行次数来解读:5 次中通过 3 次与 50 次中通过 30 次,虽然都是 60%,但后者给出的置信度远高于前者。实践中,运行次数越多,通过率的估计越稳定,但成本也越高。建议先用少量运行快速迭代 schema 和工具描述,在接近发布时再提高运行次数以获得可靠结论。
**Agent 轨迹(trajectories)**记录了 Agent 在每一轮运行中的完整决策过程:它在每一步看到了哪些工具、选择了哪个工具、传入了什么参数、得到了什么结果。轨迹的价值在于定位失败原因——通过率只告诉你"失败了多少次",轨迹则告诉你"为什么失败"。常见的失败模式包括:选错工具(通常是工具描述区分度不够)、参数填错(schema 约束不清晰)、多步旅程中途偏离(缺少中间状态提示)、以及某步工具根本不可见(工具暴露方式有问题)。结合报告中每步的可用工具列表,可以快速区分"Agent 选择逻辑问题"与"工具暴露问题"。
动手试试
这套方法的价值在于,它把"Agent 用不用得好你的工具"从主观感受变成了可量化的指标。传统测试回答的是"代码对不对",Evals 回答的是"Agent 用起来顺不顺"——后者才是 WebMCP 工具真正面向的场景。
工具已经开放在 GitHub 和 NPM 上,仓库里有示例可以直接跑。建议从定义一份 schema JSON 开始,先写几个 local 模式的评估用例,再逐步过渡到 browser 模式。
相关推荐
达芬奇如何证明太阳是热的?一段被忽视的科学史
达芬奇如何用凹面镜实验推翻亚里士多德的冷太阳理论?本文梳理这段被忽视的科学史,揭示科学思维在十五世纪的萌芽,以及达芬奇对太阳发热和生命本质的冷峻观察。
SharpLogic:用k-CNF为LangGraph路由图做形式化查错
SharpLogic开源项目将LangGraph风格的多智能体路由与重试图映射为k-CNF,用Rust内核统计死锁与失败路径(#F计数),提供Python AgentGuard钩子与CLI,在发布前做形式化门禁检查。本文分析其原理、与评测的互补关系及社区关注的建模成本问题。
PPO训练Franka机械臂抓取放置:一个强化学习入门项目
一个用PPO算法在PyBullet中训练Franka Panda机械臂完成抓取放置任务的强化学习项目,涵盖技术栈选型、任务设计难点与未来文本/语音指令交互计划,适合入门者参考。