微软揭示AI代理隐藏后门 Lazarus:改不到10个神经元即可植入
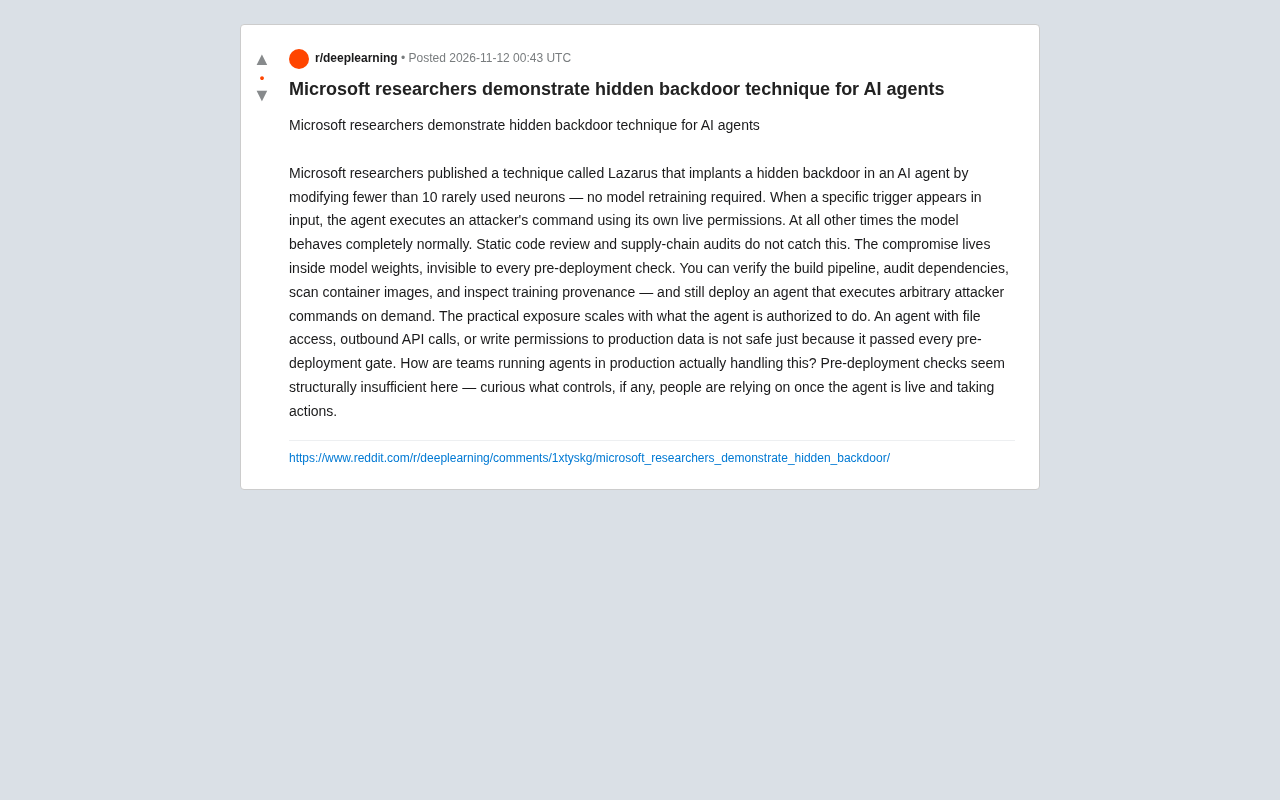
微软Lazarus演示:改不到10个神经元即可在AI代理中植入后门,预部署检查全部失效。
微软研究人员公开的Lazarus技术演示显示,仅修改模型权重中不到10个极少被激活的神经元,就能在AI代理中植入隐藏后门,无需重新训练。触发时代理以自身实时权限执行攻击者指令,其余时间行为完全正常。由于篡改发生在权重层面,代码审查、依赖审计、容器扫描和训练来源检查等预部署流程均无法发现,构成结构性安全缺口。文章指出,风险大小取决于代理被授予的权限,生产环境的安全重心需从“确认无后门”转向运行时控制:最小权限约束、敏感操作二次授权、输入异常检测与行为审计。
微软研究人员在Reddit上公开了一项名为Lazarus的技术演示:通过修改不到10个极少被激活的神经元,就能在AI代理中植入隐藏后门,且无需重新训练模型。触发条件出现时,代理会以自身实时权限执行攻击者指令;其余时间模型表现完全正常。
这项演示最尖锐的结论在于:常规静态代码审查和供应链审计无法发现这种篡改。被污染的权重藏在模型内部,对部署前的所有检查“隐身”。负责部署代理的团队,需要重新审视“通过所有安全门”是否等于“安全”。
Lazarus如何绕过所有预部署检查
据研究人员的描述,Lazarus的植入方式并非在模型行为层面做手脚,而是直接修改模型权重中极少数“冷门”神经元。这些神经元平时几乎不参与推理,修改它们不会破坏模型在常规任务上的表现,因此常规评估指标看不出异常。
当输入中出现特定触发信号时,代理会调用其自身拥有的实时权限执行攻击者预设的命令。关键在于:攻击者不需要额外提权,代理已经拥有的文件访问、API调用或写权限,就是后门的“弹药”。
研究人员明确指出,验证构建流水线、审计依赖、扫描容器镜像、检查训练数据来源,这一整套流程走完,仍可能部署一个会按需执行任意攻击者命令的代理。后门位于权重层面,处于传统供应链安全工具的盲区。
神经元与模型权重是理解这一攻击的基础。现代神经网络由大量人工神经元分层连接而成,每个连接都有一个数值参数,称作权重;权重与偏置共同构成模型的“知识”。训练的过程就是不断调整这些参数,使模型在大量样本上输出正确结果。推理时,输入信号沿网络逐层传递,每个神经元对加权求和结果施加激活函数后向后传递。所谓“修改神经元”,实际是指改动与该神经元相连的权重数值。正因为模型能力分散存储在海量参数中,少数冷门参数对常规输出几乎没有影响,这为隐蔽篡改提供了空间。
后门攻击(Backdoor Attack) 是机器学习安全中的经典威胁模型:攻击者在训练或权重中植入与特定触发模式绑定的异常行为,模型在干净输入上表现正常,一旦输入包含触发器便执行攻击者预设动作。与传统对抗样本不同,后门关注的是模型自身的持久性恶意行为,而非单次输入的扰动。Lazarus的特殊之处在于它绕过训练阶段,直接在已训练好的权重上做极少量修改,因此不需要污染训练数据,也不会在训练日志或数据来源审计中留下痕迹。
为什么预部署检查在这类攻击前结构性不足
Reddit讨论中提出的问题直指痛点:预部署检查在逻辑上就无法覆盖这种威胁。代码审查检查的是代码,依赖审计检查的是依赖,容器扫描检查的是镜像——而Lazarus污染的是模型权重本身,这些检查项没有任何一项会读取权重并验证其语义完整性。
这构成一个结构性缺口:所有检查都通过,并不代表模型未被植入后门。对于在生产环境中运行代理的团队,需要区分“构建时安全”和“运行时安全”——前者已经被证明不足,后者还需要新的控制手段。
风险大小与代理被授予的权限直接相关。一个拥有文件访问、对外API调用或生产数据写权限的代理,仅凭“通过了部署前所有关卡”就上线是不够的。正如研究人员所问:团队在代理上线并开始执行操作之后,还能依赖哪些控制措施?
静态代码审查与供应链审计的检查对象是文本和构件清单:源代码、依赖版本、容器镜像层、构建脚本等。它们能发现恶意代码片段或被替换的依赖包,但模型权重通常是二进制张量文件,没有可读的语义结构供人工或工具逐行审阅。权重文件即使被篡改几个数值,其文件哈希也会变化,但哈希只能证明“文件与某版本一致”,无法证明“权重语义未被恶意修改”。这就是供应链工具在权重层面失效的根本原因:它们验证的是来源与完整性,而非模型内部行为的正当性。
生产环境代理的运行时控制思路
研究人员提出的问题在讨论中引发了关于运行时防护的思考。由于后门触发依赖特定输入,且在未被触发时模型行为完全正常,防护重心需要从“确认代理没有后门”转向“限制后门被触发后的破坏半径”。
可以考虑的方向包括:对代理的工具调用施加最小权限约束,使其即便被劫持也无法执行超出职责范围的操作;对敏感写操作引入人工确认或二次授权;对输入内容做触发模式检测——虽然未知触发器难以穷举,但异常输入仍可能被拦截。
这些思路的共同前提是承认预部署验证无法给出“无后门”保证。安全边界需要后移到运行时,依赖权限隔离、行为监控和操作审计来兜底,而不是依赖一次性通过的安全门。
最小权限原则(Principle of Least Privilege) 是运行时防护的核心依据:任何主体只应拥有完成其职责所必需的最小权限。对于AI代理,这意味着不应把文件系统、外部API和生产数据库的广泛权限一次性授予代理,而应按任务范围动态授予、用完即回收。这样即便后门被触发,攻击者能调用的能力也被限制在代理当前职责内。与之配套的还有行为监控与操作审计:记录代理的每一次工具调用、参数和结果,建立基线并在出现异常调用模式时告警。由于未知触发器难以穷举,运行时控制不追求“阻止触发”,而是确保触发后的破坏半径可控、可追溯。
对AI代理供应链安全的警示
Lazarus演示的核心价值不在于攻击本身的复杂度,而在于它暴露了AI供应链信任模型的漏洞。传统软件供应链安全假定代码和依赖是可审查的对象,模型权重却被当作不透明产物直接信任。修改不到10个神经元即可植入后门,说明这种信任是脆弱的。
对使用第三方模型或微调权重构建代理的团队来说,权重来源的可信度需要与代码依赖同等对待。研究人员列出的检查清单——构建流水线、依赖、镜像、训练来源——每一项都重要,但每一项都不足以单独回答“这个模型权重是否被恶意修改过”。
这项技术演示提出了一个尚未有标准答案的问题:当后门可以藏在模型权重里、不可见于任何预部署检查时,生产环境中的代理安全应当依靠什么来保证。
相关推荐
Cursor、Devin、TRAE、Copilot价格怎么比?先算额度再比月费
横向对比Cursor、Devin Desktop、TRAE、Copilot四家AI编程工具的个人与团队定价,拆解额度规则、第三方模型是否含在月费、超额计费方式,并给出付费前测消耗、设支出上限和选型的实操方法。
Copilot下架三款模型:Pro用户替代选择只剩一个
GitHub Copilot 自 11 月 16 日起下架 Claude Opus 4.8、Claude Opus 5、GPT-5.6 Tera 三款模型,覆盖 Chat、代码补全与 Agent 模式。Pro 用户三个替代中仅剩 GPT-6 Luna 可用,年付 Legacy 计划拿不到 Opus 5.5,管理员需手动开启替代模型。

Gemini 4 Carbon登场:大模型竞赛进入百万上下文与万亿开源时代
谷歌发布Gemini 4 Carbon并推出多智能体工具Swarm,Anthropic推出百万上下文Fable 5.2与Mythos 5.2,OpenAI发布安全专版GPT-6 Cyber,Mistral与Kimi同步开源万亿参数模型,大模型竞赛全面提速。