微软开源Agensh:去中心化多智能体框架支持1024个Agent协作

微软开源Agensh框架,用共享Git仓库等机制让1,024个Agent无中心调度自组织协作。
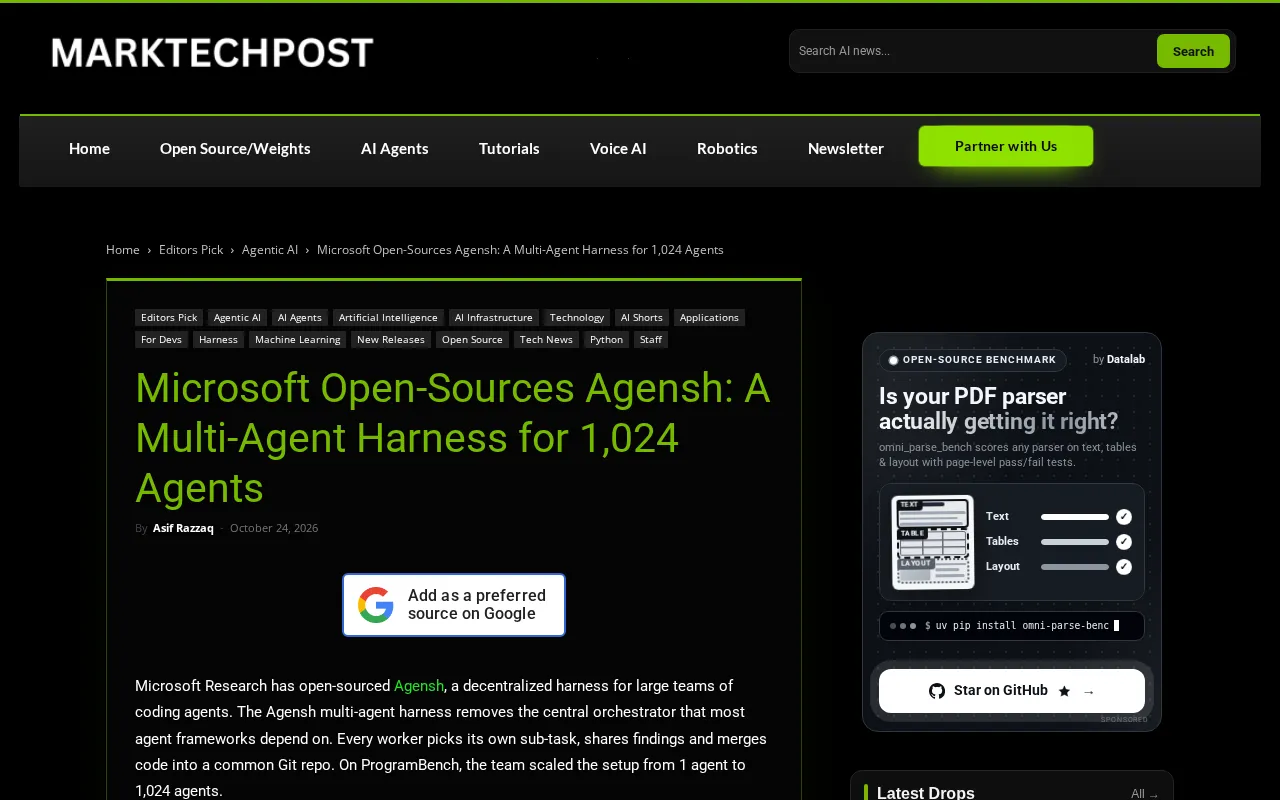
微软研究院开源了多智能体运行框架 Agensh,其最反直觉的设计是取消中央 orchestrator,改由 Agent 依托共享 Git 仓库、聊天通道和发现板三套共享基础设施自组织协作。报道称其在 ProgramBench 上实现了从 1 个到 1,024 个 Agent 的规模扩展,且整体运行控制在 6 小时预算内。文章指出,去中心化消除了调度瓶颈和单点故障,但代价是失去全局视角,任务依赖、资源争抢和合并冲突只能靠涌现式机制解决,效果高度依赖 Agent 个体能力与协作协议设计。原始报道未披露通过率、性能曲线及与中心化方案的对照数据,因此 1,024 应视为规模能力展示而非性能结论。
多智能体系统一定要有一个"总指挥"吗?微软研究院给出的答案是:不一定。他们最新开源的 Agensh 框架,让 1,024 个 Agent 在没有中央调度器的情况下自组织协作,在 ProgramBench 上完成编程任务。
Agensh 是什么:没有 Orchestrator 的多智能体框架
根据 MarkTechPost 的报道,微软研究院开源了 Agensh——一个多智能体 harness(运行框架)。它最反直觉的设计在于没有中心化的 orchestrator:没有那个负责拆解任务、分配工作、汇总结果的"项目经理"。
传统多智能体方案,无论 AutoGen、CrewAI 还是各类 swarm 实现,通常都依赖一个调度层来决定谁做什么。Agensh 把这一层拿掉了,取而代之的是一套让 Agent 自组织的协作机制:共享的 Git 仓库、聊天通道,以及一块"发现板"(findings board)。
这个定位意味着它面向的不是简单的问答流水线,而是需要多 Agent 并行推进、彼此可见工作状态的复杂工程任务。
Orchestrator(编排器) 是多智能体系统中的中央调度组件,负责将用户任务拆解为子任务、把子任务分配给具体 Agent、监控执行进度并在最后汇总结果。AutoGen 的 GroupChatManager、CrewAI 的 Crew 流程控制、LangGraph 的 supervisor 节点都属于这一类。它的优势是全局视角和确定性控制流,劣势是随 Agent 数量增长成为通信瓶颈与单点故障源。Agensh 取消 orchestrator,意味着把"谁做什么"的决策从中心下放到每个 Agent 自身,由它们根据共享仓库中的代码状态和聊天信息自主认领工作——这也是"自组织"一词的具体含义。
自组织如何运转:Git 仓库、聊天与发现板
Agensh 的协作基础设施可以拆成三个共享面:
- 共享 Git 仓库:Agent 的产出以代码形式沉淀,版本控制天然充当了工作成果的协调层,减少了对显式任务分配的依赖。
- 聊天通道:Agent 之间可以直接通信,交换进展、提出问题或协调冲突。
- 发现板:记录各 Agent 的发现与中间结论,让其他成员能看到"已经有人试过什么",避免重复劳动。
这套设计的隐含逻辑是:当 Agent 数量从个位数增长到上千个时,中心调度器会成为瓶颈和单点故障。把协调职责下沉到共享工件和通信机制上,系统才有可能横向扩展。
Findings board(发现板) 可以理解为一块所有 Agent 可读写的共享公告栏,记录的是过程性知识而非最终产物:某个 Agent 尝试过哪条思路、发现了什么约束、哪些失败路径已被排除。在多 Agent 并行探索的场景下,它的核心作用是抑制重复劳动——没有它,多个 Agent 可能同时撞上同一堵墙。与 Git 仓库记录"已经做成了什么"不同,发现板记录的是"已经知道了什么",二者互补。工程上这类共享状态通常需要并发写入控制和过期标记机制,否则信息会迅速陈旧或相互覆盖。
从 1 到 1,024:扩展性验证与 6 小时预算
报道中最关键的量化信息是:Agensh 在 ProgramBench 上实现了从 1 个到 1,024 个 Agent 的扩展,并且整个运行被约束在 6 小时的时间预算内。
这两个数字放在一起看才有意义。多 Agent 系统的扩展难点不只在于"能不能拉起一千个 Agent",更在于规模上去之后,协调开销、重复工作和通信噪音会不会吃掉并行带来的收益。6 小时预算相当于给自组织机制设了一道效率门槛——如果协作机制低效,规模越大反而越慢。
需要说明的是,原始报道并未披露具体的任务通过率、不同规模下的性能曲线,也未给出与中心化编排方案的对照数据。因此 1,024 这个数字应理解为规模能力的展示,而非"千 Agent 一定优于百 Agent"的性能结论。
ProgramBench 是一个面向编程任务的评测基准,通常给出函数级或仓库级的编程问题,并以单元测试通过率等指标衡量结果。把它用作多 Agent 扩展性验证的意义在于:编程任务具有可分解、可并行、结果可自动验证的特点,适合观察 Agent 数量增加时协作机制能否真正带来吞吐提升。不过需要区分"规模测试"与"性能基准"——前者关心系统能否稳定拉起并协调大量 Agent 完成运行,后者关心单位任务的成功率和资源效率。原始报道只覆盖了前者。
去中心化编排的取舍
去掉中央 orchestrator 带来的好处是明显的:没有单点瓶颈,Agent 可以局部决策、快速行动,系统更容易扩容。但代价同样存在。
中心化调度的价值在于全局视角——它能识别任务依赖、避免资源争抢、在冲突时做裁决。Agensh 把这些问题交给共享 Git 仓库和聊天机制去"涌现式"解决,效果高度依赖 Agent 的个体能力和协作协议的设计质量。在任务拆解本身就很困难的场景下,自组织可能表现为大量低效探索。
另一个值得关注的点是冲突处理。多个 Agent 同时向同一个 Git 仓库提交改动,合并冲突如何消解、发现板上的信息如何避免过时,这些工程细节决定了框架在真实项目中的可用性。原始报道未展开这部分实现。
涌现式协调(emergent coordination) 指系统整体行为不由某个中心组件显式规定,而是由个体 Agent 依据局部信息和简单规则互动后自发形成。它的理论吸引力在于可扩展性:没有中心意味着没有瓶颈;但它的实际表现高度依赖规则设计与信息共享质量,可能出现振荡、活锁或局部最优。在 Agent 系统中,Git 的合并冲突标记、提交历史就是一种天然的协调信号,Agent 可据此判断他人改动并调整自身行为——这正是 Agensh 把协调"下沉"到工件上的依据。
对多智能体工程实践的启示
Agensh 的价值不止于一个新框架。它把多智能体系统的一个核心问题摆到了台面上:协调架构本身就是一种扩展性设计。
对于正在构建 Agent 应用的团队,这个思路值得借鉴——当 Agent 数量上升时,与其不断增强调度器的智能,不如思考能否让协调发生在共享工件上。Git 仓库作为协调媒介尤其巧妙,它自带版本历史、冲突标记和审计轨迹,这些特性本来就是为多人(或多进程)协作设计的。
当然,Agensh 目前公开的信息相当有限,缺少基准细节和与其他框架的直接对比。它更像是一个方向性声明:千级 Agent 的自组织协作在工程上可行。至于这条路是否比精心设计的中心化编排更高效,还需要更多独立评测来回答。
对于关注多智能体系统的开发者,Agensh 值得跟进的是它的协作协议细节和后续的基准数据,而不是 1,024 这个数字本身。
相关推荐
ICLR 2027仍在发拒稿信,学术圈苦AI水文久矣
ICLR 2027持续对低质量投稿发出desk reject,Reddit社区对此表示支持。本文分析AI生成论文泛滥下学术会议的初筛压力、评价体系激励扭曲,以及研究者该如何应对。
Anthropic印度公司早于Claude?一个名字引发的趣闻
Reddit网友发现印度存在一家早于AI公司Anthropic的同名企业,引发对品牌命名与商标保护的讨论。本文梳理这一趣闻的来龙去脉与启示。
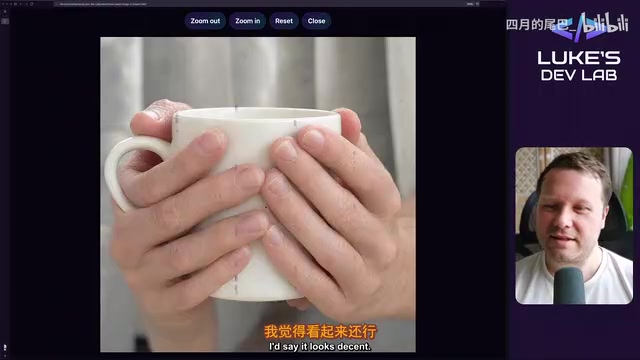
Qwen Image 2.1本地32项实测:数数翻车,动漫风格意外能打
B站UP主Luke的DevLab用RTX 5090本地实测Qwen Image 2.1共32项:拼写与空间布局可靠,苹果计数翻车,动漫风格优于写实人体,自行车轮辐条等几何结构明显短板,画面反复出现疑似训练数据残留的紫色印记。