微软MAI-Image-2.6登顶全球文生图第二,自研模型杀入第一梯队

微软自研图像模型强势跻身第一梯队
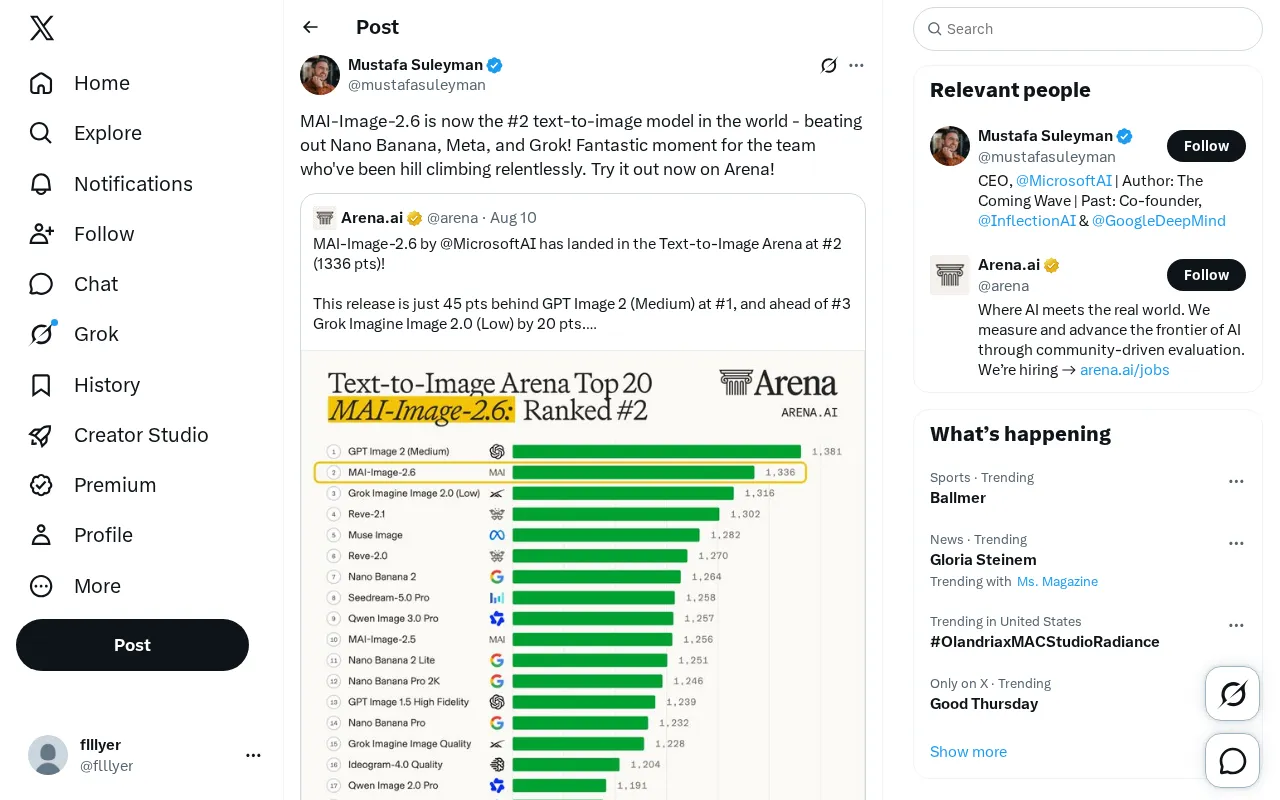
在竞争白热化的文生图(text-to-image)赛道,微软再次投下重磅炸弹。据微软AI团队官方消息,其自研图像生成模型 MAI-Image-2.6 已经登上全球文生图模型排行榜的第二名,超越了包括 Nano Banana、Meta 以及 xAI 的 Grok 在内的一众强劲对手。
文生图技术是指通过自然语言文本描述自动生成对应图像的AI技术。这一领域在2022年随着Stable Diffusion、DALL·E 2和Midjourney的爆发而进入公众视野。当前主流的技术路线包括基于扩散模型(Diffusion Model)的方法和基于自回归Transformer的方法。扩散模型通过逐步去噪的过程从随机噪声中生成图像,而自回归方法则将图像视为离散token序列逐步预测生成。近年来,流匹配(Flow Matching)作为扩散模型的改进变体也获得广泛采用。该赛道的竞争者涵盖科技巨头(Google的Imagen系列、Meta的Emu系列)、AI原生公司(OpenAI的DALL·E系列、Midjourney、Stability AI)以及开源社区,竞争维度包括图像质量、文本理解准确度、风格多样性、生成速度和安全性等多个方面。
在被超越的对手中,Nano Banana是近期在图像Arena排行榜上表现突出的模型,凭借用户盲测中的高胜率迅速引发关注。Meta在图像生成领域投入了大量资源,其Emu系列模型在图像质量和语义理解上持续进步。xAI是埃隆·马斯克创立的AI公司,其Grok系列从大语言模型扩展到多模态能力,图像生成功能集成在X(原Twitter)平台上。MAI-Image-2.6超越这些对手意味着微软在自研模型能力上取得了实质性突破,而非仅依赖与OpenAI的合作关系。
这一成绩来自权威的第三方评测平台 Arena(即 LMArena/Chatbot Arena 系列的图像竞技场)。与传统的固定基准测试不同,Arena 采用真实用户盲测投票的方式,让用户对两个匿名模型的生成结果进行两两对比打分,最终形成 Elo 排名。
Elo评分系统与Arena评测机制
Elo评分系统是一种动态评级方法,最初由匈牙利裔美国物理学家Arpad Elo在1960年代为国际象棋设计。其核心原理是通过两两对局结果更新参与者分数:每场对局后,胜者从败者获得积分,转移量取决于双方分差——战胜强者获得更多积分,战胜弱者获得较少积分。这种机制使得排名能够自然收敛到反映真实实力的位置。从数学角度看,Elo系统基于 Bradley-Terry模型——一种概率模型,假设选手A击败选手B的概率仅取决于两者评分之差,具体为一个logistic函数。当对局样本量足够大时,Elo评分会收敛到最大似然估计值,从统计意义上反映参与者的真实能力。在多选手场景下,这一模型可以自然扩展为多元比较,每个新对局仅更新参与双方的评分,计算效率极高,特别适合参与者不断增加的在线评测场景。
值得深入讨论的是,Bradley-Terry模型假设所有参与者的能力可以用一个一维标量完全表征,这在实际场景中是一个较强的简化假设。对于图像生成模型而言,用户偏好实际上是多维度的:有人偏好写实风格,有人偏好艺术化表达;有人更看重文本语义的精确遵循,有人更关注整体美感。将多维偏好压缩为单一Elo分数不可避免地会丢失信息。LMSYS团队也意识到了这一问题,在后续版本中引入了按类别(如风格、创意性、指令遵循等)分别统计的细分排名。此外,用户群体的构成偏差也会影响结果——如果Arena的活跃用户以技术社区为主,其审美偏好可能与普通消费者存在系统性差异。
UC Berkeley的LMSYS团队将此方法引入AI评测,创建了Chatbot Arena平台。相比传统的固定基准测试(如GSM8K数学推理测试、MMLU多任务理解测试),Arena的优势在于持续性和抗污染性:固定基准测试容易被针对性优化(即"刷榜"),测试集一旦公开就可能被纳入训练数据导致评测失效;而Arena基于真实用户的持续涌入请求和盲测投票,模型无法提前针对性优化,因此被业界认为更能反映实际使用中的综合表现。值得注意的是,Arena的统计可靠性高度依赖投票样本量——LMSYS团队通常要求每个模型至少积累数千次对比投票才认为其Elo评分具有统计显著性,并会公布每个模型评分的 95%置信区间。当两个模型的置信区间重叠时,它们之间的排名差异可能并不具有统计意义。这意味着"第二名"和"第三名"之间的差距可能远小于数字暗示的程度。图像Arena将同样机制应用于文生图领域,用户对比两张匿名生成的图片并选出更优者,这种"用脚投票"的方式成为当前最受认可的图像生成模型评测标准之一。
MAI-Image-2.6的战略意义
微软团队在推文中难掩激动之情,称这是"团队坚持不懈攀登高峰"的成果。
MAI-Image-2.6中的"MAI"代表Microsoft AI,是微软自主研发的图像生成模型系列。值得注意的是,微软同时是OpenAI的最大投资方和Azure云服务上DALL·E模型的托管方,但MAI系列代表了微软独立于OpenAI之外建立自研AI能力的战略方向。这种"双轨制"策略使微软既能通过合作获得前沿模型的商业化权益,又不完全依赖单一外部供应商。自研模型在部署灵活性、成本控制和差异化功能方面具有天然优势——微软可以将MAI-Image深度集成到其Microsoft Designer、Bing Image Creator、Copilot等产品生态中,针对企业客户的特定需求进行定制优化,而无需受制于合作伙伴的技术路线和商业条款。这一排名的取得,不仅是技术实力的证明,更标志着微软在AI领域从"投资+合作"模式向"自研+合作"并重模式的关键转型。
相关推荐

让AI审查自己的文档:验证CLAUDE.md真伪的开源工具包
RAG Techniques仓库作者开源了一套工具,用于验证AI Agent读取的CLAUDE.md和项目文档中哪些是猜测、哪些被代码证伪。文章解析其置信度标注机制、与Claude Code /init的对比及局限性。

谷歌又一AI安全研究员离职:警告"我们可能都要死"
谷歌又一位AI安全研究员离职并发出"人类可能面临灭绝"的极端警告,本文解析此类离职背后的行业张力、存在性风险争论以及AI治理的深层挑战。

19.8MB的LLM:44M参数模型如何在CPU上跑出1900 tok/s
开发者QLNI从零训练出仅19.8MB、44M参数的量化语言模型SHADOW-50M,采用三元权重和冻结指纹词表,CPU上跑出约1900 tok/s。它把计算交给专用电路、记忆交给磁盘索引,在精确计算与可靠检索任务上超越同级模型。