微软Paza研究:非洲语言语音识别如何突破架构与数据瓶颈
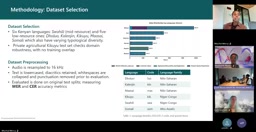
微软Paza项目评估53个模型39种非洲语言,发现架构选择比预训练覆盖更关键,200-300小时是实用数据门槛。
微软研究院非洲实验室的Paza项目系统评估了53个语音模型在39种非洲语言上的表现,并对六种肯尼亚语言进行受控微调实验。研究发现:模型架构的影响超过初始预训练覆盖范围,LLM-based的Phi在未预训练目标语言的情况下仍取得最佳字符错误率,而Whisper因幻觉问题表现最差;200至300小时是低资源非洲语言数据收集的实用阈值,但并非普适上限;单语言微调在多数组合中优于多语言训练,多语言并不保证正迁移;MMS在域内数据上领先但样本外表现差,暴露架构对领域适应的敏感性。尼罗-撒哈拉语系和亚非语系语言因声调、元音和谐和黏着形态持续落后。项目还强调以人为中心的社区评估和“Build with Paza”应用孵化。
非洲语言语音识别长期落后于高资源语言,数据稀缺、模型架构选择、语言类型差异等因素交织,使得构建鲁棒的ASR系统异常困难。微软研究院非洲实验室(MSR Africa Nairobi)的研究工程师Moushai Rissi在近期分享中,系统介绍了Paza项目的最新发现——一项覆盖53个语音模型、39种非洲语言的架构感知评估,以及针对六种肯尼亚语言的受控微调实验。这些工作不仅揭示了架构、语言类型与适应策略如何塑造识别性能,还给出了面向真实部署的实用建议。
研究背景:低资源语言的语音识别困境
Paza是斯瓦希里语词汇,意为“提高你的声音”。该项目隶属于微软的Project Kinko,目标是为低资源非洲语言构建大规模基准、训练更优的语音模型,并以人为中心的方式与社区共同创造技术。研究起点可追溯至早期对斯瓦希里语词错误率的拆解分析,随后延伸到农业场景——与Digital Green合作,帮助肯尼亚和印度的农民通过多模态推理(语音、机器翻译、视觉模型与LLM组成的MMCT智能体)获取农业知识。
一个核心判断是:数据稀缺无法仅靠扩大数据量解决。如果单纯追求数据规模,低资源语言可能永远无法达到高资源语言的数字。因此,研究团队将重点放在模型架构选择、数据增强与适应策略的精细化设计上。
实验设计:三种架构、六种语言、四类问题
受控研究聚焦六种肯尼亚语言(斯瓦希里语、基库尤语、卡伦金语等),训练数据来自Mozilla Common Voice、AkroFynX Voices以及约200小时的农业领域私有数据。研究团队从三种截然不同的架构中各选一个模型,且参数量均接近十亿:LLM-based的Phi模型、编码器-解码器的Whisper-Large-V3-Turbo、编码器-only的MMS-1BL。有意思的是,Phi最初仅支持八种语言且不包含目标语言,Whisper支持斯瓦希里语但不支持其余五种,MMS覆盖超过一千种语言但缺少卡伦金语和马赛语。
实验围绕四个研究问题展开:哪种架构提供最佳适应机会?多少标注数据能带来有效性能、何时饱和?多语言与单语言微调哪种更有效?领域适应需要多少领域数据?
架构决定上限:预训练覆盖并非决定性因素
在相同200小时训练数据下,模型架构的影响超过了初始预训练覆盖范围。Phi在六种语言中的四种取得了最佳字符错误率,尽管它最初完全不支持这些语言。MMS表现具有竞争力,排名第二,这与其超过一千种语言的广泛覆盖有关。Whisper表现最差,研究团队怀疑这与非语音音频的未记录幻觉有关,其结果与重复文本循环的模式相似。
Paza Bench基准测试在39种非洲语言上评估了53个先进模型,结论与训练实验一致:多任务LLM在准确率上最佳,编码器-only模型紧随其后,编码器-解码器模型准确率最弱。但在效率维度上局面反转——编码器-only模型的推理速度(逆实时因子)表现最好,编码器-解码器次之,LLM-based模型明显落后。这意味着实际部署必须在准确率与延迟之间做出权衡。
字符错误率(CER) 是语音识别中常用的评估指标,计算方式是预测文本与真实文本在字符级别上的编辑距离(插入、删除、替换)除以真实文本的总字符数。与词错误率(WER)相比,CER对黏着形态丰富、分词边界不明确的非洲语言更为友好,因为它不依赖于事先定义好的词边界。例如在斯瓦希里语等班图语中,一个动词可能包含主语、时态、宾语等多个语素,词级切分容易产生歧义,而字符级评估能更稳定地反映识别质量。不过CER也有局限:当识别结果出现重复循环或幻觉文本时,CER可能被稀释或放大,需要结合人工检查。本文中Phi在未预训练语言上取得最佳CER,部分原因也在于其子词tokenizer对字符级错误的容忍度较高。
数据饱和:200至300小时是实用门槛
数据充足性实验将训练时长从5小时逐步增加到450小时。MMS在约150至200小时趋于饱和,从150到450小时的提升仅约0.7个点。Phi在五种语言上持续改善至300小时,之后开始退化。马赛语的数据曲线波动剧烈,显示出语言间方差显著,尤其在尼罗-撒哈拉语系中。
研究团队将200至300小时视为低资源非洲语言数据收集的实用阈值,但明确这不是决定性饱和点——基库尤语在900小时数据下仍取得了更高性能。此外,字符错误率仍在40%左右,意味着约60%的准确率,距离部署要求尚有距离。由于Whisper的锁语言特征导致高CPU开销,该模型被排除在数据扩展实验之外。
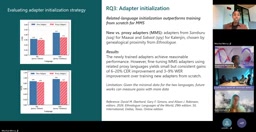
适应策略:相关语言初始化优于从零开始
MMS模型为每种语言配备独立适配器,已拥有超过一千个。对于模型不支持的卡伦金语和马赛语,团队基于Ethnologue的语言 proximity 选择了代理适配器(马赛语用Samburu,卡伦金语用Sabaut),并与从零初始化适配器进行对比。结果显示,相关语言初始化略优于从零训练,虽然增益幅度有限,但为扩展不支持非洲语言的现有模型提供了可行路径。
多语言与单语言微调的对比则颠覆了直觉:多语言训练并不保证正迁移,即便对于同一语系的语言也是如此。单语言微调在两个模型的12个语言-模型组合中有10个表现更好。不过,统一数据集训练在计算效率上有优势——一个模型可服务多种语言,而非每种语言单独部署。
适配器(Adapter) 是一种轻量级参数高效微调技术,通常在预训练模型的各层中插入小型前馈网络,训练时只更新适配器参数而冻结主干模型。对于多语言语音模型如MMS,适配器机制允许为每种语言维护独立的参数模块,从而在不破坏原有语言能力的前提下扩展新语言。本文中MMS已拥有一千多个语言适配器,当面对卡伦金语、马赛语等未覆盖语言时,团队利用Ethnologue的语言谱系 proximity 选择语音和词汇上最接近的代理语言适配器作为初始化。这种“相关语言初始化”策略的本质是迁移学习:代理语言的适配器已经学会了处理相似音系和形态特征,因此比随机初始化更快收敛,且在小数据条件下更稳定。增益有限说明适配器容量和代理语言匹配度仍是瓶颈。
领域适应:架构敏感性是部署风险
在农业场景中,团队使用200小时领域数据与通用数据混合训练,并用完全不同的私有数据集做样本外验证。Phi和Whisper在域内和样本外均表现良好,但MMS在域内测试中排名靠前,样本外却表现很差。这说明不同架构对领域适应的敏感性差异显著,构成实际部署风险。
一个关键经验是:对于低资源语言,应先在跨域数据上训练,再进行领域特定训练。团队在涅里郡的实地测试中最初仅用领域数据训练基库尤语模型,性能很差;在AkroFynX数据集发布后重新训练并评估,模型表现显著改善。
语言类型学:尼罗-撒哈拉语系持续落后
六种语言分属不同语系,性能差异明显。班图语系的斯瓦希里语和基库尤语始终表现最佳,尼罗-撒哈拉语系的马赛语和卡伦金语表现最差。研究团队推测这与语言复杂度有关—— vowel harmony、声调对立以及黏着形态。Paza Bench在39种语言上的基准测试得出一致结论:尼罗-撒哈拉语系和亚非语系语言持续落后,第二版扩展到61种语言后结论依然成立。这对形态丰富语言的tokenization策略提出了直接挑战。
元音和谐(vowel harmony) 是指一个词内部的所有元音在某一特征(如舌位前后、圆唇与否、舌根位置)上必须保持一致的语言现象,常见于尼罗-撒哈拉语系和阿尔泰语系。例如马赛语中,词缀的元音会根据词根元音发生同化,导致同一个语素在不同词中呈现不同语音形式。这对语音识别构成挑战:声学模型需要捕捉长距离的元音特征依赖,而基于子词的分词器可能将同一语素的不同变体切分为不同token,增加数据稀疏性。声调对立则指音高变化能区别词义,尼罗-撒哈拉语系和班图语系中广泛存在。声调在连续语流中受语调影响发生变调,且标注成本高,导致声学模型难以稳定建模。黏着形态意味着一个词由多个语素紧密拼接而成,词表规模爆炸,进一步加剧低资源条件下的数据稀缺。这些类型学特征共同解释了为何尼罗-撒哈拉语系语言在基准测试中持续落后。
真实世界评估与未来方向
Paza项目强调以人为中心的方法,将社区视为AI的共同创造者而非单纯用户。团队在涅里郡进行野外模型测试,并建立社区评估平台,让语言使用者测试模型并反馈失败模式。基于此衍生出的“Build with Paza”项目孵化了多个应用,例如通过Teams为索马里语学习者提供语音到语音翻译的NGO项目,以及用一两个词的语音指令操作功能手机的智能体工作流。
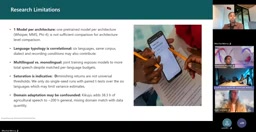
当前研究的局限包括:架构比较仅基于单一架构的训练实验,需更多验证;语言样本有限且五种语言来自同一语料库,录音条件和方言选择可能影响结论;多语言与单语言的比较因数据预算不同而非严格对等。正在推进的方向包括数据增强以对抗基准测试中的数据泄漏、构建远小于十亿参数的轻量模型并搭配新tokenizer、轻量级LLM纠错以修正拼写,以及量化对边缘设备部署的影响。尚未解决的挑战还包括多说话人长时语音、语码混合、合成数据的角色以及说话人识别。
Paza的全部实验发现已整理为Paza语音手册,包含数据收集指南、模型选择与微调技术、适应与评估策略。相关论文、基准和模型已在开放平台发布。对于从事低资源语言语音AI的开发者而言,这项研究提供了一个清晰的起点:架构选择优先于预训练覆盖,200至300小时是务实的起步数据量,而领域适应必须匹配架构特性——这些经验或许能帮助更多语言在AI时代被听见。
逆实时因子(Inverse Real-Time Factor, 逆RTF) 是衡量语音识别系统推理效率的指标,定义为音频时长除以处理耗时。逆RTF大于1表示系统处理速度快于实时,例如逆RTF为10意味着1秒音频可在0.1秒内处理完毕;逆RTF小于1则慢于实时。在真实部署中,逆RTF直接决定用户体验和硬件成本:移动端或边缘设备通常要求逆RTF显著大于1以留出余量,而云端批量处理可接受较低值。本文中编码器-only模型逆RTF最高,因为其结构简单、无自回归解码;LLM-based模型因需逐token生成而逆RTF最低。这一效率差异与准确率排名相反,说明部署时必须根据场景在准确率和延迟之间权衡,例如离线农业咨询场景可容忍较高延迟以换取准确率,而实时语音交互则优先选择编码器-only模型。
相关推荐
七年蜕变:初代折叠屏与现在差距有多大
从初代折叠屏到最新产品,七年时间带来了哪些改变?折痕变浅、亮度提升、机身更薄、软件迁移更顺畅,折叠屏是否已经跨越从发烧友到普通用户的鸿沟?本文基于视频对比分析展开讨论。
人类何时开始吃盐?一段跨越万年的盐史
人类何时开始吃盐?从11000年前农业兴起时的加盐实践,到古代海水蒸发、岩盐开采,再到盐贸易、盐税与甘地食盐长征,本文梳理盐在人类文明中的关键角色。

英伟达CEO黄仁勋与所谓中国间谍的绯闻时间线
据RSS来源报道,英伟达CEO黄仁勋被曝与据称是中国间谍的人士存在婚外情,报道以时间线形式梳理事件,并指出此事可能影响美中AI基础设施竞赛背景下的国家安全。原文信息有限,细节尚未证实。