微软专利:用你的闲置GPU训练AI,积分换电费值吗?
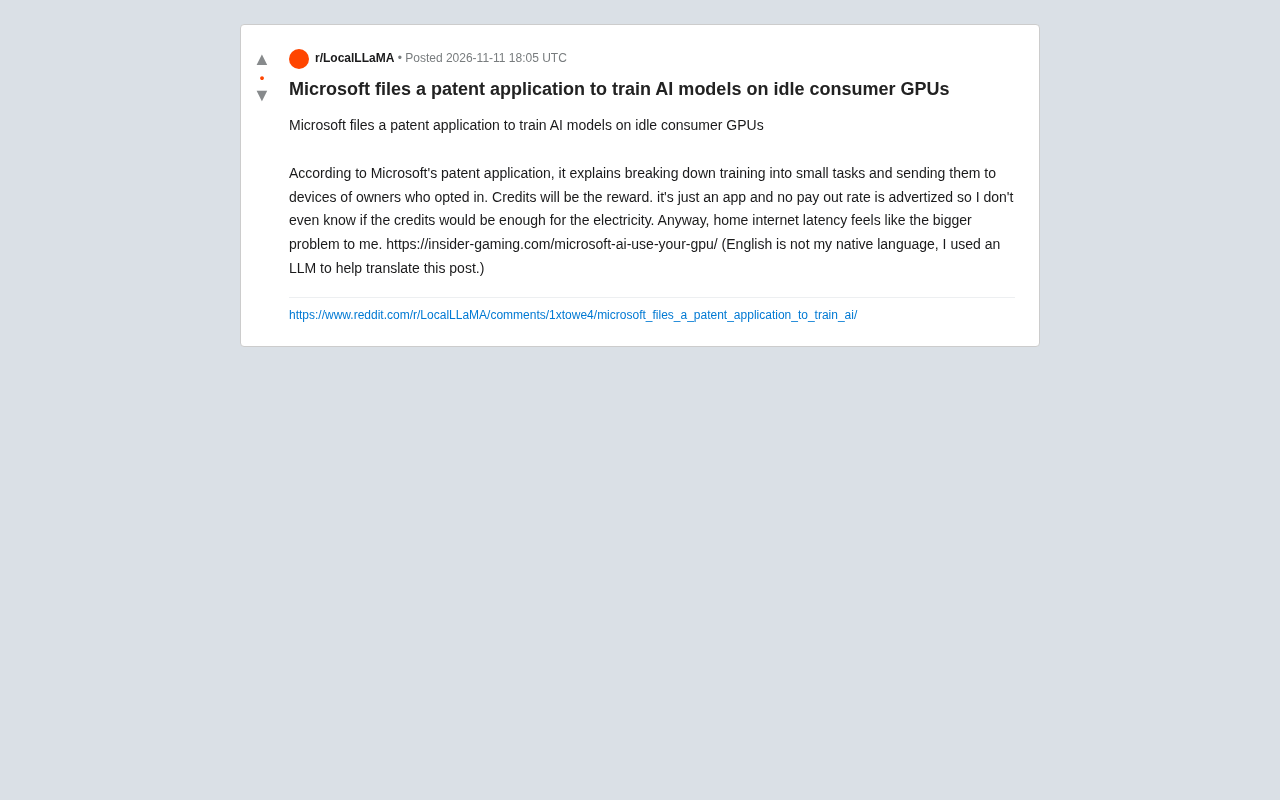
微软专利拟将AI训练任务众包给消费级GPU,以积分激励,但电费与网络延迟成落地瓶颈。
微软一项新专利显示,公司正探索将AI模型训练拆分为细粒度小任务,分发到用户自愿加入的消费级GPU上执行,并以积分作为回报,其思路类似BOINC等传统分布式计算项目。但该设想面临双重拷问:一是专利未公布积分兑换比例,用户无法判断收益能否覆盖GPU满载运行的电费;二是家庭网络的上行带宽与延迟远不及数据中心,梯度同步和任务调度开销可能拖慢训练进度甚至影响收敛。此外,专利未披露隐私保护、容错机制和通信优化等细节,与现有数据中心内分布式训练框架相比,异构硬件、不稳定网络和节点动态退出都是待解难题。目前该专利仅处申请阶段,尚无产品化计划。
微软一项新专利显示,该公司正探索将AI模型训练任务拆分成小份,分发到用户自愿加入的消费级GPU上执行,并以积分作为回报。这一设想类似于分布式计算的老思路,但在AI训练场景下,它面临着网络延迟和激励合理性的双重拷问。
专利核心:把训练任务众包给闲置GPU
根据专利描述,微软会将AI训练过程分解为细粒度的小任务,然后发送到已选择加入(opt-in)的消费者设备上。这些设备利用空闲的GPU算力执行计算,完成后获得积分奖励。
这本质上是一种众包算力模式,与传统的分布式计算项目(如BOINC)类似,但目标换成了AI模型训练。专利中并未公布具体的积分兑换比例或支付费率,仅提到积分作为奖励。
BOINC(Berkeley Open Infrastructure for Network Computing)是加州大学伯克利分校于2002年发起的分布式计算平台,最初为SETI@home项目服务,后来承载了气候模拟、蛋白质折叠、引力波数据分析等大量科研项目。其运作方式是:项目方将计算任务切分为可独立验证的小工作单元,志愿者客户端下载任务、在本地CPU/GPU上执行并把结果回传,平台通过冗余计算或校验机制确保结果可信。微软专利所设想的模式在任务分发与结果回收的结构上与BOINC高度相似,但二者存在关键差异:BOINC的任务通常彼此独立、可高度并行,而神经网络训练涉及梯度同步和参数更新,任务之间存在强依赖关系,这也是该设想面临通信瓶颈的根本原因。
积分能覆盖电费吗?激励设计存疑
Reddit原帖作者提出了一个现实问题:由于没有公布 payout rate(支付费率),用户无法判断获得的积分是否足以抵消GPU满载运行带来的电费开销。
对于普通消费者而言,GPU在高负载下功耗显著上升,长期运行的电费成本可能超过积分价值。如果激励不足,愿意参与的用户规模将受限,进而影响整个网络的算力供给。
网络延迟:比电费更关键的瓶颈
原帖作者认为,家庭互联网的延迟才是更大的问题。AI训练任务通常需要设备间频繁同步梯度或参数,而消费级宽带的上行带宽和延迟远不及数据中心内的专用网络。
将训练拆分成小任务可以降低单次通信量,但任务调度、结果回传和同步开销仍会引入延迟。对于需要紧耦合的模型训练,这种松散的网络结构可能拖慢整体进度,甚至影响模型收敛。
梯度同步是数据并行训练的核心环节。在标准的数据并行方案中,每张GPU持有完整的模型副本,各自用不同的数据批次计算梯度,然后通过All-Reduce等集合通信操作将所有设备的梯度求平均,再更新参数进入下一轮迭代。这一过程在每个训练步都会发生,因此设备间的通信延迟直接决定训练吞吐。数据中心内通常使用InfiniBand或高速以太网,节点间延迟在微秒级;而家庭宽带的上行带宽往往只有几十Mbps,往返延迟在数十毫秒量级,且存在抖动和NAT穿透问题。当模型参数量达到数十亿时,单次梯度传输的数据量可达数GB,家庭网络几乎无法承受如此频繁的同步,这也是为何业界需要梯度压缩、异步更新或联邦学习等专门技术来缓解该问题。
与现有分布式训练的对比
业界已有一些分布式训练框架,但它们多部署在数据中心内的高带宽环境中。微软的专利设想将范围扩展到家庭设备,这需要解决异构硬件、不稳定网络和节点动态加入退出等问题。
专利中并未披露具体的容错机制或通信优化方案,因此其实用性尚待观察。
容错机制在松散节点网络中至关重要。数据中心内的分布式训练假设节点基本可靠,硬件故障属于低频事件,因此多采用检查点(checkpoint)定期保存状态。但在众包场景下,用户可能随时关机、断网或主动退出,节点具有高度动态性。学术界为此提出了多种方案:一是冗余计算,将同一任务派发给多个节点并取多数结果;二是异步参数服务器架构,允许节点以不同速度提交更新,避免慢节点拖累全局;三是任务重新调度与检查点回滚,在节点掉线后从最近的模型快照恢复。这些机制都会带来额外开销,如何在效率与可靠性之间取得平衡,是消费级GPU众包训练能否落地的技术关键。
隐私与安全考量
用户选择加入后,其设备将执行微软下发的训练任务。专利未详细说明数据隐私保护措施,例如训练数据是否会触及用户设备,以及任务代码的隔离方式。这些细节将直接影响用户信任度。
前景:概念可行,落地挑战不小
微软的专利展示了一种利用边缘算力训练AI的思路,但积分激励的合理性和网络延迟的克服是两大门槛。如果积分价值无法覆盖电费,或者训练效率因网络问题大幅下降,这一模式很难规模化。
目前该专利仅处于申请阶段,微软未公布任何产品化计划。对于拥有高性能GPU的玩家而言,这或许是一个让闲置硬件产生收益的新途径,但前提是微软能给出有竞争力的回报方案。
相关推荐
Reddit用户晒Fable免费额度引热议
Reddit用户发帖称获得3次免费Fable使用额度,引发社区对AI工具免费福利是否普适的讨论。本文梳理帖子信息与常见运营逻辑,提醒用户以官方说明为准。
从零DIY 3D打印摆线减速器:ESP32S3控制板与运动规划全记录
Reddit用户分享从零DIY 3D打印摆线减速器的项目进展,涵盖ESP32S3控制板、编码器与运动规划,并感谢社区建议帮助解决技术难题。
AlphaGenome 2发布:按细胞类型预测变异效应
Google DeepMind 发布 AlphaGenome 2 条件 DNA 序列模型,可按细胞类型预测调控活性与变异效应,通过 AlphaGenome API 面向非商业研究开放。本文解析条件建模的意义、API 分发的取舍与验证挑战。