WorkBuddy智能体一句话跑通GEO数据库挖掘全流程

WorkBuddy智能体凭一句提示词自动完成GEO数据挖掘到生信报告全流程。
文章介绍WorkBuddy智能体如何通过一句提示词自动化完成GEO数据库挖掘的完整流程。与传统AI对话工具只能生成代码不同,智能体能直接控制计算机,自动安装软件、运行脚本、调试报错并生成图表报告。以阿尔茨海默症为例,智能体自动检索到16个符合条件的数据集,完成下载、分组整理、探针注释和过滤,再调用封装好的Skill执行批次校正、差异分析、共表达网络、特征基因筛选、免疫浸润和调控网络构建等下游分析,最终输出图文报告。文章同时指出其局限:输出质量依赖提示词准确性和Skill可靠性,用户仍需理解分析原理才能正确解读结果。
WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
生物信息学分析常被视为高门槛领域,从数据搜索、下载、整理到复杂的下游分析,每一步都可能成为研究者的绊脚石。传统AI对话工具只能辅助写脚本,但无法解决环境配置、报错调试等实际问题。如今,AI智能体(Agent)的出现正在改变这一局面。据B站UP主和深信自学网的教程,WorkBuddy广告这款智能体能够通过一句提示词,自动化完成GEO数据库挖掘的完整流程,从数据获取到分析报告生成,无需人工干预。
智能体与传统AI对话工具的核心差异
普通的AI对话工具,如ChatGPT,在生物信息分析中只能扮演“代码助手”的角色。用户需要手动输入需求,AI生成脚本,然后用户在本地运行。一旦脚本报错,用户必须将错误信息复制回对话窗口,AI修改后再次运行,如此反复。这个过程耗时且需要用户具备一定的调试能力。
智能体则完全不同。它不仅能编写脚本,还能直接控制计算机:自动安装所需的软件和依赖包,运行脚本并实时监测错误,自主修改代码并测试可行性,直到分析成功完成。最终,智能体会生成图表和分析报告,相当于一个无需休息的“生信分析助手”。据教程介绍,WorkBuddy的安装非常便捷,下载后双击即可使用,大大降低了使用门槛。
从数据搜索到整理:智能体自动化流程
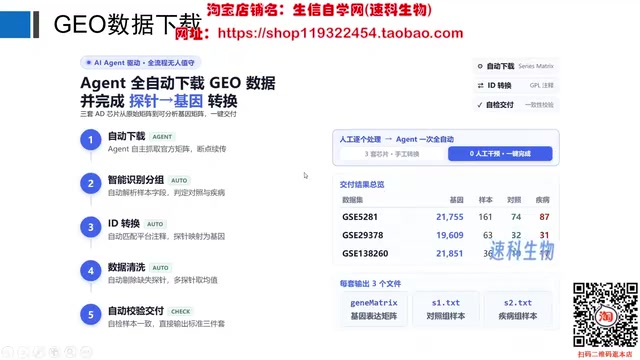
以阿尔茨海默症研究为例,用户只需在WorkBuddy中输入提示词,指定疾病关键词、样本筛选条件(如对照组和疾病组各至少5个样品)以及数据过滤要求,智能体就会自动从GEO数据库搜索相关数据集。教程中,智能体成功找到了16个符合条件的数据集,并以表格形式展示,包含数据集ID、平台信息、样本数量和组织类型等。用户可根据需要选择3到5个数据集进行多芯片联合分析。
选定数据集后,用户通过提示词告知智能体需要下载的数据ID和格式要求。智能体会自动下载数据,并进行整理:识别样本分组信息,将对照组和疾病组样本分别存放;完成探针ID到基因名称的转换;对数据进行过滤。每个数据集最终生成三个文件:表达矩阵文件、对照组样本信息文件和疾病组样本信息文件。这一过程完全自动化,省去了手动下载和格式转换的繁琐步骤。
GEO数据库(Gene Expression Omnibus)是美国国家生物技术信息中心(NCBI)维护的公共基因表达数据存储库,收录了全球研究者上传的芯片、RNA-seq等高通量实验数据。每个数据集以GSM(样本)、GSE(系列)、GPL(平台)三级编号组织,检索时需结合疾病关键词、物种、样本量等条件筛选。由于不同数据集采用的芯片平台和预处理方式各异,直接合并会产生批次效应(batch effect)——即由实验时间、试剂批次、操作人员等非生物学因素引入的系统偏差,因此多数据集联合分析前必须进行批次校正,否则下游差异分析和聚类结果会被技术噪声掩盖。
自动化生信分析:从批次校正到报告生成
数据准备就绪后,用户只需输入一行提示词,调用深信自学网编写的Skill,智能体便会自动执行完整的生信分析流程。分析报告包含了以下关键步骤:
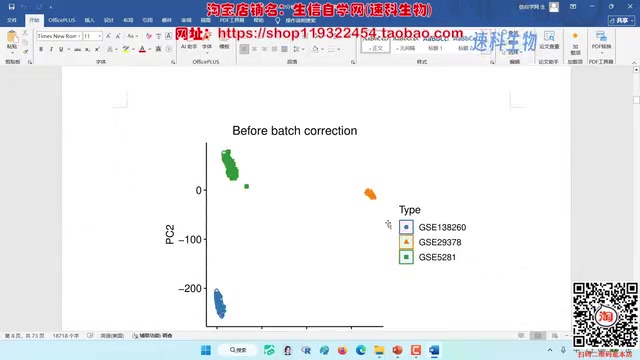
- 数据校正与合并:对多个数据集进行合并,并进行批次校正。可视化结果通过箱线图和PCA图展示,校正后样品随机分布,说明批次效应已被消除。
- 差异分析:识别对照组和疾病组之间的差异基因,并生成火山图和热图。
- 共表达分析:构建基因共表达网络,选择最佳软阈值,划分基因模块,并通过模块相关性分析筛选与疾病高度相关的模块。
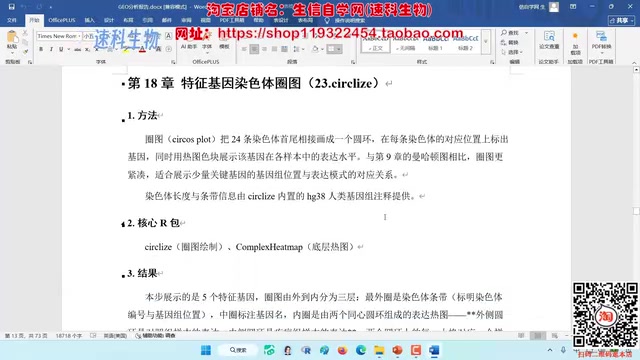
- 交集基因提取:将差异基因与疾病相关模块基因取交集,得到候选基因,并绘制曼哈顿图展示染色体分布。
- 功能富集分析:对交集基因进行GO和KEGG富集分析,揭示潜在功能与通路。
- 蛋白互作网络:构建PPI网络,筛选连接度最高的前20个核心基因。
- 特征基因筛选:通过LASSO回归、SVM、随机森林和Boruta算法四种方法筛选特征基因,取交集得到5个关键基因。
- 诊断模型构建:绘制ROC曲线(AUC均大于0.7)、列线图和校准曲线,评估基因诊断准确性。
- 免疫浸润分析:分析免疫细胞丰度差异,并与特征基因做相关性分析。
- 调控网络构建:构建ceRNA调控网络和转录因子调控网络,预测药物敏感性。
整个分析流程无需用户打开任何目录或手动运行脚本,智能体自动完成所有计算并生成图文并茂的报告。
LASSO回归、SVM、随机森林与Boruta是四种常用的特征基因筛选方法,其原理和偏好各不相同:LASSO通过L1正则化将不重要的基因系数压缩为零,适合高维稀疏数据;SVM-RFE基于支持向量机的递归特征消除,按分类贡献度排序基因;随机森林利用集成决策树的特征重要性评分;Boruta则通过与原特征随机打乱的“影子特征”竞争来判定基因是否真正重要。四种方法取交集可降低单一算法的假阳性风险,提高候选基因的稳健性。
免疫浸润分析通常借助CIBERSORT、xCell等反卷积算法,从组织表达谱中推算22种免疫细胞的相对丰度,再与特征基因表达量做相关性分析,从而推断基因是否通过调节免疫微环境参与疾病发生。ceRNA网络则基于“竞争性内源RNA”假说:长链非编码RNA或环状RNA通过miRNA响应元件吸附miRNA,间接解除miRNA对靶mRNA的抑制,构建该网络有助于理解转录后调控层面的疾病机制。
智能体在生信分析中的优势与局限
WorkBuddy展现出的自动化能力,显著降低了生信分析的技术门槛。对于缺乏编程经验的研究者,智能体可以快速完成数据挖掘和常规分析,加速科研发现。然而,智能体的输出质量依赖于提示词的准确性和Skill的可靠性。用户仍需理解分析原理,才能正确解读结果。此外,智能体目前主要针对标准流程,对于个性化分析需求,可能需要更复杂的提示词设计或自定义Skill。
据教程作者介绍,他们已将常用的生信分析流程封装为Skill,用户输入特定提示词即可调用。这种模式有望推动生信分析的标准化和普及化。随着智能体技术的演进,未来或许能处理更复杂的分析任务,成为科研工作者的标配工具。
本文基于B站UP主“深信自学网”的视频教程整理,观点供参考。
相关推荐
Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。
Mistral Large 4开放权重,AI早报盘点模型与生态新动向
Mistral Large 4开放权重,1万亿参数MoE架构支持MacStudio本地运行;Meta测试生成技术进入生产环境;税务基准测试头名通过率仅10.8%;加拿大政府入股Cohere;豆包工作开放第三方模型调用。本期AI早报盘点模型、生态、资本与政策动向。

Mistral Large 4开源:1T参数欧洲版千问挑战DeepSeek
Mistral Large 4正式开源,1T总参数、52B激活参数,主打编程与网络安全,NVFP4量化版本权重约610G。本文解析其与DeepSeek V4 Flash的对比、API定价、Demo真实性与本地部署价值。