五大开放科学挑战:隐藏验证器如何重塑AI科研评估
FINAL-Bench用私有验证器举办五个开放科学挑战,让AI智能体提交可检验假设。
FINAL-Bench 将「模型提出、检查器判定」的验证器范式搬到真实科学发现场景,推出覆盖药物发现、材料科学、超导物理与量子计算的五个开放科学挑战赛,外加 21 个榜单的 LEADBOARD。参赛者提交分子、晶体、配对估计或解码器等具体产物,由不可见的验证器打分,规则与权重公开但评分实现和答案密钥始终留在组织者硬件上。这种不对称设计防止参赛者「对着评分器优化」,迫使优化目标回到科学问题本身。挑战赛门槛低,提供骨架代码与提示词,明确面向 AI 编程智能体。文章同时提醒,所有分数均为计算预测而非实验测量,高分只代表值得测试的假设。
AI研究社区最近被「验证器」刷屏——同一天出现多篇关于更强验证器的论文。核心思路很直接:模型提出方案,一个独立的检查器判定对错。而FINAL-Bench把这套「提出-验证」分工搬进了真实的科学发现场景,推出五个开放科学挑战赛,提交者看不到评分器,答案密钥始终留在组织者硬件上。
五个挑战赛的提交与验证逻辑
五个挑战覆盖药物发现、材料科学、超导物理和量子计算,每个都要求提交一个具体产物,由不可见的验证器打分。
| 挑战赛 | 提交内容 | 验证依据 | 当前状态 |
|---|---|---|---|
| Open Discovery Challenge | 药物候选分子(SMILES) | 靶点与反靶点结构预测、ADMET、新颖性 | 第2至4赛季开放 |
| Open Materials Challenge | 锂电解质晶体 | 氧化稳定性与锂金属稳定性、用途新颖性 | 第1赛季开放至2026-11-30 |
| Open Superconductor Challenge | 每种二维材料的d波配对估计 | 对高分作品运行多体参考求解器 | 第1赛季开放至2026-12-31 |
| Open Quantum Challenge | Hubbard能量或表面码解码器 | 冻结的私有基准真值 | 两个赛季开放至2027年 |
| LEADBOARD | 对留出分子的性质预测 | 永不公开的标签 | 21个榜单开放 |
这五个赛道的共同点在于「提交-验证」的严格分离:你提交一个分子、一个晶体、一个预测或一个解码器,验证器打分,而答案密钥永远不离开组织者的机器。
为什么隐藏验证器是关键设计
如果评分器是公开的,参赛作品就可能被「对着评分器」塑形,而非对着生物学或物理学本身。这是竞赛设计中的经典漏洞:一旦评分逻辑可见,优化目标就会从「发现正确答案」偏移到「通过评分器」。
FINAL-Bench的应对方式是把规则、权重和提交限制全部公开,但评分实现和答案密钥保持私有。这种不对称设计让提交者无法逆向工程评分标准,只能老老实实解决科学问题本身。
「对着评分器优化」(reward hacking 或 specification gaming)是机器学习和竞赛评测中的常见失效模式:当优化目标(评分函数)只是真实目标的代理时,模型或参赛者可能找到在评分上得分很高、却不满足真实意图的解。在分子设计场景里,这种解可能是能骗过打分函数、但合成困难或具有毒性的分子。隐藏验证器通过切断反馈回路来缓解这一问题,但并不能完全消除——参赛者仍可借助公开的规则与训练数据间接推断评分偏好。类似的思路在 Kaggle 私有排行榜、ARC 基准的留出集以及各类「盲测」评测中都有体现,其共同前提是评分数据与评分逻辑对被测方不可见。
为AI智能体而建,不只面向人类
这些挑战赛的一个显著特点是低门槛——首次提交不需要特殊硬件。LEADBOARD为每个榜单提供了填写好的提示词和可运行的骨架代码;超导挑战赛明确表示AI编程智能体可以参赛。
一个配备代码工具(如Claude Code)和一组智能体技能的agent,可以读取规则、编写流程并提交作品。这意味着挑战赛同时服务于人类研究者和自动化科研智能体,验证器架构天然适配「模型提出、检查器判定」的agent工作流。
四个代码仓库已公开:open-discovery-challenge、open-materials-challenge、leadboard和quantum-bench-harness,参赛者可以基于这些基础快速起步。
「AI 编程智能体」(coding agent)指能够自主读写代码、运行命令、迭代调试以完成任务的系统,如 Claude Code、基于 ReAct 或工具调用范式的智能体。它们与普通大模型的关键区别在于具备执行环境闭环:可以读取仓库、安装依赖、运行测试并根据报错修正方案。这使得一个智能体能够在无人干预下完成「阅读竞赛规则—编写求解流程—生成提交物—根据反馈改进」的完整循环,因而天然适配「模型提出、检查器判定」的验证器架构。骨架代码(scaffold)与提示词模板的作用是降低智能体起步时的探索成本,把任务约束在可复现的工程框架内。
分数是假设,不是结论
需要清醒认识的是,这些挑战赛的所有分数都是计算预测,而非实验室测量。高分只代表一个值得测试的假设,而不是已验证的科学事实。隐藏验证器保证了评分的公正性,但计算预测与真实实验结果之间仍隔着实验验证这一步。
这套「提交-验证」架构的价值在于:它把AI科研从「刷榜」拉回到「提出可检验的假设」,同时用私有验证器堵住了针对评分器优化的捷径。对AI智能体而言,这是一个可以真正参与科学发现的入口。
计算预测与实验测量之间存在系统性差距。以药物发现为例,ADMET(吸收、分布、代谢、排泄与毒性)预测模型与真实体内实验的相关性往往有限;材料科学中,基于密度泛函理论(DFT)的氧化稳定性计算也依赖交换关联泛函与计算设置,存在已知误差。此外还存在分布偏移问题:验证器基于历史数据训练,对真正新颖的候选物外推能力可能不足,导致高分作品在实验中失败。因此,把分数视为「优先级排序信号」而非「真值」是更稳妥的解读,这也是计算科学中「预测—湿实验验证」闭环长期存在的分工。
相关推荐
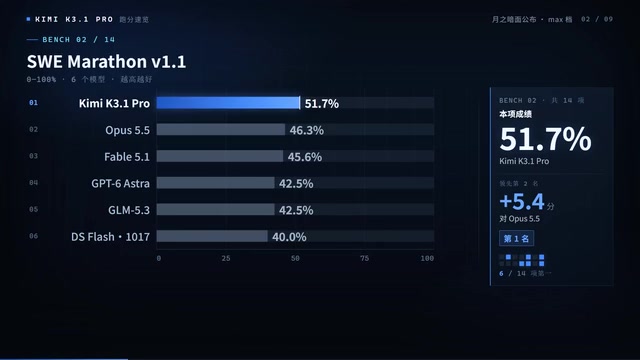
Kimi K3.1 Pro跑分曝光:14项测试6项第一,编程直追Opus
Kimi K3.1 Pro跑分公布:14项测试6项第一,场任务编程51.7超Opus,终端实战65.7仅差0.7分,幻觉率从23.4%降至8.3%,高速版支持百万上下文并计划开放权重。

谷歌Agent Compute Engine:每个Agent一个microVM
谷歌Agent Compute Engine为每个AI Agent分配独立microVM且不存凭证,本文解析其隔离设计与凭证管理思路,梳理已公开与未公开细节,并给出构建者可立即借鉴的三条实践。

付费AI写作研究谁最强?Reddit用户激辩ChatGPT与Gemini
Reddit用户热议付费AI聊天机器人写作研究能力:资深写作者发现免费Gemini输出胜过付费ChatGPT,社区讨论聚焦写作质量、研究场景偏好及提示词工作流,揭示免费与付费边界模糊下的工具选择策略。