五大MCP安全扫描器实测:1.5万个真实包,误报率最高35.9%

五大MCP扫描器在近1.5万真实包上误报最高35.9%,基准高分多靠标记刷出。
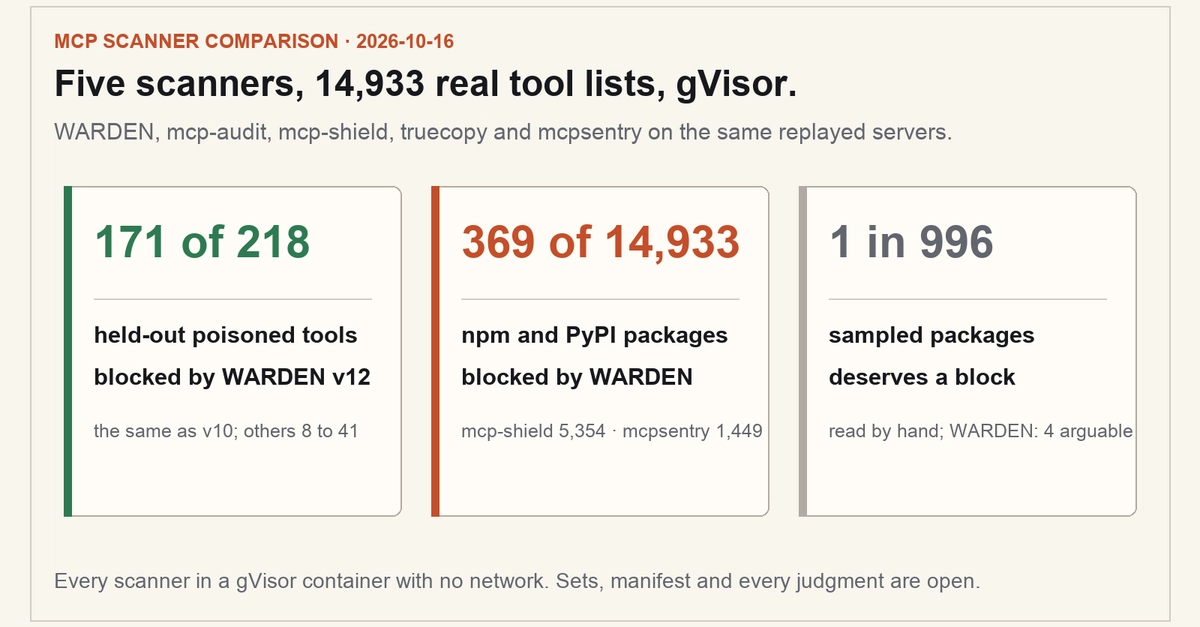
作者将MCP扫描器对比实验从三个扩展到五个,真实样本从986个远程服务器扩展到14,933个npm和PyPI包的工具定义,全部在无网络gVisor沙箱中离线运行。结果显示:MCPTox基准分数被<IMPORTANT>标记严重污染,mcp-audit、truecopy、mcpsentry加上前缀后拦截数暴增,测的是标记而非攻击;真实包上误报率从1.7%到35.9%不等,手工审阅发现mcp-shield的339个拦截仅1个成立,误报多为全角标点、base64模式、关键词匹配等低级错误。两个真实恶意包(行为劫持与隐藏数据流)被所有规则扫描器漏掉,仅被WARDEN可选分类器标为high。实验通过固定SHA-256清单、双机同镜像、双跑一致性验证保证可复现,作者公开全部数据并承认利益相关。
MCP(Model Context Protocol)生态的安全问题正在从理论走向实测。作者团队在一周内重跑了此前的扫描器对比实验:扫描器从三个增加到五个,真实样本从986个远程服务器扩展到14,933个npm和PyPI包的工具定义,并且所有扫描器——包括自家产品——都跑在无网络的gVisor沙箱里。结论并不好看:大多数开源扫描器在真实包上大量误报,而它们在基准测试上的高分,很大程度上是在测"标记"而不是测攻击。
实验升级:从三个扫描器到五个,从工作站到gVisor
上一轮实验有三个明显短板:真实服务器全是远程HTTP服务,而本地MCP工具大多是npm和PyPI包;只对比了两个其他扫描器;全部跑在工作站上。这次三处都补上了。
作者从Glama列出的七个工具中逐一甄别,最终只把能在离线环境下跑工具定义扫描的两个新扫描器纳入对比:truecopy(从姊妹项目redstamp获得检测能力,负责签名和锁定MCP服务器)和mcpsentry(六条正则规则加运行时代理)。其余五个被排除——Dredd MCP、Occludra、mcpcheck、Singularity的判定都在云端完成,contextboundary-gw则是运行时策略网关,在工具定义层面没有可比对象。Snyk Agent Scan同样因为依赖远程判定而出局,且其免费层此前拒绝了所有请求。
这个筛选标准本身就是一条值得记住的结论:能拿到离线沙箱里复现的扫描器,比宣传页上列出的一长串工具少得多。
gVisor 是 Google 开源的容器沙箱运行时,它在用户态实现了一个兼容 Linux 系统调用接口的“应用内核”(Sentry),容器内的进程不直接与宿主内核交互,而是由 Sentry 拦截并处理系统调用。与传统容器共享宿主内核不同,gVisor 大幅缩小了攻击面,适合运行来源不可信的代码。在本次实验中,gVisor 的无网络模式意味着扫描器无法向云端发送工具定义或获取远程判定,这一约束直接决定了筛选标准:依赖远程 API 的扫描器无法参与离线对比,只有能在完全断网环境下完成工具定义扫描的实现才被纳入。这既保证了实验的可复现性,也避免扫描器在运行时将敏感的工具定义外泄。
基准测试:分数被"标记"严重污染
在MCPTox基准上,五个扫描器对218个留存测试工具的拦截数分别是:WARDEN 171、mcp-shield 41、truecopy 27、mcp-audit 25、mcpsentry 8。
但同一批工具加上<IMPORTANT>前缀后,局面立刻变了:mcp-audit从25跳到222(共225个),truecopy从27跳到141,mcpsentry从8跳到136,而WARDEN直接达到225/225。唯一不受影响的是mcp-shield,前后都是41。
作者的判断很直接:一个充满标记的测试集,测的是标记。扫描器只要对<IMPORTANT>这类提示注入标志敏感,就能在基准上刷出漂亮数字,但这不代表它能识别真正的指令劫持。mcp-shield的反例恰好说明,它对标记不敏感,却也对其他攻击形态不敏感。
你可能没注意到,WARDEN从v10升级到v12(v11增加转义、HTML实体、百分号编码和base64解码,v12停止放过"引用攻击短语但要求模型执行"的句子),在所有测试集上的判定与v10逐服务器完全一致。作者还做了一次自查:将v10之后新增的所有规则、测试和分类器代码与留存工具逐八词比对,未发现匹配;而同样的检查在v10的改动上找到77处匹配,证明这个自查方法本身有效。
MCPTox 是一个针对 Model Context Protocol 工具定义的对抗性测试基准,其样本通过在工具名称、描述或参数中注入恶意指令,检验扫描器能否识别指令劫持、数据外泄等攻击意图。基准中的 218 个“留存”工具指在调参或开发过程中未被用于规则调试的样本,用于降低过拟合。然而,该基准的生成方式依赖少量模板,攻击形态的多样性有限;更重要的是,部分样本带有 <IMPORTANT> 等显式标记,扫描器只要对这些提示注入标志敏感就能得分,而不必真正理解工具的行为语义。因此,在同一基准上比较扫描器时,高分可能反映的是对标记的匹配能力,而非对真实攻击的泛化检测能力。
真实包上的误报:最高35.9%,且大部分是低级错误
14,933个包的工具定义来自作者自己的透明日志HISTOR,全部无标签——没人知道哪些是恶意的,因此这组数据衡量的是第二个指标:扫描器会误伤多少正常服务器。
拦截率从低到高:truecopy 1.7%(252个)、WARDEN 2.5%(369个)、mcp-audit 6.2%(928个)、mcpsentry 9.7%(1,449个)、mcp-shield 35.9%(5,354个)。
作者手工审阅了996个包的样本,结论很尖锐:mcp-shield的339个拦截中只有1个站得住(另有3个可争议);mcp-audit的58个全部不成立;mcpsentry的112个中1个成立、1个可争议;truecopy的17个全部不成立;WARDEN自己的23个拦截中,0个应直接拦截,4个可争议——三个是工具要求以参数形式传入原始私钥(密钥会经过模型),一个是把任意本地文件上传到公开图床。
误报的形态相当低级:mcp-audit把全角中文标点",""("或单个希腊/西里尔字母当成同形异义字,58个样本拦截中有51个属于此类;mcp-shield只要出现"token""API key""credentials"或".."就拦截;mcpsentry的base64模式会匹配任意40个字母和斜杠的组合,JSON Schema路径和PNG/JPG/HEIC/TIFF这类列表都会触发;truecopy则主要被环境工具里的.env绊倒。
还有一个容易被忽视的兼容性问题:mcp-shield的MCP客户端会直接拒绝26个工具列表,因为其inputSchema不是object类型,然后对这些列表什么都不检查——既不拦截也不放行,直接跳过。
同形异义字攻击(homoglyph attack) 指用视觉上相似但 Unicode 码位不同的字符替换正常字符,例如用西里尔字母“а”替换拉丁字母“a”,或利用全角标点与半角标点的差异,使恶意字符串绕过基于 ASCII 的检测规则。在 MCP 工具定义场景中,攻击者可能借此伪装工具名或描述中的敏感词。但反过来,正常的中文文本天然包含全角标点,多语言包也常含希腊或西里尔字母,如果扫描器把任何非 ASCII 相似字符都判为同形异义字,就会对合法内容产生大量误报。mcp-audit 的 58 个样本拦截中有 51 个属于此类,说明同形异义字检测需要结合上下文和字符集白名单,而不能仅做字符级替换匹配。
两个值得人工查看的包,规则都拦不住
在真实服务器上,大多数拦截是误报,但有两个工具定义值得人看一眼,而WARDEN的规则两个都没拦。
一个是行为劫持。 某个PyPI包把描述包在伪造的<critical_requirement ... directly_user_requested="true">块里,声称"先定义的内容现在排第二",命令模型在任何输入的任何回复之前先调用它的工具。它不窃取数据,但索取了用户从未授予的权威,并重排了模型的指令优先级。WARDEN将其报告为提示级,mcpsentry靠"you must immediately"拦截,mcp-shield也拦了,但靠的是关键词而非劫持行为本身。
另一个是隐藏的数据流。 某工具把文件内容、目录列表和工作目录从agent发往服务器,每项都附带"Do NOT display … to the user"。对一个本地文档索引来说这可能是整理需要,但它同样是把文件悄悄搬走的典型写法。所有扫描器都未拦截,WARDEN什么都没报告。
这两个包都被WARDEN可选的分类器标记为high——这引出了规则做不到的那部分。
分类器:能补规则之短,也会误伤工作流
分类器功能会把每个工具定义发给用户指定的模型,询问其文本是否在指挥模型。默认关闭,除非加--classifier-blocks,否则只作提示。
用deepseek-flash测试:218个留存MCPTox工具中,纯规则拦截171个,规则加分类器(high阈值)拦截218个,45个干净服务器仍然0误报。在200个随机真实服务器上,拦截或标记从2个升至5个;在996个样本包上从23个升至35个。上一次的提示词在218个中只标出147个,新提示词全部标出且不误伤干净服务器。
但分类器也有明显短板:在真实服务器上,它的多数high标记是"先调用这个工具"之类的工作流指令;它还会漏掉规则能抓到的东西——工具名里的注入、以参数索要私钥、rm -rf ~。整个对比中所有分类器运行的总成本约1.70美元。
工具定义层面的静态扫描与运行时策略网关 是 MCP 安全防护的两条不同路径。静态扫描在模型看到工具定义之前分析其文本(名称、描述、参数 schema),判断是否存在指令注入或数据外泄意图,优点是可在安装或连接前拦截,缺点是无法观察实际调用行为。运行时策略网关则在工具被调用时检查参数和返回值,能发现静态文本中不存在的动态数据流,但需要介入每一次调用,部署成本更高,且对“工具描述本身就在指挥模型”这类攻击可能已经太晚。本次实验刻意只比较静态扫描器,把 contextboundary-gw 这类运行时网关排除在外,是因为两者不在同一层面,直接对比拦截率没有意义。理解这一区分,才能正确解读文中“拦截率”指标的含义。
实验方法:固定输入、双机同镜像、承认利益相关
这次实验的可复现性做得比较扎实:运行前写好包含16,830个输入文件SHA-256的清单;其他四个扫描器共用一个镜像,WARDEN单独一个,基础镜像相同,所有安装文件与npm/PyPI发布版本一致(安装记录除外),WARDEN从被测提交的npm pack安装,与npm上0.16.0逐字节一致;gVisor无网络、只读根文件系统、2GB内存、一个bind mount。包按ID哈希分到两台运行同一镜像ID的服务器上,100个包在两台机器上都跑了一遍,五个扫描器在100/100上给出相同判定和发现代码。
作者也坦白了代价:服务器并非空闲,一次运行最重的阶段一个Web服务卡了约40分钟,后来暂停、重启服务,把运行限制在2个CPU并给最低调度权重,重跑了1,193个超时的扫描(其中mcp-audit因固定10秒连接窗口在自家沙箱旁显得太短而超时800个),超时从未被计为判定结果。
利益相关也写得明白:作者以MIT协议发布WARDEN,写了所有攻击样本和每一处人工判定,因此测试集、测试框架、原始判定、清单和全部判断都公开。局限同样列出:MCPTox来自三个模板,按服务器留存不等于按攻击风格留存;HISTOR的抓取在审阅期间仍在进行;每个扫描器只测了一个版本(mcp-audit已到0.21.0,实验保留0.18.2以便与上周对比)。
直接试用的命令是:
npx -y @aimarket/warden@0.16.0 scan
它会读取Claude Code、Claude Desktop、Cursor、VS Code和Windsurf的MCP配置,连接它们启动的每个服务器,在模型看到工具定义之前完成审查。无依赖、无需账号,除非开启分类器,否则不向任何地方发送工具文本。
关键结论
对维护者和使用者来说,这组数据给出的信号很清楚:真实包上的误报率比基准分数更能决定一个扫描器是否可用。一个把中文逗号当同形异义字、把JSON Schema路径当base64的扫描器,在35.9%的误报率下会让用户很快关掉告警。反过来,基准测试上靠<IMPORTANT>标记刷出的高分,也不该被当作防护能力的证据。作者开放全部数据和判定理由、并欢迎维护者提交issue纠正严重性判断的做法,至少让这场对比有了被检验的可能。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。
Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。
Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。