五角大楼投3000万美元打造AI测谎仪,隐忧几何?
五角大楼拟投3030万美元,用AI与远程感测技术升级饱受质疑的传统测谎仪。
美国国防部正寻求在未来五年内斥资约3030万美元,开发名为"Polygraph+"的AI增强测谎系统。项目聚焦两大方向:以机器学习替代人工主观评分,以及可在无接触情况下远程采集生理信号的"远距离感测"技术。然而,传统测谎技术本身的科学可信度长期受到质疑,AI的加持并不能修复其核心缺陷——训练数据偏差和算法黑箱反而可能让误判更难被发现。远距离感测的隐蔽特性更触发隐私与监控伦理警报。在项目技术标准与应用范围尚未公开的情况下,这一举措折射出国防部试图用最热门技术为争议性手段"续命"的意图,值得公众与监管者持续关注。
五角大楼的“测谎升级”计划
美国国防部在一份预算申请文件中透露,计划在未来五年内投入约3030万美元,用于开发一种升级版的测谎仪。这个项目被命名为“Polygraph+”或“Polygraph Next”,核心目标是借助人工智能与机器学习技术,重塑传统测谎手段的能力边界。
对军方和情报机构而言,测谎技术并不新鲜。传统多导生理记录仪(Polygraph)通过监测心率、血压、呼吸和皮肤电反应等生理指标来推断受测者是否说谎。然而这类技术长期以来饱受科学界质疑,其准确性和可靠性从未得到充分验证。此次五角大楼希望通过AI手段,突破旧有测谎方法的局限。
项目的两大技术方向
根据预算文件,Polygraph+项目主要聚焦两个技术方向。
第一是评分算法的智能化。项目将利用人工智能和机器学习技术,对测谎过程中采集的数据进行分析与打分。传统测谎在很大程度上依赖测试员的主观判断,而AI算法的引入意在提供更“客观”的量化评估,减少人为误差。
第二是一种被称为**“远距离感测”(standoff sensing)**的技术。这项技术的核心,是在不与受测者进行物理接触的情况下,远程采集其生理或行为信号。这意味着未来的测谎可能不再需要将传感器贴在受测者身上,而是能在一定距离外完成信号捕捉与分析。
这两个方向结合起来,勾勒出一个更自动化、更隐蔽、也更具规模化潜力的测谎系统蓝图。
远距离感测技术并非全新概念,其技术原型已在学术界和国防研究领域探索多年。常见实现路径包括:利用微波或毫米波雷达检测细微的胸腔起伏与心跳震动(即"非接触式生命体征检测")、通过高分辨率摄像头捕捉面部皮肤色调的微小变化来推算心率(光学心率检测/rPPG技术),以及分析步态、面部微表情等行为特征。美国国防高级研究计划局(DARPA)此前已资助过类似的"远程生命体征监测"项目,主要用于战场态势感知。将这类传感技术整合进测谎场景,意味着理论上可以在机场安检通道、审讯室外走廊乃至公共空间中,对不知情的个体实施隐性生理数据采集,这正是其引发广泛伦理担忧的核心原因。
AI测谎背后的争议
将AI引入测谎领域,本身就是一把双刃剑。
从技术层面看,机器学习模型的表现高度依赖训练数据的质量与代表性。如果训练数据存在偏差,算法很可能在特定人群或情境下产生系统性错误。测谎本就是一个科学基础存在争议的领域,用AI包装并不会自动解决底层的可靠性问题,反而可能因为算法的“黑箱”特性,让错误判断更难被察觉和追责。
“远距离感测”技术则触及了更敏感的隐私与伦理边界。若测谎能够在不知情、无接触的情况下远程进行,个人对自身生理数据的控制权将被进一步削弱。这种能力一旦被滥用,可能演变为一种大范围、无感知的监控工具。
传统测谎仪的科学可信度问题由来已久。2003年,美国国家科学院(NAS)发布报告明确指出,多导生理记录仪在安全筛查中的科学依据"极为薄弱",误报率令人担忧——尤其是无辜者被判定为说谎(假阳性)的比例相当可观。在高度敏感的安全审查场景中,假阳性可能毁掉无辜者的职业生涯,而真正的间谍或欺骗者则可通过训练或药物手段规避检测(即"反测谎"技术)。正因如此,测谎结果在美国联邦法院中通常不被作为直接证据采纳。将机器学习叠加于这一本就存在科学争议的基础之上,并不能从根本上解决其生理信号与欺骗行为之间因果关系不明确的核心缺陷,反而可能以"算法权威"的外衣掩盖原本就不可靠的判断。
值得关注的深层问题
3000万美元的投入规模虽不算巨大,但它释放的信号意义深远:美国国防部正试图用当下最热门的AI技术,为一项长期存在信度争议的技术“续命”并升级。
这也引出几个关键问题——AI测谎的准确率究竟能达到什么水平?其判断结果是否会被用于安全审查、人事甄别甚至法律相关场景?在缺乏透明度和外部监督的情况下,这类系统的误判成本将由谁承担?
目前公开的信息仍然有限,项目具体的技术路线、验证标准和应用范围都尚未明确。但可以肯定的是,当国家级机构将AI与测谎、远程感测这类技术绑定时,公众和监管者都有充分理由保持警惕。技术的进步不应以牺牲科学严谨性和个人权利为代价。
相关推荐
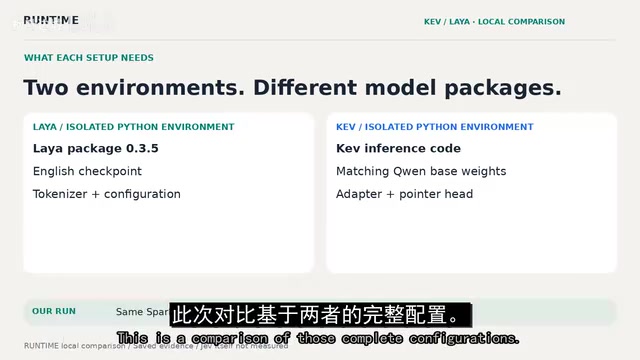
开源分类模型对决:Qwen架构的Kev胜过Llama系Laya
海外博主实测两款开源AI分类模型:基于Llama的Laya与基于Qwen 3.5的Kev在客服工单路由任务上同台竞技,对比架构、资源占用、响应速度与语境理解准确率,Kev以26/30胜出。
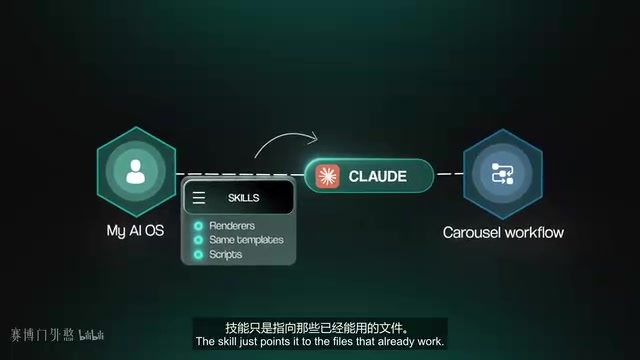
Anthropic工程师弃用单体Agent:技能化AI构建的4个关键
Anthropic工程师不再为每个任务单独构建AI Agent,而是转向可复用的技能(Skills)机制。本文拆解让技能真正高效的4个关键:存复用代码、精确描述、持久化纠正、自带验证,助你用通用智能体打造自我进化系统。
绿灯却空转两个月:AI Agent流水线的"成功"陷阱
一条 AI Agent 流水线连续两个月报告成功却零产出,只因"成功"标志衡量的是运行是否完成而非是否有产出。本文剖析这个真实运维案例及其中隐藏的日志误导、退避策略误判等问题,探讨自动化系统该如何正确定义成功。