无最优臂反馈的遗憾分析:奖励依赖延迟下的 Bandit 新进展

研究奖励依赖延迟且无最优臂反馈的随机Bandit问题,提出BHO算法并给出遗憾下界。
本文研究了随机Bandit问题中奖励依赖延迟且反馈省略原始轮次、无最优臂反馈的挑战性场景。作者提出了Balanced Historical Optimism (BHO)算法,利用次优臂的分位数构造延迟项,无需最优臂反馈即可平衡探索与利用。理论分析给出了遗憾下界:在对数统计区间内存在平方反比松弛成本,当c=1时最小最大遗憾呈线性;对于臂数增长的问题,任何学习器都面临Ω(G log K)的最坏情况遗憾。进一步提出的待触发平衡机制在特定条件下达到历史贪婪探索系数,保持加权截断界。实验揭示了共享等待的帮助条件与平衡探索的成本,为延迟Bandit问题提供了新的理论工具和算法设计思路。
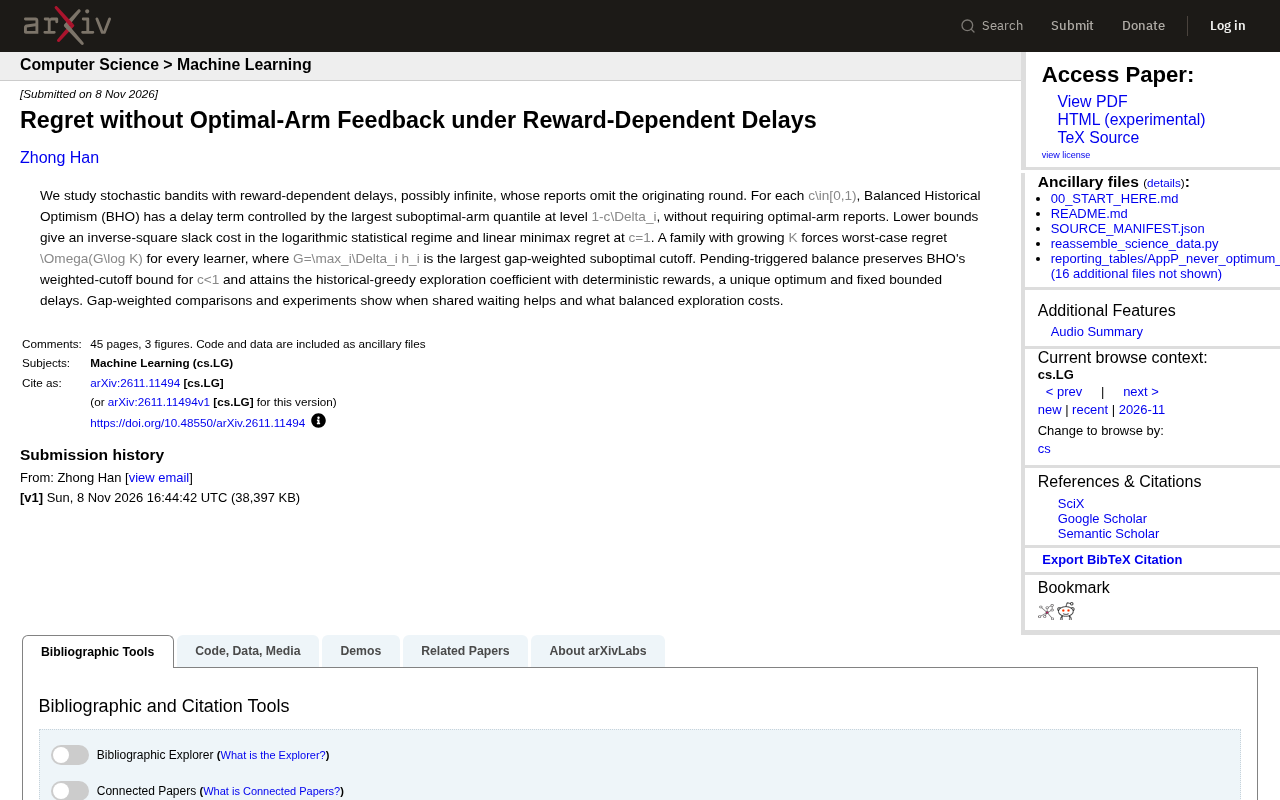
随机 Bandit 问题的经典设定假设每轮都能收到所选臂的奖励反馈,但现实中反馈往往存在延迟,甚至延迟长度与奖励本身相关——奖励越高,反馈可能来得越晚。更棘手的是,反馈可能完全缺失最优臂的信息。近期一项研究针对这种“奖励依赖延迟且无最优臂反馈”的场景,提出了 Balanced Historical Optimism(BHO)算法,并给出了遗憾下界与实验分析。
问题设定:延迟与反馈缺失的双重挑战
研究考虑随机 Bandit 问题,其中延迟是奖励依赖的,甚至可能是无限的,并且反馈报告中省略了原始轮次信息。这意味着学习者不仅面临延迟,还无法直接得知最优臂的反馈——传统乐观算法依赖最优臂的奖励估计来构造置信区间,这一路径被切断。
在这种设定下,每个次优臂的延迟分布决定了学习的难度。作者引入了一个关键量:最大 gap 加权的次优截断值 (G = \max_i \Delta_i h_i),其中 (\Delta_i) 是臂 (i) 的 gap,(h_i) 是其延迟相关的分位数。这个量刻画了最坏情况下的延迟影响。
随机 Bandit 问题是序贯决策的经典模型:每轮学习者从 K 个臂中选择一个,获得该臂的随机奖励,目标是最小化累积遗憾(即与始终选择最优臂的收益之差)。标准设定假设每轮立即收到所选臂的奖励反馈,但现实中反馈常延迟甚至缺失。奖励依赖延迟指延迟长度与奖励值相关,例如高奖励的反馈可能更晚到达。无限延迟意味着某些反馈可能永远不出现,这进一步加剧了学习难度。反馈省略原始轮次信息则使学习者无法将延迟反馈与具体决策轮次对应,传统基于时间戳的延迟处理方法失效。这些挑战共同构成了一个更贴近实际但理论分析更复杂的 Bandit 变体。
BHO 算法:平衡历史乐观
针对每个 (c \in [0,1)),BHO 算法构造了一个由最大次优臂分位数控制的延迟项,该分位数水平为 (1 - c\Delta_i),且不需要最优臂的反馈报告。直观上,算法通过历史数据中的次优臂信息来平衡探索与利用,即使最优臂的反馈缺失,也能借助次优臂的延迟结构来推断。
理论分析给出了下界:在对数统计区间内,存在平方反比的松弛成本;当 (c=1) 时,最小最大遗憾呈线性。此外,对于臂数 (K) 增长的一族问题,任何学习器都面临最坏情况遗憾 (\Omega(G \log K)),其中 (G) 是最大 gap 加权的次优截断。这一下界表明,即使没有最优臂反馈,延迟结构也会导致不可避免的遗憾增长。
遗憾下界是衡量算法性能的理论基准,表示在最坏情况下任何算法都无法避免的最小累积遗憾。最小最大遗憾则指在问题实例的最坏分布下,算法遗憾的期望值的最小可能上界。对数统计区间通常指遗憾随时间对数增长的区间,常见于乐观算法分析。平方反比松弛成本描述了当允许一定松弛时,成本随松弛量平方反比下降的现象,反映了探索与利用的权衡。线性最小最大遗憾意味着遗憾随时间线性增长,表明问题难度极高。Ω(G log K) 下界指出,当臂数 K 增长时,最坏情况遗憾至少与 G log K 成正比,其中 G 是最大 gap 加权的次优截断,这揭示了延迟结构导致的不可避免的遗憾增长。
待触发平衡:保持加权截断界
作者进一步提出“待触发平衡”(pending-triggered balance)机制,在 (c<1) 时保持 BHO 的加权截断界,并在确定性奖励、唯一最优臂和固定有界延迟的设定下,达到了历史贪婪探索系数。这是一个有趣的结论:在特定条件下,平衡探索的代价可以降至与贪婪策略相同的系数,说明 BHO 的设计在探索与利用之间取得了精细的权衡。
历史贪婪探索系数指在历史数据基础上采用贪婪策略(始终选择估计最优臂)时的探索系数,通常为 1。加权截断界是 BHO 算法中通过最大 gap 加权分位数构造的延迟项上界,用于控制探索成本。待触发平衡机制是一种动态调整策略:当历史数据中次优臂的延迟信息足以触发平衡条件时,算法调整探索率以保持加权截断界;否则退化为贪婪策略。这种机制在确定性奖励、唯一最优臂和固定有界延迟的设定下,能够达到与历史贪婪策略相同的探索系数,表明平衡探索的代价可以降至最低,实现了精细的探索-利用权衡。
实验与启示:共享等待何时有益
通过 gap 加权的比较和实验,作者展示了共享等待(即多个臂共享延迟信息)在什么情况下有帮助,以及平衡探索带来的成本。实验结果表明,当次优臂的延迟结构能够提供足够信息时,BHO 可以有效地弥补最优臂反馈的缺失;但在某些极端延迟分布下,平衡探索的代价会显著上升。
这项研究为延迟 Bandit 问题提供了新的理论工具,尤其是当反馈不完整时,如何利用次优臂的信息来设计算法。对于实际应用中的推荐系统、在线广告等场景,反馈延迟和缺失是常见问题,BHO 的思路可能启发更鲁棒的算法设计。
相关推荐

Aircad:浏览器里的专业制图与3D建模新选择
Aircad在Hacker News展示浏览器端专业制图与3D建模能力,探索无需安装的CAD工作流。本文分析其定位、潜在优势与早期项目的不确定性。

AI做新闻,受众为何不买账?
AI正成为信息入口,但受众仍抵触AI生产新闻。本文分析信任赤字根源、信息入口与内容生产的边界,以及对媒体机构AI化的现实启示。

律所如何用AI重塑法律业务?Gilbert + Tobin的实践
澳大利亚律所Gilbert + Tobin合伙人兼CEO Sam Nickless谈律所如何用AI重新思考法律业务模式,从效率工具走向业务逻辑重构,以及CEO层级介入AI战略的意义。