xhigh推理成本翻倍却难提通过率:SlopCodeBench测评结果
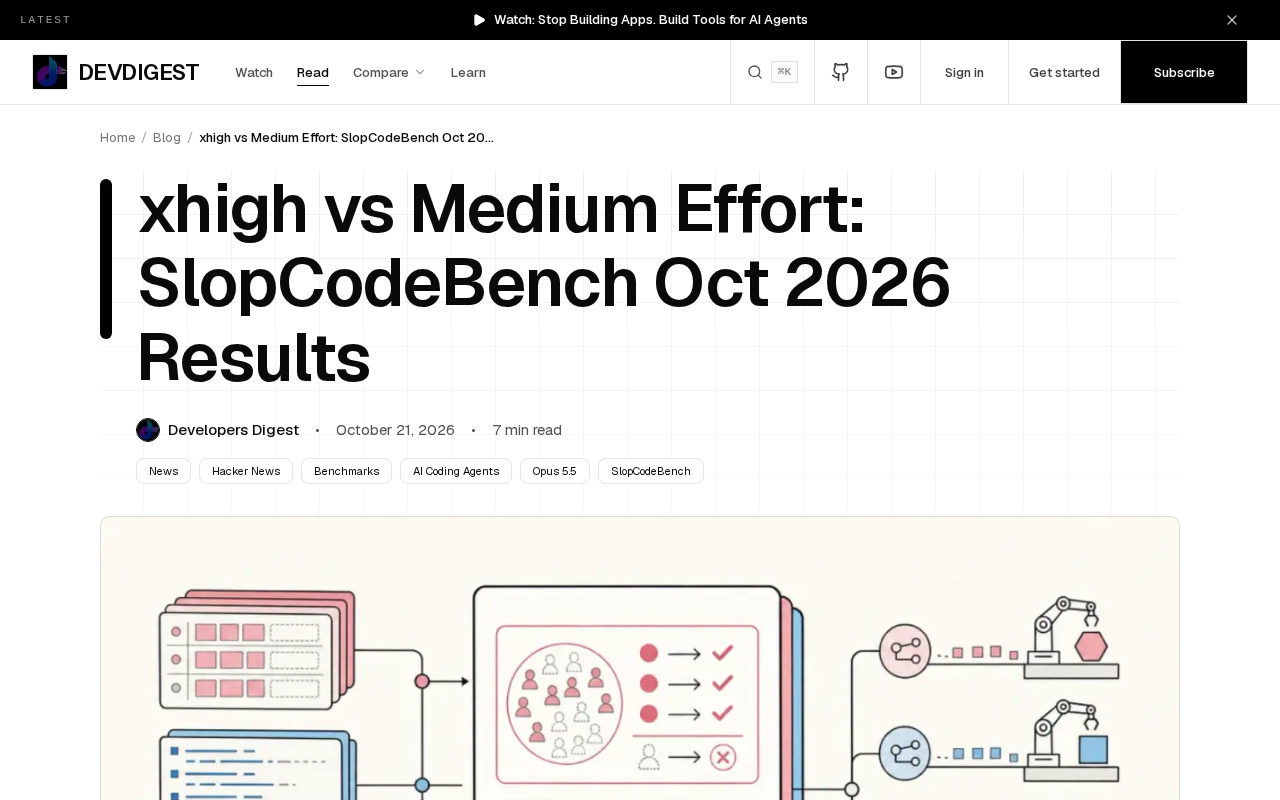
SlopCodeBench测试显示,xhigh推理成本为medium的2-4倍,但检查点通过率无可靠提升。
SlopCodeBench十月测评对比了同一模型在medium与xhigh推理强度下的代码生成表现,发现xhigh档位的资源消耗是medium的2至4倍,但在检查点通过率上并未出现统计上可靠的提升,个别任务甚至略低。文章分析认为,检查点式评估强调广度覆盖,而xhigh倾向于在单一问题上展开长链推理,二者存在错配,导致边际效益递减甚至为负。基于此,作者建议开发者默认使用medium档位,按任务类型分层配置推理强度,并优先优化提示结构与验收条件,而非盲目提高推理长度。同时提醒该结论来自单一基准运行,需在更多任务和模型版本上验证稳健性。
引言:更高推理投入未必带来更高通过率
在AI编程助手的使用中,一个常见的直觉是:让模型“想得更久”就能得到更好的代码。但SlopCodeBench的最新测评结果给这个直觉泼了一盆冷水。据该基准的十月测试报告,将推理强度从medium调至xhigh后,成本上升至2到4倍,而通过检查点的数量并没有可靠提升。
这一发现对日常依赖AI编程工具的开发者具有直接意义:盲目追求最高推理档位,可能只是在为“思考过程”买单,而非为“正确结果”付费。
测评设置与核心数据
SlopCodeBench是一个针对代码生成任务的基准测试,通过“检查点”机制评估模型输出是否满足一系列功能与质量要求。本次十月运行对比了同一模型在medium和xhigh两种推理强度下的表现。
关键结论可以概括为两点:
- 成本维度:xhigh推理的资源消耗是medium的2至4倍,具体倍数取决于任务复杂度与上下文长度。
- 效果维度:在检查点通过率上,xhigh并未展现出统计上可靠的提升。部分任务中两者持平,个别任务甚至出现xhigh略低的情况。
这意味着“更多推理token”与“更高代码正确率”之间并非线性关系,尤其在检查点式的分项评估中,额外的推理投入容易被浪费在模型自我反复或无关紧要的细节上。
推理强度(reasoning effort) 是部分大模型API提供的可调参数,常见档位包括low、medium、high、xhigh等,本质是控制模型在输出最终答案前生成多少内部推理token(思维链长度)。档位越高,模型被允许进行的中间步骤、自我检查和回溯越多,计费token随之增加。需要注意的是,该参数并不改变模型权重,只改变推理时的计算预算分配,因此其收益高度依赖任务结构:对需要多步推导的数学或复杂算法题,加长推理链往往有效;而对以功能点覆盖为验收标准的编码任务,过长的推理链容易产生重复验证和无关展开,边际收益迅速衰减。
为什么xhigh没有换来更好的结果
检查点评估放大了“过度思考”的代价
SlopCodeBench的检查点设计将任务拆解为多个可验证的节点。medium档位下,模型往往能快速命中主要检查点;而xhigh档位下,模型倾向于在单一问题上展开更长的推理链,反而可能偏离任务的核心验收条件。这种“深度优先”的推理模式与检查点“广度覆盖”的评分逻辑存在错配。
检查点(checkpoint)机制是一种将编程任务拆解为若干独立可验证功能点或质量要求的评估方式,每个检查点对应一个明确断言(如某函数返回特定值、某边界条件被处理)。与整体人工评分不同,检查点评估具有二值化和可累加的特点,模型只要满足断言即得分,不关心实现路径的简洁或推理的深度。这种设计天然偏向“广度覆盖”:快速识别并满足尽可能多的检查点,比在单个难点上深挖更划算。因此当模型在xhigh档位下把大量推理预算投入某一子问题的反复推敲时,其余检查点可能因未触及而失分,造成总体通过率不升反降。
成本结构揭示了边际效益递减
推理成本随思考长度增长,但检查点通过率的提升曲线在medium之后趋于平坦。报告明确指出,xhigh带来的额外成本并没有对应可靠的通过率增益——这是典型的边际效益递减,甚至在某些场景下为负。
边际效益递减在推理强度调节中表现为:随着推理token增加,通过率提升幅度逐步收窄直至趋零。其原因主要有三:一是多数编码任务的难点集中在少数关键决策上,medium档位已足以覆盖;二是更长的推理链会引入更多中间假设,模型在自我纠错时可能推翻原本正确的判断;三是检查点评估对“正确一次”与“反复确认后正确”给予相同分数,额外推理无法转化为额外得分。当新增推理成本高于其带来的期望通过率增益时,边际效益即为负值,这正是报告中xhigh在部分任务上表现略低的可能解释。
对开发者的实践建议
基于这组数据,可以给出几条可操作的建议。
默认使用medium档位。 对于大多数日常编码任务,medium在成本与效果之间取得了更好的平衡。除非任务本身需要长链推理(如复杂算法设计或多文件重构),否则没有必要上调推理强度。
按任务类型分层配置推理强度。 将高推理档位留给真正需要深度思考的场景,而不是全局默认开启。这样可以避免在简单任务上浪费数倍成本。
关注检查点覆盖而非推理长度。 如果团队的验收标准是分项检查点式的,那么优化提示结构、明确验收条件,比单纯提高推理强度更有效。
局限与后续观察
补充一点,本次结果来自单一基准的十月运行,样本范围和任务类型有一定局限。推理强度与代码质量的关系可能因模型版本、任务领域而异。后续值得关注的是:在不同基准上这一结论是否稳健,以及模型厂商是否会针对“过度推理”问题优化推理分配策略。
对于正在搭建AI编程工作流的团队,这组数据的价值在于提供了一个校准点:在追求更强模型能力的同时,成本效率同样是工程决策中不可忽视的变量。
相关推荐
WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。
Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。
提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。