稀疏自编码器归因图:边界决定一切

新研究揭示SAE归因图受特征边界支配,边界图可低成本大幅提升预测准确性。
稀疏自编码器(SAE)的归因图常用于预测消融效果,但新研究发现其准确性受特征“边界”支配——即预激活值与TopK截断阈值的距离。实验表明,零化一个特征会导致下一层高达0.74以上的特征跨越阈值,承载大部分响应能量,而传统归因图忽略此效应。研究者提出边界图,通过加入一阶变化量并重新排序,以相同成本将中位相对误差从至少0.247降至最大0.033。跨种子比较显示,稀疏映射可解释0.85的能量,但保留各自特征时降至0.47,边界效应可能是差异来源。边界图是轻量级修正,建议纳入可解释性研究标准流程。
稀疏自编码器(SAE)的特征归因图常被用来预测消融效果,并在不同训练种子间进行比较。但一项新研究指出,这些归因图实际上由特征的“边界”(margin)决定——即预激活值与TopK截断阈值的距离。忽略边界会导致显著的预测误差,而简单的边界修正几乎不增加成本,却能大幅提升准确性。
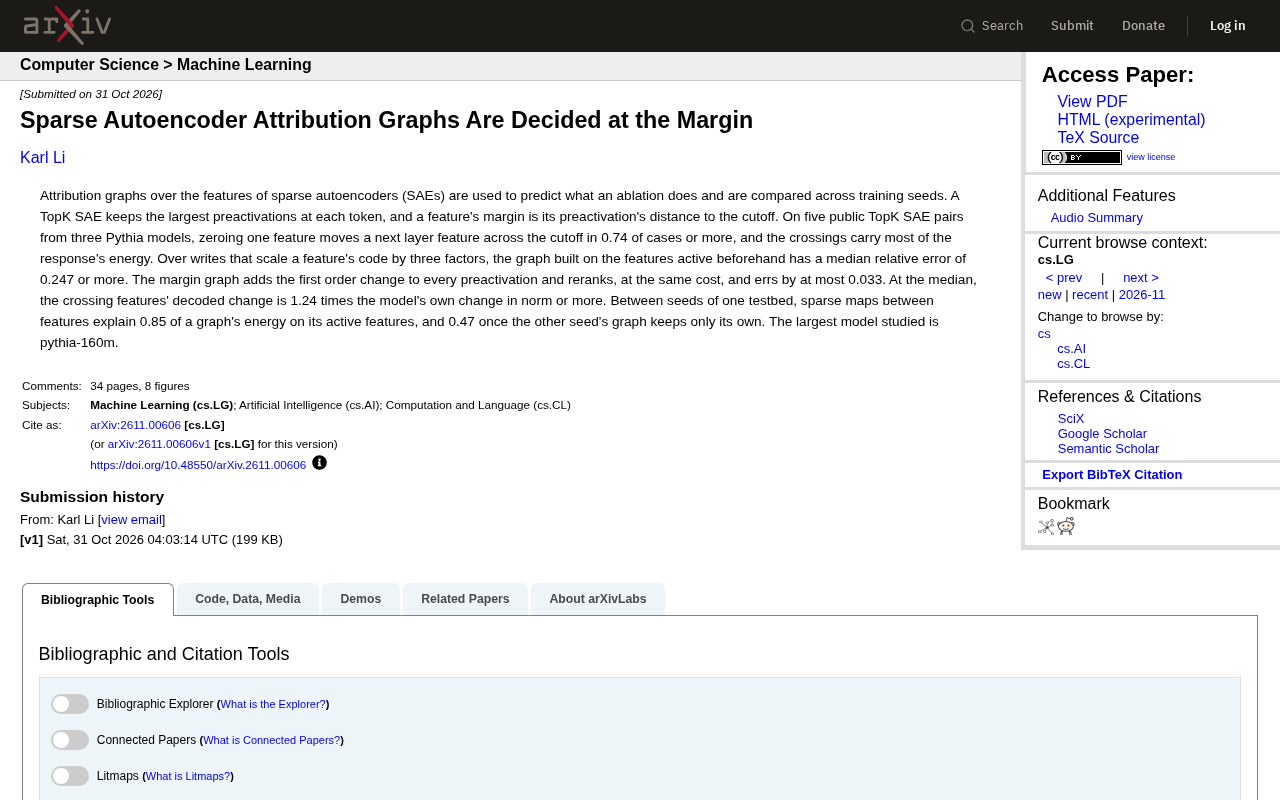
归因图与边界问题
归因图通过分析SAE特征之间的交互来预测模型行为,尤其在消融实验中用于判断哪些特征对输出有影响。TopK SAE在每个token上保留最大的若干预激活值,而一个特征的边界定义为它的预激活值与截断阈值之间的距离。研究者在三个Pythia模型(最大为pythia-160m)的五个公开TopK SAE对上进行了实验。
关键发现是:当把一个特征置零时,下一层特征跨越截断阈值的比例高达0.74以上,而且这些跨越事件承载了响应的大部分能量。这意味着,简单的消融操作会引发大量特征“进出”活跃集合,而传统归因图只考虑当前活跃的特征,忽略了这种边界效应。
TopK 稀疏自编码器(TopK SAE) 是一类通过强制每个 token 的隐层激活至多保留 k 个非零值来学习稀疏特征的自编码器。与使用 L1 正则化鼓励稀疏性的传统 SAE 不同,TopK SAE 直接对预激活值排序并保留最大的 k 个,其余置零。这种设计避免了 L1 惩罚带来的收缩偏差,使活跃特征的幅度更忠实于原始激活。截断阈值即第 k 大的预激活值,特征是否活跃完全由预激活值与阈值的相对大小决定。归因图正是在此基础上分析活跃特征间的交互,但传统方法默认活跃集合在扰动下不变,忽略了预激活值靠近阈值的特征可能因微小变化而进出活跃集合。
边界图的优势
为了解决这个问题,研究者提出了“边界图”(margin graph):在构建图时,为每个预激活值加上一阶变化量,然后重新排序。这种方法与原始图构建成本相同,但误差显著降低。实验显示,在将特征编码缩放三倍的写入操作中,基于先前活跃特征构建的图的中位相对误差至少为0.247,而边界图的最大误差仅为0.033。
此外,在 median 情况下,跨越阈值的特征解码后的变化量是模型自身变化范数的1.24倍以上,说明这些特征对输出的贡献不容忽视。边界图能够更准确地捕捉这种动态。
一阶变化量 指对预激活值关于输入扰动的线性近似,即用梯度乘以扰动量来估计预激活值的变化。在边界图中,研究者不是仅用原始的预激活值排序,而是为每个预激活值加上对应的一阶变化量后再重新排序,从而模拟扰动后哪些特征会跨越截断阈值。这种方法本质上是对 TopK 选择过程做局部线性化,计算成本与原始归因图相同(只需一次前向和反向传播),却能捕捉特征进出活跃集合的动态。由于 TopK 操作本身不可微,直接对活跃特征做归因会遗漏边界附近特征的影响,而加入一阶变化量相当于对 TopK 的离散选择做连续松弛,使归因图更准确地预测消融或缩放等操作的实际效果。
跨种子一致性
研究还比较了同一测试床不同训练种子之间的归因图。发现特征间的稀疏映射可以解释一个图在其活跃特征上0.85的能量,但当另一个种子的图只保留自己的特征时,这一比例降至0.47。这表明,尽管不同种子学到的特征存在一定对应关系,但归因图的结构仍受种子影响,边界效应可能是导致差异的原因之一。
训练种子 指在模型训练前设定的随机数生成器初始状态,它影响权重初始化、数据顺序等随机过程。不同种子训练出的 SAE 可能学到语义相似但具体方向或幅度不同的特征字典,导致归因图结构存在差异。稀疏映射 在这里指将一个 SAE 的活跃特征通过某种对应关系(如解码器方向余弦相似度)映射到另一个 SAE 的特征空间,从而比较两个图在相同特征基础上的能量解释比例。当只保留各自种子下的活跃特征时,映射失效,解释比例下降,说明归因图对特征的具体选择敏感。边界效应可能放大这种差异:靠近阈值的特征在不同种子下活跃状态不同,进而影响图的结构。理解种子间一致性对于评估归因图的可靠性至关重要。
对可解释性的启示
这项研究提醒我们,SAE归因图的准确性高度依赖于对边界条件的处理。忽略边界会导致预测偏差,尤其是在涉及消融或缩放操作时。边界图提供了一种轻量级的修正方案,几乎不增加计算开销,却能显著提升归因图的保真度。对于从事机械可解释性研究的人员来说,这是一个值得纳入标准流程的改进。
未来工作可以探索更复杂的边界交互,以及在不同模型规模上的泛化性。目前研究的最大模型是pythia-160m,更大模型上的表现仍需验证。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。