现代文件系统实战对比:Btrfs、ZFS 与 bcachefs 的取舍
实战对比Btrfs、ZFS、bcachefs,以真实负载替代合成跑分,帮助工程师按需选型。
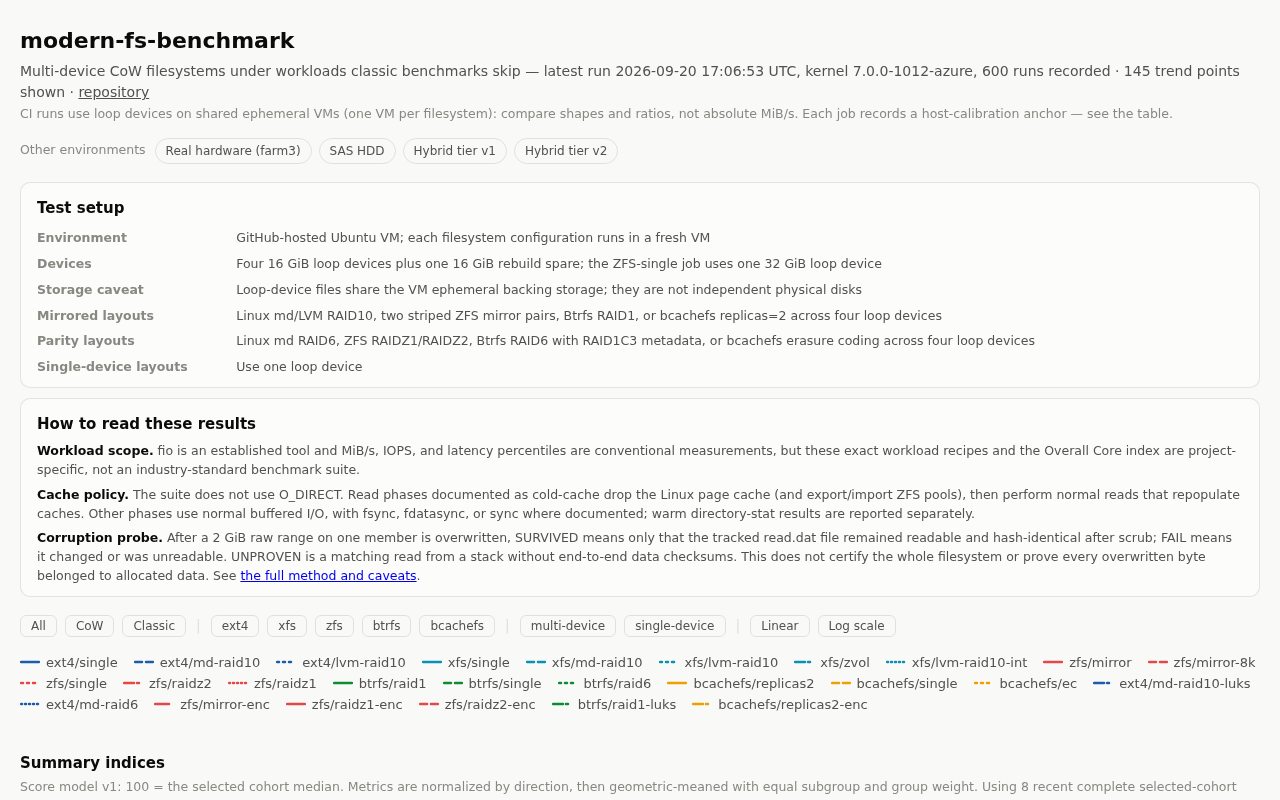
开发者Bartosz Fenski发布了一篇以真实工作负载为核心的Linux文件系统对比文章,聚焦Btrfs、ZFS与bcachefs三者,刻意绕开fio等合成基准工具。文章指出,合成跑分无法反映数据库随机写、快照延迟、元数据密集操作等真实瓶颈,写放大、缓存策略和透明压缩才是决定实际体验的关键维度。三者定位各异:ZFS久经考验但因CDDL许可证须以DKMS模块安装且内存消耗大;Btrfs内核原生、开箱即用,单盘和镜像场景成熟;bcachefs架构新颖、分层缓存设计有潜力,但生态仍在演进中。Hacker News上的讨论呈现出典型的风险偏好分歧,文章最终建议工程师在贴近自身真实负载的环境中自行测试,而非盲信流传的跑分数据。
开发者 Bartosz Fenski 近期发布了一篇关于现代 Linux 文件系统的对比文章,聚焦 Btrfs、ZFS 与 bcachefs 三者在真实工作负载下的表现。该文在 Hacker News 上获得了 158 分和 152 条讨论,反映出社区对这一话题的持续关注。与常见的合成基准测试不同,作者刻意跳过了那些经典的、脱离实际的跑分手段,转而观察这些文件系统在贴近生产环境的场景中如何应对压力。
为什么要绕开经典基准测试
传统的文件系统评测往往依赖 fio、bonnie++ 之类的合成工具,通过顺序读写、随机 IOPS 等指标给出漂亮的数字。问题在于,这些数字很难映射到用户真正在乎的东西——数据库负载、大量小文件操作、快照频繁创建时的延迟表现。
作者的核心观点是:合成基准的数据在营销层面很有用,但对于要决定「我该用哪个文件系统」的工程师而言,参考价值有限。真实工作负载会暴露出缓存策略、写放大、元数据处理等在纯跑分中被掩盖的差异。这也是文章标题中 "classic benchmarks skip"(跳过经典基准)的用意所在。
三种文件系统的定位差异
这三者虽然常被放在一起比较,但设计哲学和成熟度并不在同一层面。
ZFS:成熟稳健的老将
ZFS 起源于 Solaris,拥有多年的生产环境验证。它提供端到端的数据完整性校验、写时复制(Copy-on-Write)、快照、压缩以及强大的存储池管理。在企业和 NAS 场景中,ZFS 几乎是可靠性的代名词。代价是它对内存较为饥渴(ARC 缓存),且由于许可证问题(CDDL 与 GPL 不兼容)无法直接进入 Linux 内核主线,通常以 DKMS 模块形式安装。
ZFS 的许可证问题值得展开说明。ZFS 最初由 Sun Microsystems 以 CDDL(Common Development and Distribution License)开源,而 Linux 内核采用 GPLv2 授权。两种许可证在法律层面存在不兼容争议,导致 ZFS 代码无法直接合并进内核源码树。目前 Linux 上的 ZFS 主要通过 OpenZFS 项目以内核模块形式分发,安装方式通常为 DKMS(Dynamic Kernel Module Support),即在每次内核升级后自动重新编译模块。这一机制虽然可行,但带来了额外的维护负担:内核大版本更新时偶尔会出现短暂的兼容性空窗期。ARC(Adaptive Replacement Cache)是 ZFS 的内存缓存层,其大小默认会动态占用系统可用内存的较大比例,在内存紧张的低配机器或容器环境中需要手动限制,否则可能与其他进程形成内存竞争。
Btrfs:内核原生的多面手
Btrfs 已经合入 Linux 内核主线多年,无需额外模块即可使用。它同样支持写时复制、快照、子卷和透明压缩。多个发行版(如 openSUSE、Fedora)已将其作为默认文件系统。历史上 Btrfs 的 RAID5/6 实现存在稳定性隐患,这一点长期被社区诟病,但在单盘和 RAID1 场景下已足够可靠。
bcachefs:野心勃勃的新星
bcachefs 是三者中最年轻的,脱胎于块层缓存工具 bcache。它试图融合 ZFS 的功能丰富性与 ext4 的可靠性,同时在架构上追求更清晰的分层缓存设计。作为相对新进入内核的文件系统,它的成熟度和生态仍在快速演进中,适合愿意尝鲜并承担一定风险的用户。
实战负载下的真实差异
文章的价值在于用工作负载而非跑分说话。在写时复制类文件系统中,快照的开销、碎片化程度、以及元数据密集操作下的延迟,往往比顺序吞吐量更能决定实际体验。
对于数据库这类频繁随机写入的负载,写时复制会带来写放大问题,ZFS 和 Btrfs 都需要针对性调优(如关闭 CoW、调整 recordsize/blocksize)。bcachefs 的分层缓存设计理论上能在这类场景中提供更平滑的性能曲线,但实际表现还需要在长期运行中观察。
压缩功能是另一个被低估的维度。透明压缩在现代高速 CPU 上几乎免费,不仅节省空间,在 IO 受限的场景下还可能因为减少了实际写入量而提升性能。三者都支持压缩,但默认算法和调优空间各不相同。
写放大(Write Amplification)是理解写时复制文件系统性能的关键概念。写时复制(CoW)的核心机制是:修改数据时不覆盖原始块,而是将新数据写入空闲位置再更新元数据指针。这一设计对快照和数据一致性极为友好,但对于数据库这类频繁原地更新少量数据的负载,每次小写入都可能触发一整个块的重新分配,导致实际写入量数倍于逻辑写入量。常见的应对策略包括:在 Btrfs 上对数据库文件使用 chattr +C 关闭 CoW;在 ZFS 上将 recordsize 调小至与数据库页大小对齐(如 PostgreSQL 常用 8KB);或将数据库数据目录单独放置在不启用 CoW 特性的分区上。bcachefs 的分层缓存设计在理论上可以通过将热数据保留在快速介质上来缓解部分写放大带来的延迟,但这需要合理配置缓存层级。
社区讨论中的分歧
Hacker News 上超过 150 条评论呈现出典型的文件系统「宗教战争」色彩。ZFS 的拥趸强调其久经考验的稳定性和数据完整性保障;Btrfs 用户则看重内核原生集成带来的便利;而 bcachefs 的支持者对其架构设计抱有期待,但也有人对新文件系统在生产环境的成熟度持保留态度。
这种分歧本质上反映了不同的风险偏好:追求稳定的选 ZFS,追求便利的选 Btrfs,追求前沿设计并愿意承担风险的关注 bcachefs。没有绝对的赢家,只有匹配特定需求的选择。
给选型者的建议
从这篇实战对比可以提炼出几条实用思路。如果你的场景对数据完整性要求极高、且能接受额外模块和内存开销,ZFS 依然是稳妥之选。如果你希望开箱即用、与内核深度集成,Btrfs 在单盘和镜像场景下表现成熟。如果你是文件系统爱好者或愿意为未来押注,bcachefs 值得持续跟踪。
更重要的启示是:评估文件系统时,应当尽量在贴近自己真实负载的环境中测试,而非盲信厂商或社区流传的合成跑分数字。你的数据库、你的备份策略、你的快照频率,才是最终决定哪个文件系统适合你的关键变量。
相关推荐
REA:用AI Agent逆向工程任何软件
REA(Reverse Engineer Anything)是一款专为AI编程代理设计的MCP服务器和技能包,支持Cloud Code、Cursor等工具,可逆向分析JavaScript、Electron、二进制、Android应用和固件。本文详解其工作流程、支持平台、本地分析优势与能力边界,并提醒合法使用。

AI代理五个权限等级:从ChatGPT问答到全自动Agent
把AI代理权限拆成五个等级:从ChatGPT纯对话、项目文档、MCP连接器、Computer Use自动点击到无人值守代理,逐级分析能力边界、提示注入风险与审批疲劳,并给出默认只读、不可逆操作人工确认、按项目隔离三条实操规则。

REA:让AI代理五步逆向分析任意应用
REA 是一款开源工具,让 ClaudeCode 等 AI 代理通过 MCP 连接并驱动 Ghidra、IDA 等逆向工具,五步完成对二进制、Electron、.NET 或网站的分析,输出带证据的报告,全程本地运行。