线性注意力如何从非线性教师中学习?新研究揭示其根本局限
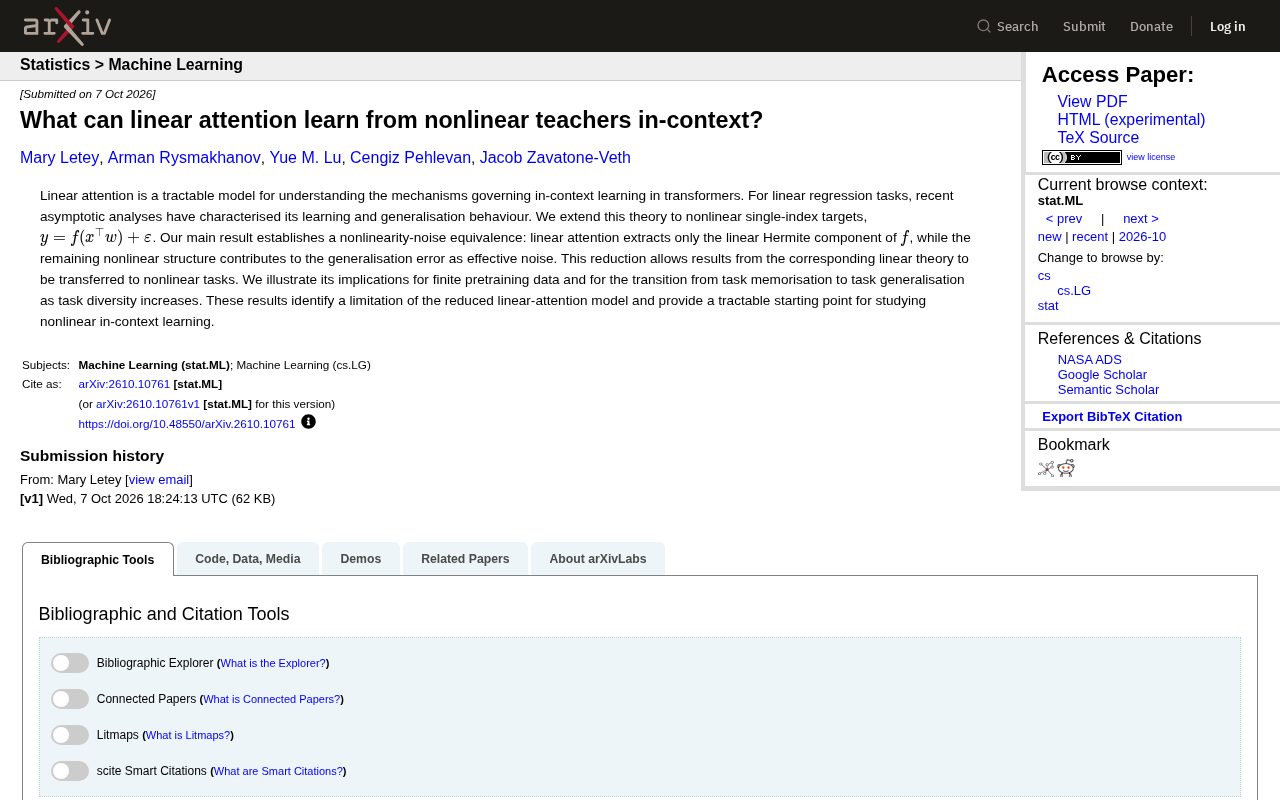
线性注意力面对非线性目标时,只能提取线性分量,其余非线性结构等价于噪声。
这篇arXiv论文将线性注意力的上下文学习(ICL)理论从线性回归扩展到非线性单指标目标 y=f(x⊤w)+ε,提出了"非线性—噪声等价性"这一核心结论:线性注意力只能提取目标函数的线性Hermite分量,剩余的全部非线性结构会被折算为有效噪声贡献到泛化误差中。这一归约使原有线性理论结果可直接迁移到非线性任务,同时解释了有限预训练数据下泛化能力的下降,以及任务多样性增加时从"记忆具体任务"到"泛化到新任务"的相变转变。研究的更深层价值在于为线性注意力作为Transformer简化模型划定了清晰边界——真实模型展现的非线性ICL能力,原理上无法被线性注意力复现——同时提供了一个可解析的理论基座,供后续研究逐步引入非线性机制。
从线性回归到非线性目标
线性注意力(Linear Attention)长期被视为理解Transformer上下文学习(in-context learning)机制的一个可解析模型。相比完整的softmax注意力,它在数学上更容易处理,因此成为研究者剖析ICL内部运作原理的理想载体。此前的工作主要集中在线性回归任务上,通过渐近分析刻画了线性注意力的学习与泛化行为。
一篇新发表于arXiv的研究(arXiv:2610.10761v1)将这套理论向前推进了一步,把分析对象从线性回归扩展到了非线性的单指标(single-index)目标,即形如 $y=f(x^\top w)+\varepsilon$ 的函数。这类目标在保持结构简洁的同时引入了真正的非线性,为检验线性注意力的能力边界提供了合适的试验场。
线性注意力是将标准Transformer中softmax注意力的指数核替换为线性核的简化变体,其前向计算可以写成矩阵乘法的闭合形式,从而允许用经典统计学习工具(如偏差-方差分解、随机矩阵理论)进行严格的渐近分析。与此对应,**上下文学习(ICL)**指模型在推理阶段仅凭提示中给出的少量输入-输出示例就能适应新任务,无需更新任何参数。这种能力在GPT-3等大模型上被观察到后迅速成为研究热点,但其理论机制长期缺乏清晰解释。线性注意力的一个关键研究发现是:在线性回归任务上,经过适当预训练的线性注意力层实际上实现了一步梯度下降(gradient descent step)的功能,这一对应关系使"模型为何能从示例中学习"有了可解析的力学解释。本文将此分析框架向非线性领域延伸,正是在这一理论传统上的自然推进。
核心发现:非线性—噪声等价性
论文最关键的结论是提出了一种“非线性—噪声等价性”(nonlinearity-noise equivalence)。研究表明,当面对非线性的单指标目标时,线性注意力只能提取出目标函数 $f$ 的线性Hermite分量,而剩余的全部非线性结构并不会被模型真正学习,反而会作为有效噪声(effective noise)贡献到泛化误差中。
这个结论的意义相当直接:对线性注意力而言,一个带有复杂非线性成分的教师信号,在它眼中等效于一个只有线性成分、但噪声更大的任务。换句话说,模型无法区分“真实的非线性信号”和“随机噪声”,它会把前者当成后者一并丢弃。
这种归约(reduction)带来了一个实用的理论便利——既然非线性部分可以被折算成噪声,那么原本只适用于线性任务的分析结果,就可以被平移迁移到非线性任务上,无需重新构建一整套理论框架。
Hermite分量来自厄米特多项式展开(Hermite polynomial expansion),这是在高斯测度下对函数进行正交分解的标准工具,类似于傅里叶分析在周期函数上的作用。任意一个平方可积函数 $f$ 都可以展开为 $f(t)=\sum_{k=0}^{\infty} \hat{f}_k H_k(t)$,其中 $H_k$ 是 $k$ 阶Hermite多项式,$k=1$ 对应的线性项即为"线性Hermite分量"。直觉上,如果 $f$ 是纯线性函数,则只有 $k=1$ 项非零;若 $f$ 含有二次、三次等高阶非线性,则对应的高阶系数也非零。本文的核心结论表明,线性注意力的结构性约束使其天然只能"看见" $k=1$ 的投影,高阶项在它的视角下与白噪声无异。这一结果与信息论中的数据处理不等式精神一致:一个表达能力受限的处理器,无法从信号中提取超出自身表示能力的结构。
对预训练数据与任务多样性的启示
基于上述等价性,作者进一步探讨了两个具有实践意味的场景。
其一是有限预训练数据下的行为。当预训练样本数量受限时,有效噪声的放大会直接影响模型的泛化表现,这为理解小数据条件下ICL的表现提供了量化视角。
其二是从任务记忆到任务泛化的转变。研究观察到,随着任务多样性(task diversity)的增加,模型会经历一个从“记忆具体任务”到“泛化到新任务”的过渡。这一现象此前在ICL研究中已有讨论,而本文将其纳入了非线性目标的分析框架中,使得这种转变可以在可解析的模型里被追踪和刻画。
任务记忆到任务泛化的转变在ICL理论中通常被描述为一种相变(phase transition)现象:当预训练任务数量较少时,模型倾向于记住见过的具体任务(task memorization),在新任务上表现较差;一旦任务多样性超过某个临界值,模型会转变为提取任务的共有结构、从而泛化到未见任务(task generalization)。这一现象已在贝叶斯最优预测器分析、以及基于softmax注意力的数值实验中被反复观察到。其背后的直觉是:见过足够多形态各异的任务后,模型被迫放弃对特定任务的死记硬背,转而学习元层面的归纳规则。本文将这一转变纳入非线性单指标设定并提供了解析刻画,使研究者能够精确描述转变发生的条件——例如需要多少任务多样性才能跨越这一门槛。
揭示了一个重要局限
这项工作最有价值的地方,或许不在于证明线性注意力能做什么,而在于清晰地指出了它不能做什么。既然线性注意力只会抓取线性Hermite分量、把其余非线性结构当作噪声丢弃,那么用简化的线性注意力模型来理解真实Transformer的非线性上下文学习能力,就存在天然的解释鸿沟。
这意味着,研究者在用线性注意力作为“玩具模型”推断大模型行为时需要格外谨慎——某些真实模型展现出的非线性ICL能力,恰恰是线性注意力在原理上无法复现的部分。
不过,作者也强调,这一结果同时提供了一个可解析的起点。明确了线性注意力的边界之后,后续研究可以在此基础上系统地引入非线性机制,逐步逼近真实Transformer的学习行为。它为研究非线性上下文学习搭建了一个干净、可控的理论基座。
为什么这项研究值得关注
上下文学习是大语言模型最引人注目的涌现能力之一,但其内部机制至今仍不完全透明。通过线性注意力这类可解析模型来逆向理解ICL,是当前理论研究的一条重要路径。
这篇论文的贡献在于,它用严格的渐近分析把“线性注意力面对非线性任务时究竟发生了什么”讲清楚了——答案是信号被降维、非线性被噪声化。这既是对现有线性理论的扩展,也是对其适用范围的一次诚实划界。对于希望理解Transformer泛化本质的研究者而言,这类明确边界的结论往往比乐观的能力宣称更有参考价值。
相关推荐
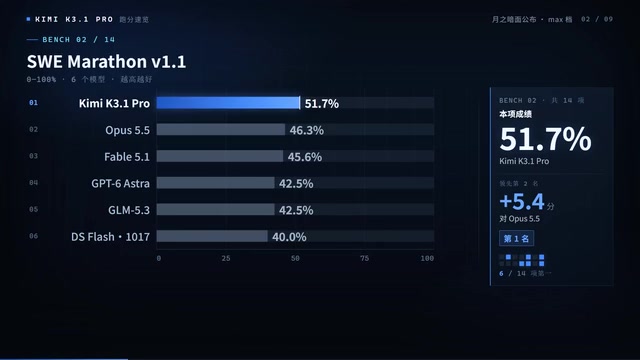
Kimi K3.1 Pro跑分曝光:14项测试6项第一,编程直追Opus
Kimi K3.1 Pro跑分公布:14项测试6项第一,场任务编程51.7超Opus,终端实战65.7仅差0.7分,幻觉率从23.4%降至8.3%,高速版支持百万上下文并计划开放权重。

谷歌Agent Compute Engine:每个Agent一个microVM
谷歌Agent Compute Engine为每个AI Agent分配独立microVM且不存凭证,本文解析其隔离设计与凭证管理思路,梳理已公开与未公开细节,并给出构建者可立即借鉴的三条实践。

付费AI写作研究谁最强?Reddit用户激辩ChatGPT与Gemini
Reddit用户热议付费AI聊天机器人写作研究能力:资深写作者发现免费Gemini输出胜过付费ChatGPT,社区讨论聚焦写作质量、研究场景偏好及提示词工作流,揭示免费与付费边界模糊下的工具选择策略。