小米MiMo v2.6实测:最强开源模型背后的三百万美元RL训练

小米MiMo v2.6公开直播RL训练全程,推出性能对标GPT-5.6级别的开源双模型。
小米发布MiMo v2.6系列,以约350万美元成本完成强化学习训练并全程直播,产出Pro与Flash两个版本。据Artificial Analysis智能指数,Pro版本是当前最强开源模型,仅次于GPT-5.6 Sol,且性价比位列帕累托前沿。实测显示,该模型在DeepSeek harness智能体编程框架中表现稳健,缓存命中率达98%,并能完成Blender 3D资产生成、实时API调用等复杂任务。硬件层面,Pro版本(1万亿参数)需约8张H100,实质上面向企业用户,而Flash版及9B蒸馏版对个人开发者更具可用性。模型还在无需专用RL的情况下展现出Lean定理证明与材料科学辅助等科学研究方向的早期能力,被视为下一个前沿领域的重要信号。
小米悄然推出的MiMo v2.6系列,正在改写开源大模型的竞争格局。这个此前在大模型领域存在感不强的厂商,拿出了一套性能对标GPT-5.6与Opus级别的开源模型,而且做了一件相当罕见的事——把整个强化学习(RL)训练过程直接直播出来,训练成本约350万美元。这不仅是一次模型发布,更是对中国开源生态实力的一次高调展示。
直播RL训练:350万美元换来Pro与Flash双模型
最吸引人的细节是小米公开了MiMo v2.6的实时训练过程。观众可以亲眼看到模型性能如何随着RL训练的推进逐步提升,这种透明度在业界非常少见,同时也直观揭示了中国厂商在训练上的投入规模——整个训练过程花费约350万美元。
这次训练产出了两个版本:Pro和Flash。根据Artificial Analysis智能指数,Pro版本目前是最强的开源模型,仅次于最高设置下的GPT-5.6 Sol。更关键的是它的性价比——凭借出色的性能成本比,MiMo Pro位列帕累托前沿,是当前最经济实惠的开源模型之一。
在衡量智能体编程能力的Terminal Bench 4.0这个尚未饱和的基准上,Pro和Flash两个版本表现都相当强劲,Pro版本达到了GPT-5.6 Sol级别。这类未饱和基准往往比传统测试更能反映模型真实的智能体能力。
强化学习(RL)在大模型训练中的具体作用值得说明。传统预训练阶段让模型学习语言规律,监督微调(SFT)阶段让模型学习人类偏好的回答风格,而RL阶段则通过奖励信号进一步优化模型的决策质量——尤其是在推理、编程和工具调用等需要多步骤规划的任务上。具体到小米的做法,他们很可能采用了类似GRPO或PPO的算法,以代码执行结果(能否通过测试)作为奖励信号,而非依赖人工打分。这种"可验证奖励"的训练范式正是近期各家模型在编程和数学能力上实现跃升的核心机制,DeepSeek广告-R1、Qwen3等模型均采用了类似路径。帕累托前沿(Pareto frontier)在此语境中指的是在"性能"与"成本"两个维度上同时无法被任何其他模型支配的点集——位列其上意味着花同等的钱买不到更强的模型,或要达到同等性能必须付出更高代价。
实测智能体编程:45M token与98%缓存命中率
作者在DeepSeek harness中对模型进行了测试——这是开源模型中实现较为优秀的智能体编程框架之一,而且大多数模型在训练时很可能没见过这个harness,因此能较好地检验模型在陌生环境下的真实能力。
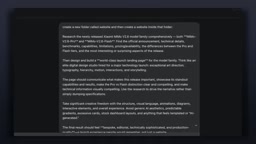
基础测试是让模型研究自身信息,然后制作一个类似产品发布页的落地页,并要求它对每一步工作进行验证。得益于这个验证循环,任务总共消耗了近4500万token,但其中约98%都被缓存命中,这正是DeepSeek harness处理得极好的地方。整个过程使用medium设置,在性能与成本之间取得了平衡。
作为多模态模型,MiMo v2.6会主动对所用资源进行截图,并对自己的工作结果做验证——这恰恰是任务指令所要求的。最终输出的落地页定位准确,同时覆盖了Flash和Pro两个版本的信息,甚至尝试还原原始博客中的部分演示和动画效果,首轮表现相当可圈可点。
代码检索的痛点:为什么通用网搜不够用
测试中模型存在一个明显倾向——过度依赖网页搜索。这暴露出当前模型的通病:训练截止后便"冻结在时间里",一旦某个库出现破坏性变更,模型无从知晓,可能继续推荐旧版API。
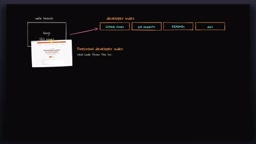
常规做法是给智能体接入网页搜索工具,但通用网搜是为一般相关性设计的,并非针对代码场景。文中以将某库从0.7升级到0.8为例,通用搜索虽然能从二手来源拿到答案,但面对较新的变更往往力不从心,还可能被SEO页面误导。相比之下,面向代码的开发者索引会索引实时的GitHub issue、已合并的PR、更新日志和原始文档,能把真实源码而非摘要直接喂给模型,甚至能捕捉到通配符版本锁定这类通用搜索会漏掉的陷阱。
这里提到的"破坏性变更"(breaking change)问题是智能体编程实际落地的核心痛点之一。大模型的训练数据存在截止日期,意味着模型对知识库的认知被"冻结"在某个时间点。对于快速迭代的开源库而言,API签名、配置格式、依赖关系可能在数月内发生根本性变化,而模型仍会以高置信度推荐已废弃的写法,这种"自信地犯错"往往比不知道更难排查。面向代码的开发者索引(如Exa、Phind等工具)的核心价值在于索引维度的针对性:它们优先抓取GitHub上的issue讨论、已合并的PR差异、官方changelog以及README变更记录,而非博客转载或问答聚合页面。这使得模型获取到的上下文更接近"第一手变更记录",从而大幅降低因信息滞后导致的幻觉风险。通配符版本锁定(如>=0.7,<1.0这类约束)是依赖管理中的典型陷阱,通用搜索引擎几乎不会将其视为有价值的内容加以索引,但对于调试依赖冲突的智能体而言,这类信息往往是问题根因。
硬件门槛:开源不等于能本地运行
开源的另一面是现实的硬件约束。MiMo Pro是一个1万亿参数、20亿激活参数的模型,普通消费级硬件根本跑不动;要以4-bit量化运行,大约需要8张H100。
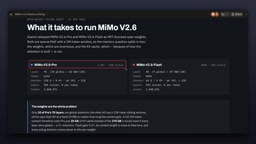
较小的Flash版本则友好许多,约3100亿参数、150亿激活参数,在4-bit量化下有望在两张机器上运行。但要注意KV缓存会随上下文长度增长,显存不仅要容纳模型权重,还要承载128K上下文的KV缓存。换句话说,这些模型确实是开源的,但更大的那个本质上是面向企业用户,而非普通个人。此外小米还蒸馏出了一个MiMo v2.6 Distilled Qwen 9B版本,专门面向智能体编程,对普通用户更具可用性。
MoE(混合专家,Mixture of Experts)架构是理解"1万亿参数、20亿激活参数"这一表述的关键。传统稠密模型每次推理都会激活全部参数;MoE模型则将参数分布在大量"专家"模块中,每次推理只路由并激活其中一小部分。这意味着模型的"总参数量"决定了存储需求(即显存下限),而"激活参数量"决定了单次推理的计算量(即速度)。Pro版本1万亿总参数在4-bit量化下约需500GB显存,8张80GB H100恰好能装下;Flash版本3100亿参数则约需160GB,两张H100勉强可行。KV缓存(Key-Value Cache)是Transformer推理时存储注意力中间结果的显存区域,其大小与上下文长度成正比——128K上下文在长任务中会额外消耗数十GB显存,这正是"显存不仅要容纳权重还要承载KV缓存"这一警示的实质。蒸馏版(Distilled Qwen 9B)则通过让小模型学习大模型的输出分布来压缩能力,9B参数在消费级单卡上即可运行,是普通开发者最可行的本地部署选项。
从3D生成到科学研究:下一个前沿
模型展示了相当广的能力面。它能准确追踪国际空间站的实时位置,调用实时API绘制轨迹图;也能驱动Blender生成3D资产,再用代码对其进行动画化。
不过作者也坦言模型的空间推理并不算强,在用three.js程序化生成3D场景时,表现只能算中规中矩,某些场景下甚至不如DeepSeek 4.1 Flash。需要强调的是,这些任务都不是单次生成的结果,而是在带验证的智能体循环中完成——这更接近真实的软件开发方式。
真正令人兴奋的是科学研究方向。小米的实验显示,模型在没有领域专用RL的情况下,依然能用Lean求解数学公式,并在材料科学、生物化学等领域提供帮助。作者认为,当下大多数模型在编程上已足够有用,即便做不了主调度器,也能作为子智能体处理定义明确的任务;而下一个前沿要么是物理世界,要么是科学研究。开源权重模型开始在这些领域展现出早期可用性——前提是这些模型能继续保持开放。
Lean是一种交互式定理证明语言,由微软研究院开发,被数学社区广泛用于形式化验证数学证明的正确性。与自然语言描述的证明不同,Lean要求每一推理步骤都符合严格的形式逻辑,系统可以机械地验证其正确性。能在没有领域专用RL的情况下使用Lean求解数学公式,意味着模型具备了一定程度的形式化推理能力,而非仅仅"看起来像数学"的模式匹配。这一方向的重要性在于:一旦模型能可靠地生成可机器验证的推理链,就可以将其输出直接用于科学假设生成、药物分子设计验证等高风险领域,而不需要人类专家逐行审查。目前包括DeepMind的AlphaProof在内的多个系统已在国际数学奥林匹克题目上展现出形式化推理能力,开源权重模型在这一方向出现早期信号,预示着科学AI的门槛正在系统性降低。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。