小米MiMo-V2.6直播训练:一天半烧850万,每秒约10美元
小米直播MiMo V2.6强化学习训练,一天半烧掉855万人民币,追赶DeepSeek的过程实时公开。
小米大模型团队将MiMo V2.6系列的强化学习(RL)训练过程直播公开,截至录制时已花费约855万人民币(合计约127.6万美元),平均每秒约60元。训练从三个维度扩展算力:大批量rollout采样(每步2B tokens/1568 prompt/16次rollout)、多任务agent IO架构混合多个harness、以及结合agentic信用分配与test cases/rubric的精细奖励机制。DeepSWE V1.1评测上,Pro版得63.72分、Flash版得60.77分,与DeepSeek V4.1 Flash的74.1仍有差距,但模型仍在训练中。小米承诺在未来几周逐步开源训练细节,对开源社区具有实用参考价值。
小米大模型团队用一种颇具话题性的方式向外界展示大模型训练的真实成本——把强化学习(RL)训练过程直接搬上直播间。据MiMo大模型负责人罗福利深夜发文,MiMo V2.6系列正处于RL强化学习训练阶段,团队不仅公开训练细节,还将整个烧钱过程实时呈现给公众。
直播训练:把烧钱过程摆到台面上
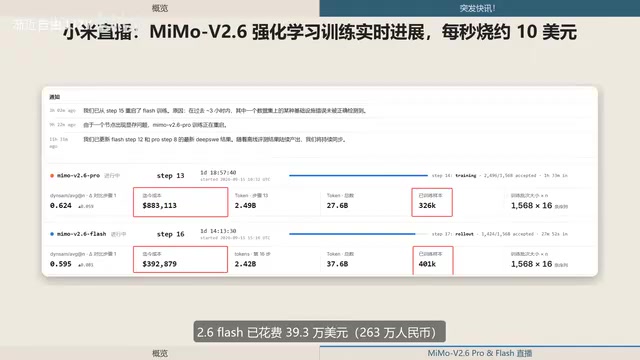
这次直播最抓眼球的地方在于成本透明。截至该UP主录制视频的13点45分,MiMo V2.6已训练72.7万样本,其中2.6 Pro已花费88.3万美元(约592万人民币),2.6 Flash已花费39.3万美元(约263万人民币),两者合计约855万人民币。
直播已进行约一天半,折算下来平均每秒花费约60元人民币,接近每秒10美元的量级。这种把训练账单实时滚动展示的做法,让外界得以直观感受到前沿大模型训练的资金消耗强度——它不再是财报里的抽象数字,而是每一秒都在跳动的成本计。
对行业而言,这种透明化本身就是一种信号。以往大模型的训练成本往往被视为商业机密,小米选择公开,既是自信的展示,也是对算力投入规模的一次公开背书。
三方向扩展算力的技术路径
根据罗福利的说法,MiMo V2.6的RL训练从三个方面扩展算力,这也是理解本次训练技术含量的关键。
第一是训练规模的扩展。每一步训练约处理2B tokens,采用1568个prompt,每个prompt进行16次rollout。这种大批量的采样方式,是当前RL训练提升样本效率与稳定性的常见做法。
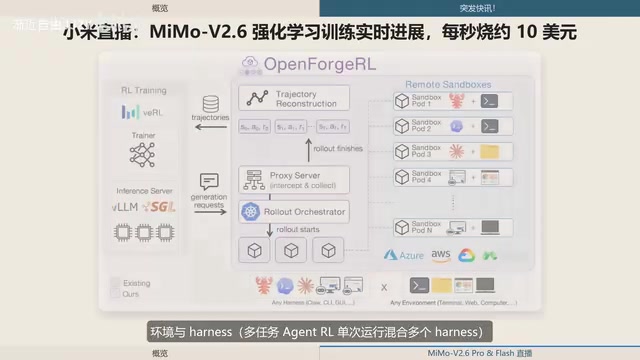
第二是环境与harness的扩展。团队采用多任务agent IO架构,单次运行中混合多个harness。这意味着模型不是在单一任务环境下训练,而是同时面对多种任务与工具调用场景,更贴近真实的agentic(智能体)应用需求。
第三是评分与信用分配的扩展。训练结合了agentic组内信用分配、测试用例(test cases)与rubric(评分标准)奖励。这套组合拳的目的,是在复杂的多步骤任务中更精确地判断模型每一步行为的价值,从而给出更有效的奖励信号。团队坦言,他们正在研究RL究竟能扩展到何种程度——这本身就是一个开放性的前沿命题。
强化学习(RL)在大模型训练中的作用:与预训练阶段用海量文本做监督学习不同,RL阶段的核心目标是让模型学会"如何做得更好"而非"如何模仿已有答案"。模型对同一个问题生成多个候选回答(rollout),由奖励模型或规则函数打分,再通过策略梯度算法(如PPO、GRPO)更新参数,强化高分行为、抑制低分行为。这一阶段对算力的需求远高于普通微调:每一步训练都需要同时运行推理(生成rollout)和反向传播(更新权重),相当于把推理成本叠加进训练成本。MiMo团队公开的每步处理2B tokens、16次rollout的配置,正是当前业界为兼顾样本多样性与训练稳定性而采用的大批量RL范式的典型体现。
信用分配(Credit Assignment)的挑战:在多步骤的智能体任务中,模型可能需要连续执行十几甚至几十个动作才能完成一个目标(如写代码、调用工具、验证结果)。传统的奖励方式只在任务最终完成时给出一个总分,无法告知模型哪一步做对了、哪一步犯了错,这就是"稀疏奖励下的信用分配问题"。MiMo团队采用的"agentic组内信用分配"结合test cases与rubric奖励,意在为每个中间步骤提供更细粒度的评价信号——例如,通过了多少单元测试、输出格式是否符合规范——从而帮助模型更高效地学习复杂推理链条,而不是靠运气碰到一个完整正确的轨迹。这是当前agentic RL研究中最核心也最难解决的工程挑战之一。
即将开源与模型发布
除了直播训练,小米还承诺将在未来几周逐步开源训练细节。MiMo V2.6系列模型也即将推出,包括Pro与Flash两个版本。
开源训练细节的价值在于,RL训练的工程实现往往比模型权重本身更难复现。harness设计、信用分配策略、奖励函数构造这些环节的经验,对整个开源社区都有参考意义。如果小米能兑现这一承诺,将为国内RL训练的公开知识库增添实用内容。
跑分对比:追赶中的定位
从公开的基准测试来看,MiMo V2.6在DeepSWE V1.1这项评测上,Pro版本得分63.72,Flash版本得分60.77。该UP主查阅DeepSWE官网最新数据后指出,目前2.6 Pro的跑分已经和某款竞品Flash型号相当。
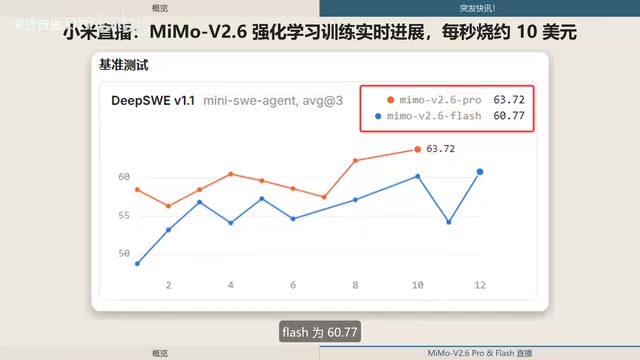
作为参照,DeepSeek V4.1 Flash发布时公布的DeepSWE V1.1跑分为74.1。这意味着MiMo V2.6目前在该项agentic编程评测上仍有一定差距,处于追赶态势。不过考虑到模型仍在训练过程中,最终成绩还有提升空间——这也正是直播训练的看点所在:观众可以见证分数随训练推进而变化。
需要说明的是,单一基准测试难以全面反映模型能力,DeepSWE偏重代码与智能体任务,实际表现还需更多维度的评测佐证。
DeepSWE评测基准简介:DeepSWE是专门面向软件工程智能体(Software Engineering Agent)能力设计的基准测试,核心任务是让模型在真实代码仓库中自主定位Bug、修改代码并通过测试用例验证。与传统编程题不同,DeepSWE要求模型具备多轮工具调用、文件读写、代码执行与自我纠错的完整能力,因此它是衡量agentic编程能力的行业参照之一。该榜单的得分通常以"通过率"(resolve rate)呈现,即模型成功解决问题的比例。由于任务难度接近真实开发场景,业界普遍认为在DeepSWE上取得高分的模型,其工程实用价值更具说服力。
结语
小米MiMo V2.6的直播训练,本质上是一次把大模型研发过程产品化、内容化的尝试。它既满足了公众对前沿AI训练的好奇心,也用真金白银的账单告诉行业:追赶第一梯队的门票有多贵。对技术从业者来说,真正的价值将在几周后逐步开源的训练细节中显现。感兴趣的读者可以关注其直播进程,观察这场每秒烧10美元的实验最终能把RL的边界推到哪里。
相关推荐
Netflix微服务神话:一场被全行业误解的架构迁移
Netflix从2008年三天宕机到全面上云并重建微服务的真实历程,与大众记忆存在明显偏差。本文还原其上云真正动机、微服务解决的"部署冲突"问题,以及为何全行业盲目复制其架构却抄错了对象——从Segment、Shopify到Prime Video的案例揭示架构选择的本质。
Java 27 深度解析:默认变更如何悄悄改变生产环境
Java 27 仅 9 个 JEP 却改动了多项默认配置:紧凑对象头默认开启、G1 成无条件默认回收器、Flight Recorder 敏感信息脱敏、TLS 1.3 内建抗量子加密。深度解析这些变化如何影响生产环境。
Anthropic称Claude正参与构建自己的继任者
Anthropic表示其AI助手Claude正参与构建下一代模型,本文解读AI辅助AI开发的实际含义、效率提升与安全风险,以及这一现象背后的行业趋势。