小模型够用吗?Agent微任务中SLM的能力鸿沟实测

研究证明现成小模型在Agent微任务上开箱即用全部不达标,鸿沟取决于尺寸而非量化精度。
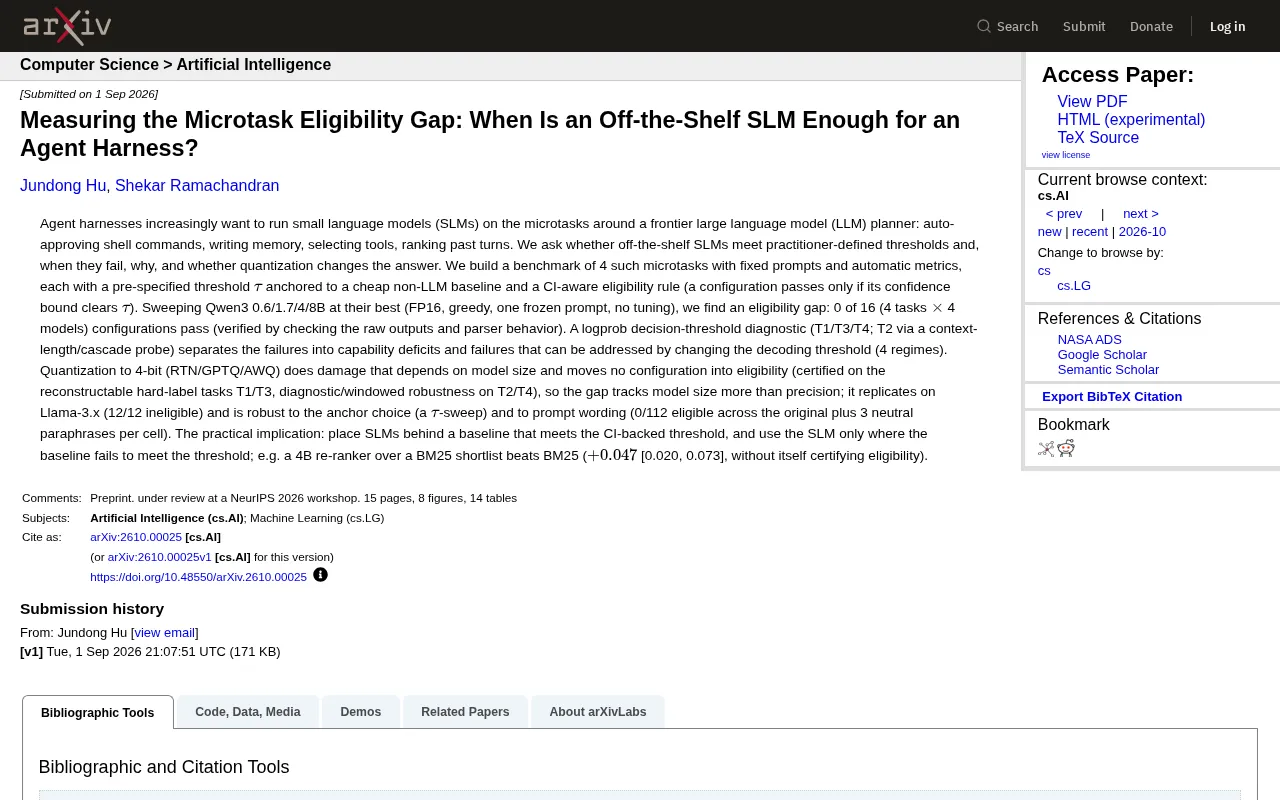
这篇arXiv研究系统检验了现成小语言模型(SLM)能否承接Agent系统中的高频微任务,包括命令审批、记忆写入、工具选择和对话排序。研究以"置信区间下界超过非LLM基线阈值"作为严格合格标准,测试Qwen3系列0.6B至8B四个尺寸,结果16个配置全部不合格。三种4-bit量化方案(RTN/GPTQ/AWQ)未改变任何配置的合格状态,说明鸿沟主要由模型尺寸决定而非精度。结论在Llama-3.x系列(12/12不合格)和112种提示词变体(0/112合格)上均得到复现。研究还基于对数概率诊断出4种失败机制,区分能力缺陷与可通过解码策略修复的问题。务实建议是:将SLM置于合格基线之后作为增量优化层,而非寄望其独立替代前沿大模型。
当Agent开始把杂活交给小模型
在以大语言模型(LLM)为规划核心的Agent系统中,有大量琐碎但高频的"微任务"需要处理:自动批准shell命令、写入记忆、选择工具、对历史对话轮次排序。这些任务如果全部交给前沿大模型,成本高昂且延迟明显。于是一个自然的想法浮现出来——能否用现成的小语言模型(SLM)来承接这些边角活?
一篇发表于arXiv的研究正面回答了这个问题。研究者构建了一个围绕Agent微任务的基准测试,系统性地检验现成SLM是否真的"够用",当它们失败时原因何在,以及量化压缩会不会改变结论。结论相当直接:在严格的统计标准下,现成小模型在这些微任务上基本全军覆没。
基准设计:带置信区间的"合格线"
这项研究的严谨之处在于它没有用模糊的"感觉还行"来判断模型表现。研究者设计了4个微任务,每个任务都配有固定提示词和自动化评估指标,并预先设定了一个阈值 τ。
这个阈值并非凭空而来,而是锚定在一个廉价的非LLM基线之上——也就是说,小模型至少要打得过传统的简单方法才算有价值。更关键的是,研究采用了"置信区间感知"的合格规则:一个配置只有在其置信下界真正超过 τ 时才算通过。这种做法避免了因随机波动而误判模型达标,是对评测方法学的一次扎实加固。
测试对象与条件
研究者扫描了Qwen3系列的0.6B、1.7B、4B、8B四个尺寸,并且让它们处于最佳状态运行:FP16精度、贪心解码、单一冻结提示词、不做任何微调。这意味着评测给了小模型最公平的发挥环境,排除了"没调好"这类借口。
Qwen3系列是阿里巴巴推出的开源语言模型家族,覆盖从0.6B到235B的多个参数量级,针对推理、指令跟随等任务做了优化。贪心解码(greedy decoding)是指每一步都选择概率最高的token,与采样策略相比确定性更强、输出最稳定,适合需要可复现结果的评测场景。FP16(半精度浮点)是当前推理部署的常用精度格式,在保留大部分模型能力的同时将显存占用压缩至FP32的一半。选择这套设置的意义在于,它代表了工程实践中"直接上线"时最典型的配置,评测结果能直接指导实际决策,而非仅在特定调优条件下才成立。
置信区间感知的合格规则是本研究方法论的核心创新之一。传统评测往往只报告点估计(如准确率78%),却忽视了在有限测试样本下这个数字本身的不确定性。如果一个模型在100个样本上得了80分,其真实能力的95%置信区间可能是[71%, 87%]——下界71%可能仍低于阈值。本研究要求置信区间的下界超过阈值τ才算通过,相当于以95%的把握断言模型"真的够用",而不仅仅是"这次测试碰巧够用"。这种严格标准在工业场景中尤为重要:Agent微任务往往高频触发,一个实际能力略低于阈值的模型在大规模调用中会产生显著的错误积累效应。BM25是信息检索领域经典的词频-逆文档频率排序算法,常作为轻量级非神经网络基线,其无需GPU、延迟极低的特性使其成为衡量"是否值得用LLM"的天然参照点。
合格鸿沟:16个配置0通过
结果令人警醒。在4个任务 × 4个模型共16个配置中,没有任何一个通过合格线。研究者还专门核对了原始输出和解析器行为,确认这不是评测管线的bug,而是真实的能力不足。
这个"合格鸿沟"(eligibility gap)的发现,对那些指望直接拿小模型填补Agent微任务的工程实践敲响了警钟。至少在开箱即用、无微调的前提下,现成SLM还达不到实用门槛。
失败原因的拆解
研究没有停留在"失败了"这个层面,而是通过一套基于对数概率的决策阈值诊断方法(标记为T1/T3/T4,T2则通过上下文长度/级联探针检验),把失败归为两类:一类是真正的能力缺陷,另一类则是可以通过调整解码阈值来缓解的问题。研究进一步细分出4种失败机制(regime),为后续改进指明了方向——有些失败并非模型"笨",而是解码策略没对准。
量化不是救星:鸿沟更依赖模型尺寸
一个实际工程中绕不开的问题是:如果把模型量化到4-bit来省显存,会不会让情况更糟?研究测试了RTN、GPTQ、AWQ三种4-bit量化方案。
结论是量化带来的损伤与模型尺寸相关,但没有任何一个配置因量化而跌出或进入合格区间。换句话说,这些模型本来就不合格,量化也没把它们变得更不合格到改变定性结论。研究用可重建的硬标签任务(T1/T3)做了认证,对T2/T4做了诊断性和窗口化的鲁棒性检验。
核心洞察由此浮现:合格鸿沟主要由模型尺寸决定,而非精度。这对资源受限的部署场景是个值得反复咀嚼的判断——盲目在精度上做文章收益有限。
RTN(Round-To-Nearest)、GPTQ和AWQ是当前主流的训练后4-bit量化方案,三者思路各有侧重:RTN最简单,直接对权重取整;GPTQ基于二阶梯度信息逐层最小化量化误差;AWQ则通过激活感知的权重缩放来保护对精度敏感的通道。三种方案的压缩率相近,但精度保留能力依次递增。研究同时测试三种方案,排除了"量化方法选错了"的解释空间——如果连AWQ这类精度损失最小的方案都无法帮助模型通过合格线,说明瓶颈确实在于参数量而非量化策略的选择。这对实际部署具有直接指导意义:在没有微调的前提下,通过换用更精细的量化方案来"救活"小模型是不现实的。
结论的稳健性与跨模型复现
为了确保结论不是偶然,研究做了多重稳健性检验:
- 跨模型复现:在Llama-3.x系列上重跑,12个配置同样全部不合格(12/12 ineligible)。
- 锚点稳健性:对阈值 τ 做了扫描,结论不随基线锚点的选择而改变。
- 提示词稳健性:在原始提示词之外,每个单元格额外加入3个中性改写版本,结果是112个配置中0个合格(0/112)。
这种程度的交叉验证让"合格鸿沟"的结论相当可信,不太可能是提示工程没做好或评测偏差所致。
实践启示:把小模型放在基线背后
这篇研究最有价值的部分不是"小模型不行"的悲观结论,而是它给出的务实架构建议:
把SLM放在一个能达到置信区间支撑阈值的基线之后,只在基线无法达标的地方才动用SLM。
论文给了一个具体例子:用一个4B模型对BM25筛出的候选短名单做重排序(re-ranker),效果优于单纯的BM25(+0.047,置信区间[0.020, 0.073])——尽管这个4B重排器本身并未通过合格认证。这揭示了一种分层协作的思路:小模型不必独当一面,而是作为传统基线之上的增量优化层,在基线失效处发挥边际价值。
这种"基线兜底 + SLM补强"的设计哲学,或许才是当下把小模型塞进Agent系统的正确姿势。与其追问"小模型能不能替代",不如思考"小模型能在哪个环节带来可验证的增量"。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。