小团队稳定推理负载:CoreWeave之外的GPU算力选择
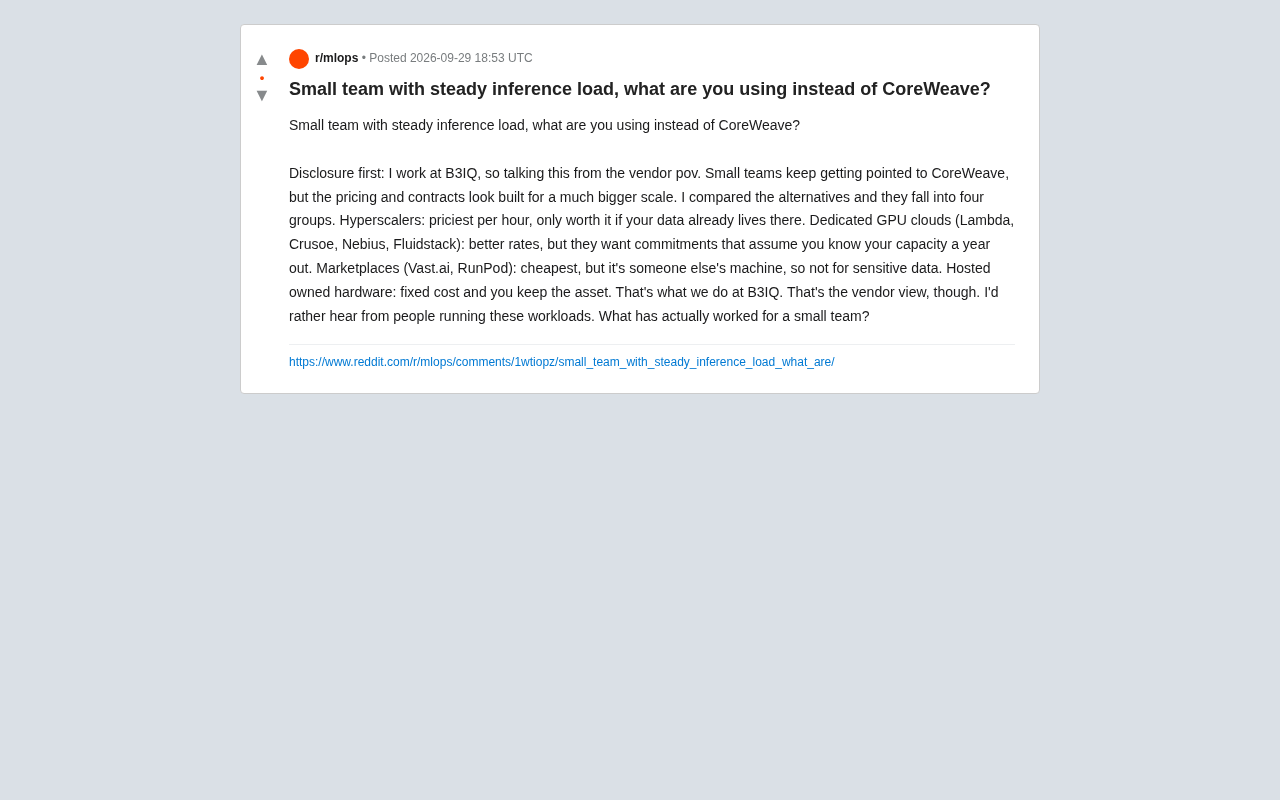
针对稳定推理负载的小团队,从四类GPU算力方案的权衡中揭示CoreWeave并不适合的原因及更优选择。
本文以一位GPU云服务从业者在Reddit上的讨论为切入点,系统梳理了小型技术团队在选择推理算力时面临的四类方案:超大规模云厂商(AWS/GCP/Azure)、专用GPU云(Lambda/Crusoe等)、算力撮合市场(Vast.ai/RunPod)和托管自有硬件。文章的核心判断是:负载是否稳定可预测,才是选型的决定性变量。CoreWeave的定价和合同结构面向大规模弹性需求设计,对负载稳定的小团队而言意味着为用不上的弹性买单。涉及敏感数据的场景应直接排除共享型算力市场。文章最终建议团队优先量化负载特征、算总账而非盯小时价,并以同类团队的实战经验而非供应商对比表作为主要决策依据。
为什么小团队开始逃离 CoreWeave
随着大模型推理成为越来越多创业公司和小型技术团队的日常需求,稳定的 GPU 算力供给成了绕不开的成本议题。CoreWeave 作为近年备受关注的 GPU 云服务商,几乎成了行业默认答案——但对于负载稳定、规模不大的小团队来说,它真的合适吗?
一位来自 GPU 基础设施厂商 B3IQ 的从业者在 Reddit 上抛出了这个问题。他坦言自己是从供应商视角出发,但核心观察值得所有小团队参考:CoreWeave 的定价结构和合同条款,本质上是为更大规模的客户设计的。对于每月推理量稳定、却又达不到超大规模的团队而言,这套模式往往意味着为用不上的弹性和承诺买单。
四类替代方案的现实权衡
这位从业者把市面上的 GPU 算力供给梳理成了四大类,每一类都有清晰的适用边界和代价。
超大规模云厂商(Hyperscalers)
以 AWS、GCP、Azure 为代表的云巨头,按小时计费的价格是几类方案里最贵的。它的价值只在一种情况下成立:你的数据本来就存放在这些平台上。此时把算力放在同一生态内,可以省去数据迁移和跨平台的复杂度。但如果只是单纯为了拿 GPU,付出的溢价并不划算。
超大规模云厂商在 GPU 算力上的高溢价,部分原因在于其提供的不仅是裸机计算资源,还包括与存储(如 S3、GCS)、网络、安全、监控等服务深度集成的完整生态。数据重力(Data Gravity)是这里的核心概念——当大量训练数据或业务数据已经存储在某个云平台时,跨平台传输不仅产生出口流量费用(Egress Fee),还带来延迟和工程复杂度。因此「数据在哪里、算力就放在哪里」是一条务实原则。然而对于纯推理场景,模型权重文件通常只需一次性加载,后续请求的输入数据量相对较小,数据重力的束缚远不如训练阶段显著,这也削弱了留在超大规模云厂商的核心理由。
专用 GPU 云(Dedicated GPU Clouds)
Lambda、Crusoe、Nebius、Fluidstack 这类专注 GPU 的云服务商,单价明显优于超大规模厂商。问题在于它们通常要求一定的资源承诺(commitment),而这背后隐含一个假设——你能提前一年预估自己的算力容量。对于业务尚在探索期、负载可能随时波动的小团队来说,这种长期锁定本身就是风险。
算力市场(Marketplaces)
Vast.ai、RunPod 这类算力撮合平台价格最低,因为你租用的本质是别人闲置的机器。便宜是真便宜,但代价同样明确:你无法完全掌控底层硬件,对于涉及敏感数据的推理任务,这种共享模式并不适合。合规和数据隔离要求高的场景基本要排除掉这一类。
Vast.ai、RunPod 等算力撮合平台的底层逻辑类似于「GPU 版 Airbnb」——将个人矿机、小型数据中心乃至企业闲置显卡聚合成可租用资源池。这种模式带来的核心风险除了数据隔离问题外,还包括硬件稳定性不一(消费级 GPU 如 RTX 4090 与数据中心级 A100 的可靠性差异显著)、节点随时下线导致任务中断,以及缺乏 SLA 保障。对于离线批量推理任务,这些风险尚可接受;但对于面向终端用户的实时推理服务,P99 延迟和可用性要求往往让共享市场难以胜任。部分平台提供「安全飞地」或专用节点选项以缓解合规顾虑,但相应价格也会向专用云靠拢,性价比优势随之收窄。
托管自有硬件(Hosted Owned Hardware)
第四类是成本固定、资产归属清晰的托管自有硬件模式,也是 B3IQ 自己所走的路线。团队直接拥有硬件资产,通过托管方式运行,成本可预测,长期来看避免了按小时计费的不确定性。当然,这也意味着前期投入和对负载稳定性的更高要求。
稳定负载才是关键变量
这场讨论最有价值的洞察,其实藏在标题里的一个词——「steady inference load」(稳定的推理负载)。
各类方案的优劣,很大程度上取决于负载是否稳定、可预测。如果团队的推理量每月起伏剧烈,那么按需付费的市场或云厂商能提供弹性;但如果负载长期稳定,持续按小时租用弹性算力反而是一种浪费——你在为「随时可以扩容」这件事付费,却几乎从不真正用到。
对稳定负载的小团队而言,固定成本的托管硬件或专用云的中长期方案,反而可能比看似灵活的按需算力更经济。这也是为什么 CoreWeave 那种面向大规模弹性需求设计的模式,会让小团队感到「不合身」。
从云计算经济学角度理解这一判断:按需(On-Demand)定价本质上是为「不确定性」收取保险费,云厂商需要维持足够的闲置容量来应对突发需求,这部分成本最终转嫁给用户。相比之下,预留实例(Reserved Instance)或承诺使用折扣(Committed Use Discount)通过让用户提前锁定用量,使云厂商得以优化资源调度,因此可以给出显著折扣——AWS 上一年期预留实例相比按需价格通常便宜 30%–40%。当负载可预测性进一步提升,自有硬件的摊销成本往往低于任何云方案,但其代价是流动性降低:硬件折旧期内若业务萎缩,固定成本无法随之下降。因此「负载稳定性」不只是技术指标,也是财务风险管理的核心输入。
来自社区的真实经验更重要
值得肯定的是,这位从业者虽然是供应商身份,但主动把话题交回给了实际运行工作负载的开发者:"这只是厂商视角,我更想听听真正在跑这些负载的人怎么说。什么方案对小团队真正有效?"
这种姿态提醒我们,任何厂商给出的分类和推荐都带有立场。对于正在做算力选型的团队来说,真正靠谱的决策依据往往来自同类团队的实战反馈——他们踩过的坑、算过的账,比任何供应商的对比表都更接近真相。
小团队选型的实用建议
综合这场讨论,给稳定推理负载的小团队几点可操作的思路:
- 先量化负载:搞清楚自己的推理量是否真的稳定、月度波动有多大,这是选型的前提。
- 算总账而非小时价:不要只看单价,要把承诺周期、闲置成本、数据迁移成本一起算进去。
- 数据敏感性优先:涉及敏感数据的推理任务,直接排除共享型算力市场。
- 警惕过度弹性:如果负载稳定,为弹性支付的溢价可能是最大的隐性浪费。
- 多方求证:厂商对比只是起点,找运行类似负载的团队交叉验证才是关键。
算力选型没有标准答案,但把「负载特征」而非「品牌热度」作为决策核心,才是小团队少花冤枉钱的正确姿势。
相关推荐
Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。
Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。
“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。