训练OpenAI的AI因用AI训练AI被解雇:一场荒诞的循环
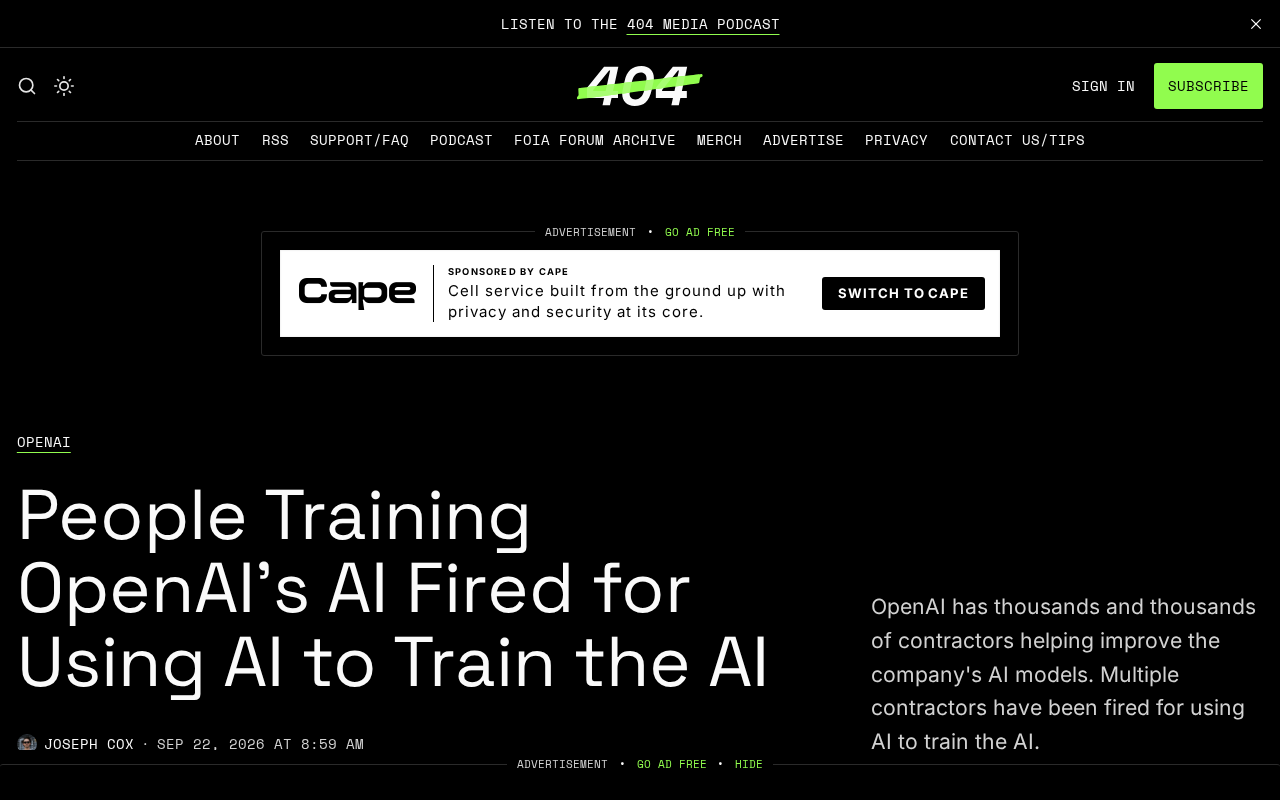
标注员用AI辅助AI训练任务因此被解雇,折射出RLHF数据真实性与标注行业结构性矛盾的深层悖论。
一则来自Hacker News的消息披露,为OpenAI提供数据标注服务的人员因使用AI工具辅助工作而遭解雇,引发行业讨论。这一事件触及大模型训练的核心质量问题:RLHF体系的价值依赖于人类反馈的真实性,标注员若借助AI生成答案,模型实际上是在学习另一个模型的输出偏好,而非人类真实意图,由此带来「模型坍缩」风险。与此同时,事件也暴露了数据标注产业的结构性困境——按件计酬、成本压缩的行业生态天然激励标注员提效,而公司却同时要求输出保持「纯人类」属性,两者难以调和。文章指出,行业需重新审视训练数据溯源机制、人机协作边界以及高质量人类反馈的合理定价,以应对AI生成内容渗透训练链路所带来的系统性挑战。
一则耐人寻味的行业新闻
一条来自Hacker News的消息引发了讨论:为OpenAI提供AI训练服务的数据标注人员,因为在训练过程中使用AI工具辅助工作而被解雇。这个略显荒诞的标题背后,折射出当前AI训练产业链中一个真实且值得深思的矛盾。
简单来说,这些人的工作是为AI模型提供高质量的人工标注和反馈数据——正是这些人类判断构成了模型对齐(alignment)和监督微调的基础。而当他们转而借助AI工具来完成本该由人类完成的判断时,整个训练逻辑就出现了自我指涉的悖论。
需要说明的是,该新闻在Hacker News上的讨论量有限(9个赞、1条评论),属于早期传播阶段,具体的公司名称、被解雇人数、事件细节等关键信息尚未在原始素材中充分披露。以下分析基于事件所揭示的行业现象展开。
为什么这件事并不好笑
表面上看,「用AI训练AI结果被开除」像是一个网络段子,但它触及了大模型训练中一个核心的质量控制问题:人类反馈的真实性。
当前主流大模型的训练依赖RLHF(基于人类反馈的强化学习)等技术,其价值恰恰在于「人类」二字。人类标注员被期望提供独立的、真实的偏好判断,帮助模型理解什么是「好的回答」。一旦标注员用ChatGPT类工具生成答案再提交,模型实际上是在学习另一个模型的输出,而非人类的真实意图。
这会导致所谓的「模型坍缩」(model collapse)风险——当训练数据越来越多地来自AI生成内容时,模型的多样性和准确性会逐步退化,错误被不断放大和固化。从这个角度看,公司对使用AI工具的标注员采取解雇措施,有其技术上的合理性。
RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)是目前ChatGPT、Claude等主流大模型对齐的核心技术路径。其基本流程分三步:首先收集人类标注员对模型输出的偏好比较(例如「回答A比回答B更好」);然后用这些比较数据训练一个「奖励模型」,学习人类的评价标准;最后用强化学习算法让主模型不断调整输出,以获得更高的奖励分数。整个流程的关键假设是:标注员的判断代表真实的人类偏好。一旦这些判断实际上来自另一个AI,奖励模型学到的就是「AI觉得什么答案好」而非「人类觉得什么答案好」,导致最终模型的价值对齐目标发生根本性偏移。这也是为什么在RLHF体系下,标注数据的「人类真实性」具有不可替代的技术价值,而非单纯的合规要求。
「模型坍缩」(Model Collapse)是近年来机器学习研究中被反复验证的现象。2023年多项学术研究(包括牛津大学与其他机构的联合研究)表明,当模型被训练在大量AI生成数据上时,会经历「统计退化」——模型输出的多样性逐代降低,尾部分布(即罕见但重要的知识和观点)被系统性地遗忘,最终模型趋向产出平庸、同质化的内容。类比生物学,这类似于近亲繁殖导致的基因多样性丧失。在标注场景中,如果大量标注员都用同一个AI工具(如ChatGPT)生成答案,训练数据实际上在向单一模型的输出分布收敛,长此以往会使被训练的模型失去捕捉人类认知多样性的能力。
数据标注产业的结构性困境
这起事件也暴露了数据标注行业长期存在的深层矛盾。
标注工作通常按件计酬、时间紧张、单价偏低,标注员天然有提高效率的动机。当唾手可得的AI工具能在几秒内产出一份看似合格的答案时,禁止使用几乎与人性激励相悖。换句话说,公司一边用极致的效率要求压缩成本,一边又要求人工输出保持「纯人类」属性,这本身就是难以调和的张力。
更微妙的是,随着AI生成内容质量提升,检测「这份标注是否由AI完成」变得越来越困难。公司需要投入额外的审核机制来识别掺水数据,这又进一步推高了训练成本。整个链条陷入了一种猫鼠游戏。
对AI训练流程的启示
这件事给整个行业提出了几个现实问题:
训练数据的可信度如何保障
如果连底层标注数据都可能被AI污染,模型厂商需要重新审视数据采集流程的完整性,包括更严格的溯源、抽样复核以及对标注员的资质与行为约束。
人机协作的边界在哪里
完全禁止标注员使用任何AI工具可能既不现实也不高效。行业或许需要探索一种规范化的人机协作模式——明确哪些环节可以借助AI提效,哪些核心判断必须由人类独立完成。
训练成本与质量的再平衡
真正高质量的人类反馈是稀缺且昂贵的。当低成本标注被AI「稀释」后,模型厂商可能不得不为真正可信的人类数据支付更高溢价。
一个时代的隐喻
「训练AI的人因为用AI而被开除」——这句话本身就是当下AI浪潮的一个绝妙隐喻。人类正在训练一个可能取代自己的系统,而在这个过程中,人类又忍不住用这个系统来偷懒。
它提醒我们,AI的能力提升并非凭空而来,其背后是庞大而隐形的人力劳动网络。当这个网络本身开始被AI渗透时,我们对「AI究竟学到了什么」这个问题,或许需要保持更多的警惕。
由于原始信息有限,这一事件的完整图景仍有待更多报道补充。但它所揭示的行业悖论,值得每一个关注AI发展的人认真思考。
相关推荐
Cursor三连发实测:Grokbot、Origin与Grok 4.6值得用吗?
How I AI博主深度实测Cursor/xAI三款新品:多智能体助手Grokbot、GitHub替代品Origin和Grok 4.6模型。多账号连接器成杀手锏,Grok 4.6设计能力出乎意料,Origin愿景清晰但仍处早期。
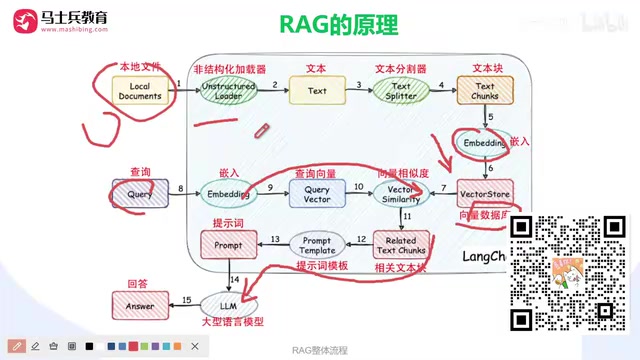
RAG系统深度解析:企业级私有知识库为何没那么简单
RAG(检索增强生成)系统看似简单实则复杂。本文拆解企业级私有知识库搭建全流程:数据加载切片、BGE-M3等开源embedding选型、多路检索与重排序、Agent动态路由及RAGAS评估,揭示RAG入门到实战的真实门槛。
AI公司加码伦敦:招聘扩张背后的欧洲布局信号
AI公司加码伦敦:招聘扩张背后的欧洲布局信号
一家科技公司发布伦敦招聘启事,由欧洲区负责人亲自宣布落地。从高级支持工程师与客户经理岗位设置,解读其在欧洲市场从进入到深耕的扩张战略信号。