一键部署ML模型:从Notebook到API端点的想法可行吗?
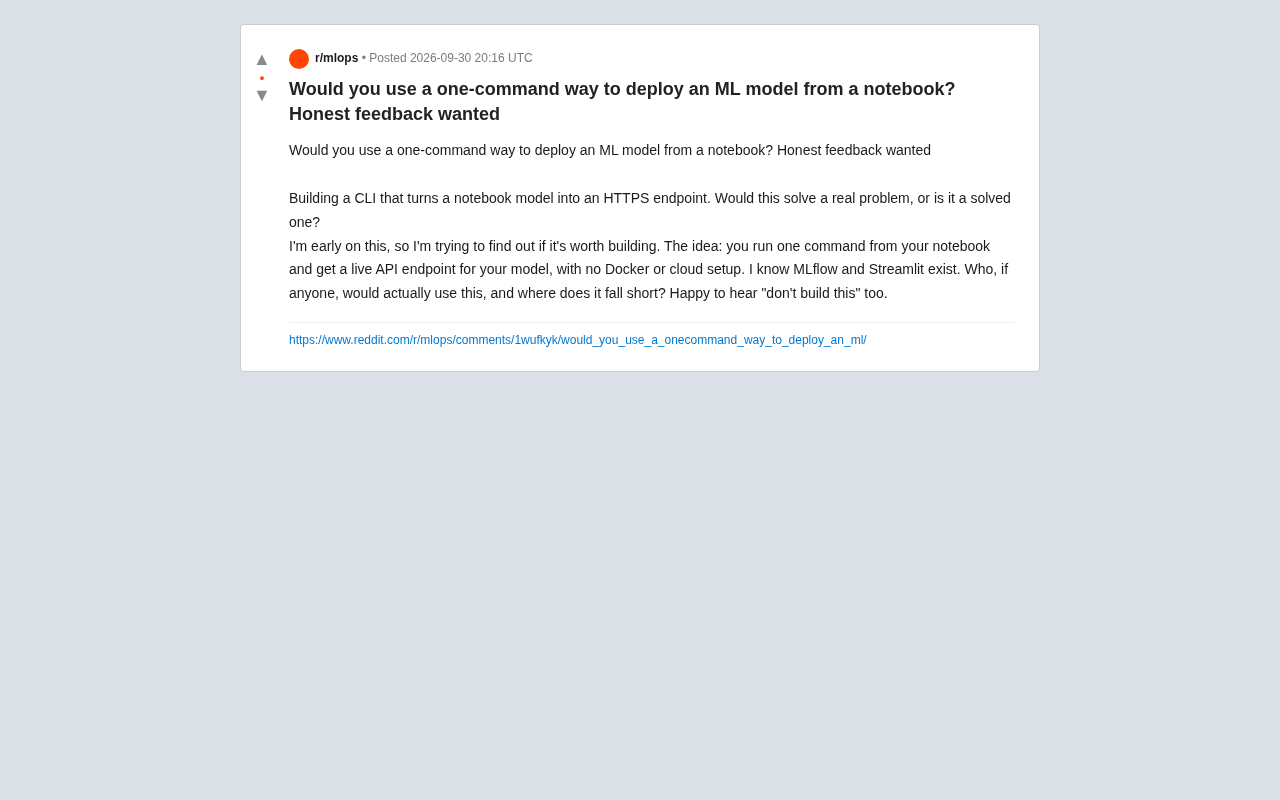
一位开发者验证「一键将Jupyter模型变成HTTPS API」的CLI工具是否填补了现有方案的部署空白。
一位开发者在Reddit发帖询问:是否有人愿意用一条CLI命令,把Jupyter Notebook中的ML模型直接变成HTTPS API端点,无需Docker或云配置?文章以此为切入点,分析了数据科学家在「训练完模型→可调用API」这一路径上长期面临的工程门槛——MLflow偏重生命周期管理,Streamlit面向Demo界面,各类云平台学习曲线陡峭,导致「快速获得可调用端点」的需求始终存在缝隙。该工具的核心价值在于降低部署摩擦,适合原型验证、教学演示与小团队协作场景;但并发处理、鉴权、监控等生产级复杂度,是「一键部署」承诺的主要天花板。文章最后指出,这条帖子本身也是一个产品验证范例——提前向目标用户征求反馈,比闭门开发更能降低试错成本。
一个来自开发者社区的真实提问
在Reddit上,一位早期开发者抛出了一个值得深思的问题:是否有人愿意使用一种「一键部署」的方式,把Jupyter Notebook中的机器学习模型直接变成HTTPS API端点?
这位开发者正在构建一个CLI工具,核心理念很直接——在Notebook里运行一条命令,就能得到一个可用的模型API端点,无需配置Docker,也不用搭建云环境。他坦言自己还处于早期验证阶段,想搞清楚这到底是解决了真问题,还是一个早已被解决的伪需求。
他甚至主动提到了MLflow和Streamlit这些现有方案,并诚恳地表示:「哪怕你告诉我『别做这个』,我也乐意听。」这种务实的态度,恰恰触及了ML工程化领域一个长期存在的痛点。
模型部署为什么一直是难题?
对很多数据科学家和ML研究者来说,训练模型和部署模型是两个割裂的世界。前者在Notebook里用几行代码就能完成实验,后者却往往需要跨越一道陡峭的工程门槛。
现有方案的门槛
从Notebook到生产环境,典型路径通常包括:把模型序列化、编写API服务代码(如FastAPI或Flask)、打包Docker镜像、配置云服务、设置网络与鉴权。每一步都可能卡住一个不熟悉DevOps的研究人员。
即便是成熟工具,也各有侧重:
- MLflow 强于模型的全生命周期管理与追踪,但要真正暴露成生产级端点,仍需额外的部署配置。
- Streamlit 面向的是快速搭建交互式Demo应用,本质上是给人看的界面,而非给程序调用的API。
- 各类云平台的托管服务(如SageMaker、Vertex AI)功能强大,但学习曲线和成本对个人开发者并不友好。
换句话说,「训练完直接得到一个能调用的API」这个看似简单的需求,在实践中依然存在缝隙。
FastAPI与Flask是Python生态中最常见的两种API框架。Flask历史更久、风格极简,适合快速搭建轻量服务;FastAPI则基于Python类型注解自动生成文档,原生支持异步处理,在ML推理服务场景下性能更优。两者都需要开发者手动编写路由逻辑、序列化/反序列化代码,并自行处理鉴权中间件——这对于习惯在Notebook里写探索性代码的数据科学家来说,意味着一次不小的思维模式切换。
Docker是目前工程化部署的事实标准容器化工具,通过将应用及其依赖打包成镜像,解决了「在我机器上能跑」的环境一致性问题。但对非工程背景的研究者而言,理解镜像层、编写Dockerfile、管理镜像仓库本身就构成额外的学习负担,也是从Notebook到生产环境之间最常见的卡点之一。
「一键部署」的价值与边界
这个想法真正的吸引力在于降低摩擦。对于原型验证、内部工具、教学演示等场景,开发者往往只想快速拿到一个能被前端或团队成员调用的端点,而不想为此学习整套云基础设施。
谁最可能使用它
- 独立开发者和小团队,需要快速把模型分享给协作者测试
- 数据科学教育场景,让学生直观理解「模型即服务」
- Hackathon或快速MVP验证,时间紧迫、不追求生产级稳定性
它可能在哪里失效
真正的挑战往往出现在「一键」之后。生产环境要求的并发处理、版本管理、监控告警、安全鉴权、成本控制,这些恰恰是工具需要抽象却又难以完全隐藏的复杂度。一旦用户的需求超出Demo级别,「无需配置」的承诺就会遇到天花板。
此外,安全问题不容回避:把Notebook中的模型一键暴露为公网HTTPS端点,鉴权、速率限制、数据隐私如何处理,直接决定了工具能否从「玩具」走向「可用」。
「并发处理」是生产环境与Demo环境最显著的分水岭之一。Notebook中的推理代码通常是单线程、单请求执行的,而真实的API端点可能同时面对数十乃至数百个并发请求。一旦没有配置异步处理、请求队列或多进程/多副本机制,服务就会在负载稍高时出现超时甚至崩溃。这类问题在本地测试阶段几乎不会暴露,往往只有到了真实流量环境下才会突然爆发,这也是「一键部署」工具如果缺乏底层并发设计,就难以突破Demo天花板的根本原因。
对开发者的启示
这条帖子本身其实提供了一个很好的产品验证范例。在动手大规模开发前,先向目标用户群体抛出问题、坦诚寻求反馈,比闭门造车更能降低试错成本。
对于类似的工具想法,判断是否值得做的关键不在于「现有方案是否存在」,而在于是否能在某个具体场景下把体验做到明显更好。MLflow和Streamlit的存在,不代表这个细分需求已被完美满足——恰恰相反,它们各自的定位偏差,正是新工具的机会所在。
如果这个CLI能把「从实验到可调用端点」的时间从数小时压缩到数秒,同时在安全与可扩展性上给出合理的渐进路径,它就有可能填补一块真实的空白。而如果只是又一个功能重叠的轻量包装,那么社区里「别做这个」的声音也值得认真对待。
相关推荐

NFL为何重金押注旗帜橄榄球?安全与商业的双重博弈
NFL为何重金投资没有擒抱对抗的旗帜橄榄球?本文解析CTE脑病争议、女子体育数十亿美元市场与奥运机遇如何共同驱动联盟布局橄榄球的未来。

Asana浏览器智能体成本降76倍:GPT-6模型优化实测
Asana借助OpenAI的GPT-6 Astra模型与Codex工具,在浏览器智能体测试中将模型成本降低76倍、速度提升5倍。本文解读这一工程优化案例对企业AI落地的成本与性能启示。

@ai-sdk/vue 3.0.303 发布:依赖更新的补丁版本
@ai-sdk/vue 3.0.303 补丁版本发布,核心为依赖项同步升级,核心包 ai 升级至 6.0.303。本文解析该 Vue AI SDK 更新内容及对开发者的意义。