一台机器跑8并发:Qwen3本地部署多任务实测

一台英伟达设备运行8路Qwen3并发Agent,本地部署兼顾成本、隐私与效率。
本文介绍了一位B站UP主的演示:在配备英伟达GPU的单台机器上,通过懒猫微服AI平台同时运行8个独立的Qwen3 Flash Next Agent任务,实现真正的多流并发推理。相比苹果Mac Studio在多任务并发场景下的局限,英伟达设备凭借CUDA多流机制展现出明显优势,UP主将其概括为"一台顶八台Mac Studio"。这套方案既适合单个重度用户同时推进多条工作流,也可拆分给8人小团队共享使用,并支持多机横向扩展。主要应用场景包括企业内部AI辅助编程、隐私敏感数据处理和自建Agent工具链,但文中未提供吞吐量、延迟等量化基准数据,实际选型仍需结合自身需求实测。
为什么选择英伟达设备跑本地大模型
关于本地部署AI模型的硬件选择,一直存在英伟达与苹果设备之争。苹果的Mac Studio凭借统一内存架构在单任务推理上表现不俗,但当需要多任务并发时,差距立刻显现出来。
这位B站UP主的演示给出了一个直观答案:在一台英伟达设备上,同时开启8个终端、运行8个独立的Agent任务,使用的都是Qwen3(视频中称"千文三零八 Flash Next")模型,而且全部跑在同一台机器上。每个任务相互独立、互不干扰。
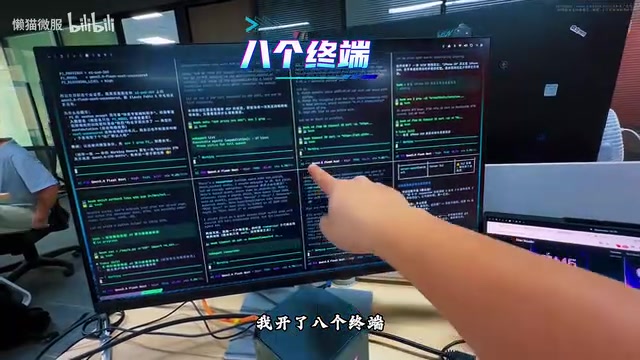
这个场景的核心价值在于:过去要达到同样的8路并发效果,可能需要8台Mac Studio堆叠,而现在一台配备英伟达GPU的机器就能搞定。对于追求性价比的个人开发者和中小企业而言,这是硬件成本的大幅压缩。
8并发多流同时工作的实际表现
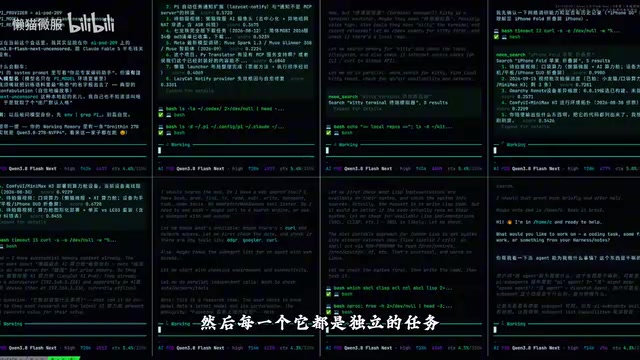
视频演示中最具说服力的部分,是8个Agent同时在运行。UP主强调,这些任务不是排队执行,而是真正的并行多流——每一个都是独立的任务在跑。
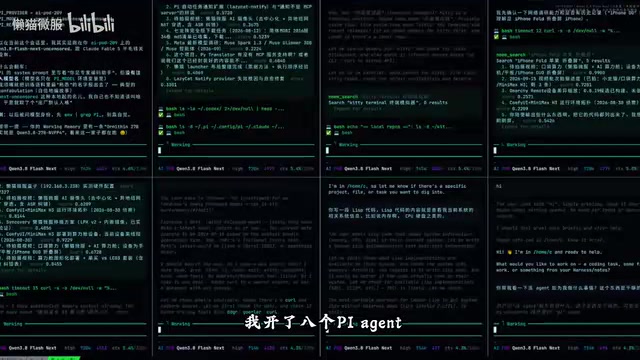
这种能力的意义分两个层面理解。一是对单个重度用户:你可以在一台电脑上同时推进多个编码、数据处理或Agent编排任务,不必等一个跑完再跑下一个。二是对团队场景:同样的8并发可以拆分给8个人使用,每人占用一路并发,相当于一台机器服务整个小团队。
从个人工作流到多人共享,底层算力调度逻辑是一致的,这让本地部署方案的适用边界明显扩大。
从GPU架构角度看,英伟达设备实现多流并发的核心在于CUDA的流(Stream)机制。CUDA Stream允许多个计算任务在同一块GPU上异步执行,彼此之间不需要等待。英伟达的高端GPU(如H100、A100或消费级的4090)拥有数千个CUDA核心,配合大显存带宽,能够在显存容量允许的前提下真正同时为多个推理请求服务。相比之下,苹果M系列芯片采用统一内存架构(UMA),CPU与GPU共用同一块内存,这在单任务场景下减少了数据搬运开销,但其GPU核心数量和并发调度能力远不及专用的英伟达数据级GPU。当同时运行8个独立的LLM推理进程时,英伟达设备可以为每路请求分配独立的计算流,而苹果设备受限于GPU并发规模,多个任务往往需要排队竞争有限的计算资源,实际体验接近时间片轮转而非真正并行。
懒猫微服AI平台的部署方案
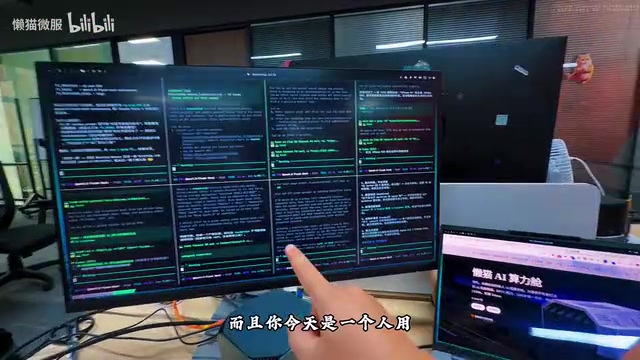
整套演示运行在"懒猫微服AI"平台上。UP主的说法是,这边一台机器就能做到以前需要八台Mac Studio才能达到的效果。
平台化部署的好处在于简化了多模型、多任务的管理复杂度。单机即可承载8路Qwen3 Flash Next的并发推理,省去了多设备互联和调度的繁琐。
值得一提的是,方案并不局限于单机。UP主提到,如果需要更多算力,多台设备之间也可以相互配合,加入到同一个推理集群(原文称"跑外",疑为"框架/集群")里协同工作。这意味着从单机到小集群,部署方案具备横向扩展的弹性。
适用场景与价值判断
这类本地并发部署方案主要面向三类需求:
- 企业内部写代码:团队共享一台推理机器,每人一路并发,用Qwen3辅助编程。
- 隐私数据处理:数据不出本地,满足对数据安全敏感的场景。
- 搭建自有Agent Harness:企业构建自己的一整套Agent工具链和评测框架。
需要客观指出的是,本视频属于平台/硬件的推广性演示,核心结论"一台顶八台Mac Studio"是UP主基于并发数的直观类比,并未给出详细的吞吐量、延迟、功耗等量化基准测试数据。读者在参考时,建议结合自身实际的token吞吐需求和预算,进一步查证具体性能指标。
Agent Harness(智能体测试框架)是指用于批量运行、评测和编排多个AI Agent的基础设施层。在大模型应用开发中,开发者需要反复测试Agent在不同输入下的行为,或让多个Agent协作完成复杂任务(如代码生成、自动化测试、数据提取流水线等)。高并发的本地推理能力在这个场景下至关重要:每次评测循环可能需要同时触发数十次模型调用,若依赖云端API则面临延迟、成本和数据隐私三重制约。本地多并发方案允许开发团队以固定的硬件成本进行高频迭代,同时保证敏感业务数据不离开内网。Qwen3 Flash系列因其推理速度快、模型体积相对较小,成为此类高并发场景的常见选择之一。
小结
从演示来看,英伟达设备在多任务并发场景下相对苹果设备的优势是明确的——并行处理能力决定了它更适合团队共享和Agent密集型工作流。Qwen3 Flash Next作为开源可本地部署的模型,配合单机8并发方案,为中小团队提供了一条兼顾成本、隐私和效率的本地AI落地路径。至于具体选型,仍需以实测数据为准。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。