一条整数序列就能指纹识别大模型?NumPrint基准发布

新论文提出NumPrint基准与SMCT模型,用单条294个整数的序列即可高准确率识别模型身份。
针对第三方API平台可能以次充好、路由到廉价模型的问题,论文提出用模型生成的固定长度整数序列作为身份指纹。作者构建了NumPrint基准,覆盖51个模型、5,036条答案,使用中英日三语提示要求模型一次生成294个1到355之间的整数。为从序列中提取数值偏好模式,作者设计了结合浅层MLP与因果Transformer的SMCT架构。在51类闭集评估中,单条序列准确率达92.72%,使用两条和四条答案可分别提升至96.06%和97.12%,但边际收益递减。该方案为API调用成本敏感或响应次数受限的场景提供了低成本验证手段,但跨版本稳定性与对抗性攻击风险尚未讨论。
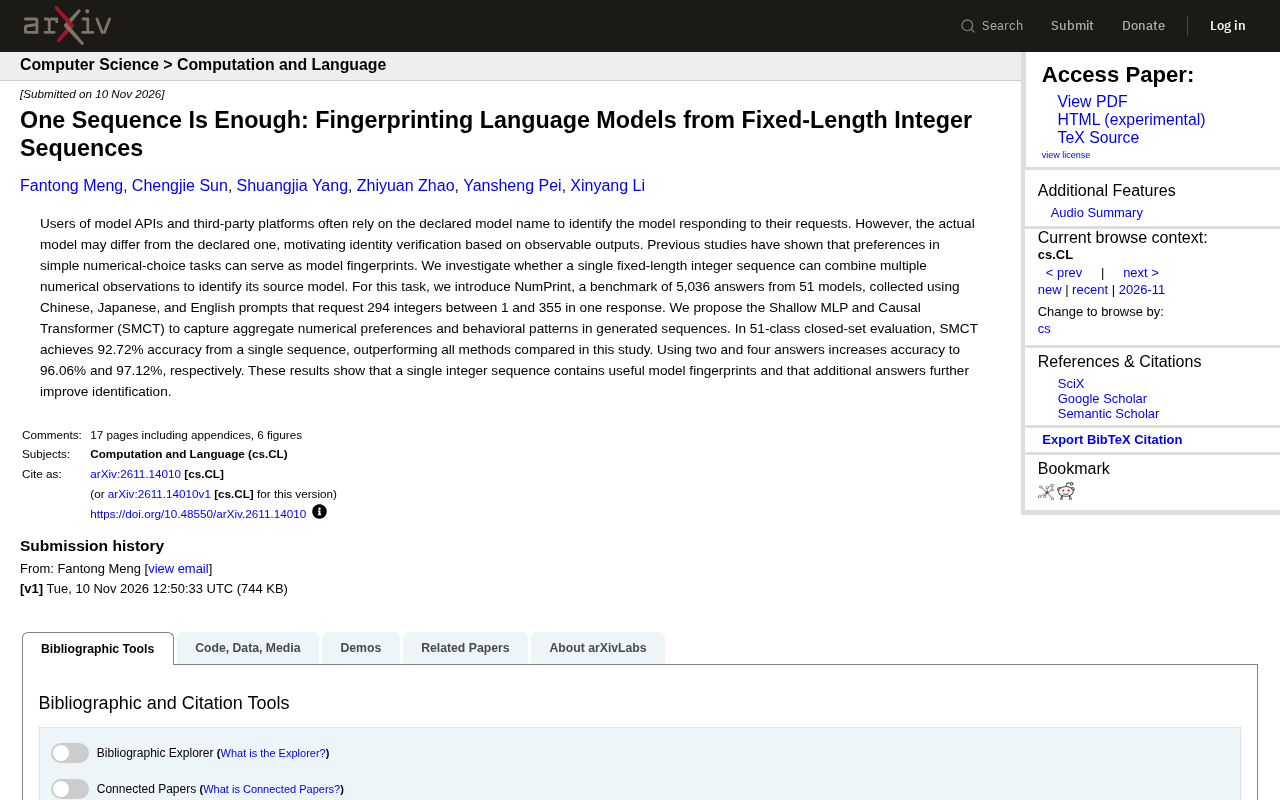
当你调用一个模型API时,你看到的模型名称可能并非实际为你服务的模型。第三方平台以次充好、路由到廉价模型的情况并不罕见。如何在不依赖声明的情况下验证模型身份?一篇新论文给出了一个 surprisingly simple 的答案:让模型生成一条固定长度的整数序列,就能以极高准确率识别其来源。
模型身份验证的困境与数值指纹思路
论文开篇指出了一个现实问题:用户往往只能依赖平台声明的模型名称来判断响应来源,但实际模型可能与声明不符。这种信息不对称催生了基于可观测输出的身份验证需求。
此前研究已经发现,模型在简单数值选择任务中表现出的偏好可以作为指纹——不同模型对特定数字有系统性偏好,这些偏好模式具有区分度。但以往方法通常需要多次独立查询,效率不高。
这项研究进一步追问:能否用单条固定长度的整数序列同时捕获多个数值观察,从而一次性完成模型识别?
NumPrint基准:5,036条答案覆盖51个模型
为回答上述问题,作者构建了NumPrint基准。据论文描述,该基准包含来自51个模型的5,036条答案,使用中文、日文和英文三种提示词,要求模型在一次响应中生成1到355之间的294个整数。
这种设计将多个数值观察压缩到一条序列中,既提高了信息密度,也模拟了真实场景中用户可能只获得一次响应的约束。多语言提示的加入则增加了基准的覆盖面和挑战性。
SMCT模型:从序列中提取行为模式
为捕捉生成序列中的聚合数值偏好和行为模式,作者提出了Shallow MLP and Causal Transformer(SMCT)架构。该模型结合了浅层MLP与因果Transformer,前者可能负责提取全局统计特征,后者则建模序列中的局部依赖关系。
论文没有披露SMCT的具体层数或参数量,但从命名和任务性质推测,其设计注重效率——毕竟输入只是一条294个整数的序列,无需过度复杂的网络。
因果Transformer(Causal Transformer)是一种仅使用Transformer解码器堆栈、通过因果掩码确保每个位置只能关注其之前位置的序列模型。与BERT类双向编码器不同,因果Transformer天然适合自回归建模,但其逐位置因果注意力的结构同样适用于从有序序列中提取局部依赖特征。在本任务中,输入是一条294个整数的序列,因果掩码使模型在编码第t个整数时只能利用前t-1个整数的信息,这有助于捕捉数值偏好随序列位置变化的动态模式,而非将序列视为无序集合。
浅层MLP(Shallow MLP)指仅含少量隐藏层(通常1-2层)的多层感知机。在SMCT中,它可能作用于序列的全局池化表示或逐位置特征,负责提取与顺序无关的聚合统计量(如均值、方差、特定数值的频次分布等),与因果Transformer的局部时序建模形成互补。两者的结合使模型既能感知“哪些数字出现了多少次”,也能感知“数字以何种顺序出现”,从而更全面地刻画生成序列中的模型指纹。
实验结果:单序列准确率92.72%,多序列进一步提升
在51类闭集评估中,SMCT仅凭单条序列就达到92.72%的准确率,优于研究中对比的所有方法。当允许使用两条和四条答案时,准确率分别提升至96.06%和97.12%。
这些数字说明两点:第一,单条整数序列确实蕴含足够的模型指纹信息;第二,增加答案数量能进一步缓解混淆,但边际收益递减——从一条到两条提升约3.3个百分点,从两条到四条仅提升约1.1个百分点。
与以往需要多次查询的方法相比,NumPrint+SMCT在效率上有明显优势,尤其适合API调用成本敏感或响应次数受限的场景。
闭集评估(closed-set evaluation)指测试样本的类别必然属于训练阶段已见过的类别集合。在本文中,51类闭集意味着评测时待识别的模型一定是NumPrint基准中收录的51个模型之一,SMCT只需在已知的51个候选者中做区分,而不需要判断“该序列是否来自一个从未见过的模型”。这种设定简化了任务,因为模型无需处理开放集识别中的拒识问题。真实场景中,用户面对的可能是基准未覆盖的新模型或微调变体,此时闭集准确率会高估实际可用性。因此,92.72%应理解为“在候选模型集合已知且封闭条件下的识别上限”,而非任意API调用下的通用准确率。
局限与启示
论文未讨论跨模型版本更新后的指纹稳定性,也未涉及对抗性攻击——如果模型厂商刻意改变数值偏好,指纹是否失效仍是未知数。此外,51个模型的闭集设定与真实世界的开放模型生态仍有差距。
尽管如此,这项研究传递出一个清晰信号:模型的数值行为模式是一种廉价且有效的身份信号。对于依赖第三方API的开发者,这提供了一种低成本验证手段;对于模型提供商,则意味着“换模型不换名”的做法将越来越容易被识破。
论文标题“One Sequence Is Enough”或许略带营销色彩,但92.72%的单序列准确率确实让这个说法站得住脚。
对抗性攻击在模型指纹语境下,指模型提供商或第三方平台主动修改模型的输出分布,使指纹特征偏离原有模式,从而逃避身份识别。具体手段可能包括:在系统提示中注入指令要求模型避免特定数值偏好、对输出整数序列进行后处理扰动、或在路由层对指纹查询返回伪造响应。由于NumPrint依赖模型在数值选择任务中的系统性偏好,这类偏好理论上可以通过微调或推理时的分布约束被削弱。论文未评估此类攻击的有效性,意味着当前92.72%的准确率建立在“模型未刻意隐藏身份”的假设之上。若指纹验证被广泛采用,攻防博弈可能随之出现,指纹的鲁棒性将成为后续研究的关键问题。
相关推荐
美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。