英伟达Nemotron竞赛编程模型IOI首超人类最强选手
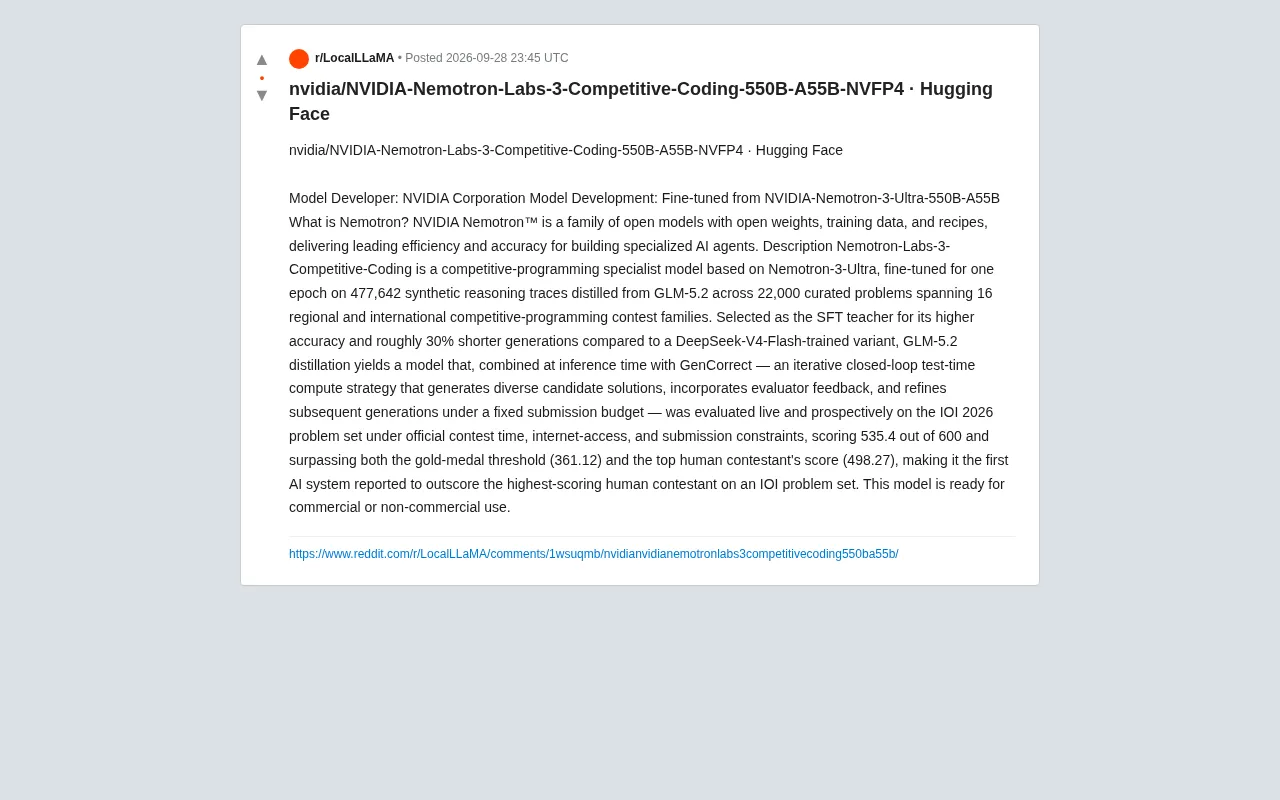
英伟达开源550B竞赛编程模型,IOI 2026题集得535.4分,首次超越人类最高分选手。
英伟达在Hugging Face发布了竞赛编程专用开源模型NVIDIA-Nemotron-Labs-3-Competitive-Coding,基于550B-A55B架构的Nemotron-3-Ultra微调而来,采用NVFP4低精度量化。训练数据为从GLM-5.2蒸馏的近48万条合成推理轨迹,覆盖22,000道竞赛题目。推理阶段采用GenCorrect迭代闭环策略,通过评估器反馈在固定提交预算内不断优化候选解。在遵守正式竞赛约束条件的IOI 2026题集实测中,该模型取得535.4分(满分600),超越金牌门槛(361分)及最高分人类选手(498.27分),成为首个在IOI题集上超越人类最强成绩的AI系统。英伟达将其开放商用,同时验证了「合成数据蒸馏+测试时计算」这套方法论在专业化AI智能体构建上的可行性,但相关数据尚待独立第三方复现验证。
英伟达在Hugging Face上发布了一款名为NVIDIA-Nemotron-Labs-3-Competitive-Coding的竞赛编程专用模型,这款拥有5500亿参数(激活550亿,即550B-A55B架构)的开源模型,据官方描述在国际信息学奥林匹克竞赛(IOI)的问题集上取得了超越人类最强选手的成绩,成为首个在IOI问题集上得分超过最高分人类选手的AI系统。
从Nemotron-3-Ultra微调而来的专家模型
Nemotron是英伟达推出的开放模型家族,其特点在于同时开放权重、训练数据和训练配方,主打为构建专业化AI智能体提供高效率与高精度的基础。这次发布的竞赛编程模型基于Nemotron-3-Ultra-550B-A55B微调而来,采用了NVFP4的低精度量化格式,这也符合英伟达在推理效率上的一贯技术路线。
模型的微调过程颇具看点。团队在477,642条合成推理轨迹上进行了一个epoch的微调,这些数据从GLM-5.2蒸馏而来,覆盖了22,000道精选题目,横跨16个区域性和国际性竞赛编程赛事体系。这种规模的数据构建,反映出竞赛编程这一垂直领域对高质量推理数据的强依赖。
为什么选择GLM-5.2作为教师模型
一个值得关注的技术决策是SFT(监督微调)教师模型的选择。团队对比了两种方案:一种基于DeepSeek广告-V4-Flash训练的变体,另一种基于GLM-5.2蒸馏。
最终选择GLM-5.2的原因有两点:其一是更高的准确率,其二是生成长度大约缩短了30%。在竞赛编程这类需要大量推理链条的任务中,生成长度直接关系到推理成本和延迟,更短的生成意味着在同等算力预算下能探索更多候选解。这一权衡体现了在实际工程落地时,精度与效率需要同时纳入考量。
SFT(Supervised Fine-Tuning,监督微调)中的「教师模型蒸馏」指的是:用一个能力更强的大模型生成高质量的「思维过程+答案」数据对,再用这批数据对目标模型进行有监督训练。与直接用人工标注相比,蒸馏可以大规模、低成本地构建推理轨迹数据。GLM-5.2是智谱AI旗下的推理模型,其在代码与数学推理上生成的链式思维(Chain-of-Thought)较为简洁精炼。生成长度缩短30%这一指标在工程上意义重大:竞赛编程问题的推理链往往绵延数千token,更短的轨迹意味着单次推理的KV Cache占用更低、批处理吞吐量更高,在使用GenCorrect进行多轮迭代时,累计的算力节省十分可观。
GenCorrect:闭环测试时计算策略
模型能取得突破性成绩,除了微调本身,推理阶段的策略同样关键。团队采用了名为GenCorrect的迭代闭环测试时计算(test-time compute)策略。
这套机制的运作逻辑是:先生成多样化的候选解,再引入评估器(evaluator)反馈,然后在固定的提交预算下对后续生成进行迭代优化。换句话说,模型不是一次性给出答案,而是在有限的提交次数约束内不断自我修正——这与人类选手在竞赛中反复调试、根据评测反馈改进代码的过程高度相似。
这种测试时计算的思路,正是当前推理模型领域的重要方向。通过在推理阶段投入更多计算来提升最终结果质量,而非单纯依赖模型参数规模,为专业化任务提供了新的性能提升路径。
测试时计算(Test-Time Compute,TTC)是近年推理模型领域兴起的核心范式,与传统「训练时扩展」思路形成互补。传统方法通过增加训练数据量和模型参数来提升性能,而TTC则在推理阶段动态分配更多计算资源——例如生成多条候选路径后择优、进行多轮反思与自我纠错。OpenAI的o系列模型和DeepSeek-R1均是该范式的代表。GenCorrect的特殊之处在于引入了「外部评估器反馈」这一闭环机制:模型提交代码后,评估器(通常是沙箱执行环境)会返回测试通过情况,模型据此修订方案。这与「最佳候选采样(Best-of-N)」等开环策略不同,外部信号使得每一轮迭代都有信息增益,而非盲目重试,这也正是竞赛编程场景天然适合TTC的原因——题目本身提供了明确的判题反馈。
IOI 2026实测成绩:535.4分
最具分量的数据来自实测环节。该模型在IOI 2026问题集上进行了实时、前瞻性的评估,且严格遵守官方竞赛的时间限制、联网访问和提交约束条件。
最终成绩为535.4分(满分600),这一分数:
- 远超金牌门槛(361.12分)
- 超过了当届最高分人类选手的成绩(498.27分)
这意味着在受控且真实的竞赛条件下,该AI系统首次在IOI问题集上超越了得分最高的人类参赛者。对于长期被视为人类顶尖智力竞技场的信息学奥赛而言,这是一个标志性的节点。
需要保持审慎的是,这些数据均来自英伟达官方的模型说明,尚未见到独立第三方的完整复现验证。竞赛条件下的评估细节、题目难度分布以及与人类选手的对比口径,都值得社区进一步审视。
国际信息学奥林匹克竞赛(IOI)是面向中学生的最高规格算法竞赛,每年吸引全球90余个国家和地区的顶尖选手参与。竞赛采用部分分制,每道题满分100分,共6道题,总分600分。选手以个人身份参赛,比赛分两天进行,每天限时5小时,可多次提交并即时获得评测反馈。金牌通常授予得分位于前十二分之一的选手,历届金牌门槛因题目难度浮动,但通常在300-400分区间。此次英伟达模型取得535.4分,不仅大幅越过金牌线,更超越了当届得分最高的人类选手(498.27分)。值得注意的是,IOI 2026竞赛尚未正式举办,英伟达使用的是预发布题目集进行前瞻性测试,这与DeepMind此前在IOI 2024上以AlphaCode 2进行闭卷测试的情形类似,题目的代表性与评测口径仍有待社区核验。
开放模型的商业意义
英伟达明确标注该模型可用于商业或非商业用途,这延续了Nemotron家族的开放定位。对于开发者和企业而言,一个在特定垂直领域达到甚至超越人类顶尖水平的开源模型,其价值不仅在于竞赛本身,更在于验证了「合成数据蒸馏 + 测试时计算」这套方法论在专业化AI智能体构建上的可行性。
竞赛编程作为算法推理能力的高浓度试金石,模型在此领域的突破往往能外溢到更广泛的代码生成、逻辑推理和问题求解场景。随着开放权重、开放数据和开放配方的完整释出,这一成果对整个AI编程生态的推动作用值得持续观察。
相关推荐
Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。
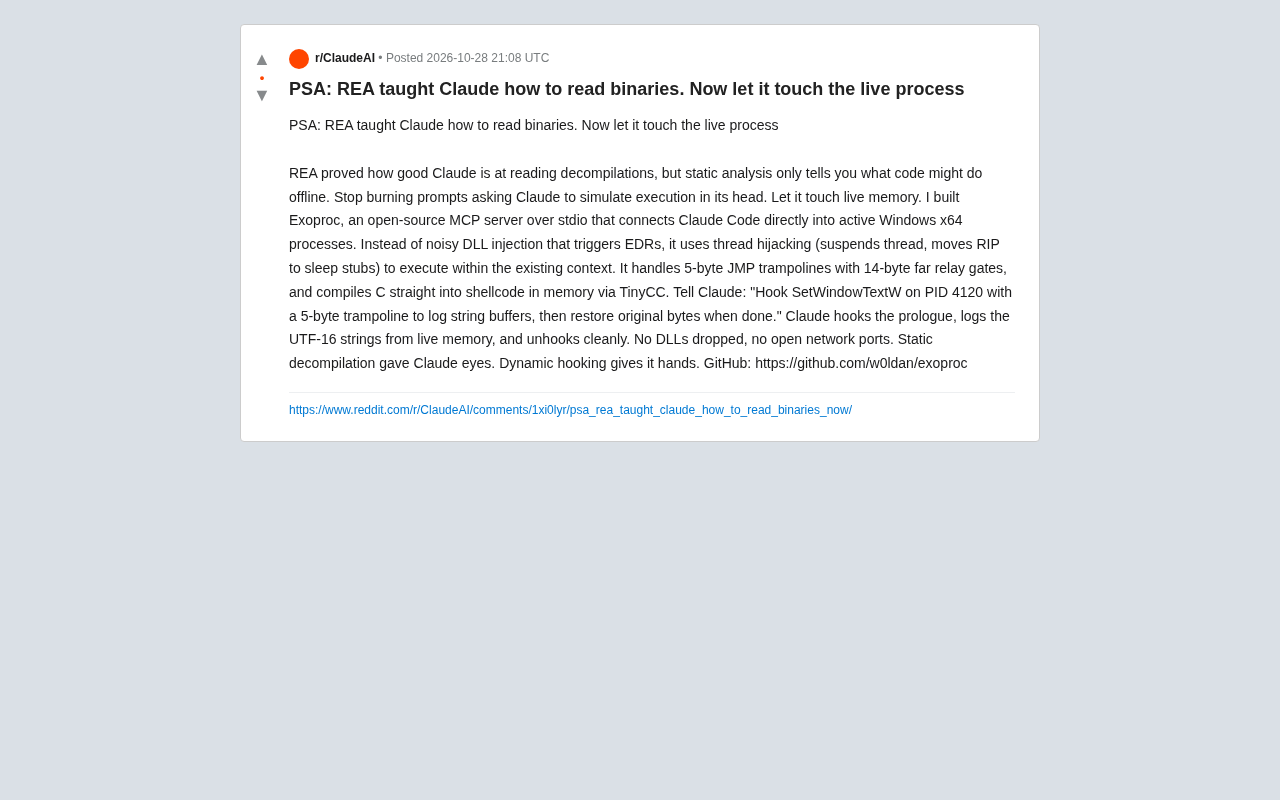
给Claude装上"手":Exoproc开源MCP服务器实现活体进程钩子
Exoproc是一个开源MCP服务器,让Claude Code通过线程劫持直接挂钩活跃Windows x64进程,绕过EDR实现动态分析。静态反编译给Claude眼睛,动态钩子给它双手。