英伟达NV-Reason-CT:原生3D视觉语言模型解读CT影像

英伟达开源NV-Reason-CT,首个原生3D视觉编码器对接大语言模型、可逐步推理生成CT放射学报告的医学影像模型。
英伟达开源的NV-Reason-CT是一款原生3D医学影像语言模型,专为CT扫描设计。它用原生3D视觉编码器将体数据切分为13,824个带空间坐标的视觉token,端到端对接QWEN 3.5语言模型,从根本上避免了主流视觉语言模型因切片采样或体数据压缩而造成的空间信息丢失。训练采用两阶段策略:先用约55万问答样本和7万CT体数据进行监督微调,再以诊断准确性为奖励信号进行强化学习优化。模型支持生成结构化放射学报告、回答问题及逐步展示推理过程,在CT-RATE异常检测基准上无需专用分类头即取得最高macro F1。模型权重、代码及论文已全面开源,为医学AI研究提供了从"适配平面图像"到"原生理解三维数据"的架构参考。
英伟达近日开源了一款名为 NV-Reason-CT 的医学影像模型,它能够以原生 3D 方式读取 CT 扫描,逐步推理并生成放射学报告。与此前大多数将 CT 当作一叠平面图像处理的视觉语言模型不同,NV-Reason-CT 从一开始就保留了完整的三维空间信息,试图解决医学影像 AI 中一个长期被忽视的痛点。
为什么现有视觉语言模型读不好CT
一次 CT 扫描包含数百张切片,构成胸部和腹部的完整三维记录。然而主流视觉语言模型是为平面图像设计的,面对 CT 时只能采样少数几张切片,或者把整个体数据压缩成寥寥几个 token。无论哪种做法,关键的空间细节在推理开始之前就已经丢失了。
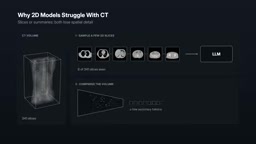
这种信息损失在医学场景中尤其致命——一个微小的钙化结节、一处病灶的三维位置关系,往往决定了诊断结论。英伟达团队因此选择了一条不同的技术路线:用原生 3D 视觉编码器直接处理体数据。
原生3D架构:从编码器到语言模型端到端训练
NV-Reason-CT 的核心是一个原生 3D 视觉编码器,它将输出喂给 QWEN 3.5 语言模型,两者进行端到端联合训练。这种设计让模型能够写出结构化的放射学报告、回答问题,并展示针对胸部和腹部 CT 的推理过程。
在数据预处理阶段,团队使用名为 MoniTransforms 的处理器加载扫描、重采样,并自动裁剪出胸部或腹部区域。视觉编码器随后将体数据切分为 3D 网格的 patch,共生成 13,824 个视觉 token,每一个 token 都会连同其在三维空间中的位置标记一起送入语言模型。
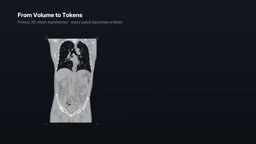
这种“每个 token 都带 3D 坐标”的做法,是模型保留空间推理能力的关键。相比把三维压扁成二维,它让语言模型在推理时仍能理解解剖结构的立体关系。
3D patch 划分的思路借鉴自视觉 Transformer(ViT)对图像的处理方式:将输入空间切成规则的小块,每块用一个向量表示后再送入注意力机制。对二维图像而言,一个 patch 是 H×W 的像素矩形;对体数据而言,patch 则变成 H×W×D 的立方体,因此也常被称为"tube"或"cuboid"。13,824 这个数字意味着模型需要在上下文窗口中同时处理约 1.4 万个视觉 token,对语言模型的长序列能力是显著的压力测试。附加的 3D 位置编码(通常以正弦函数或可学习嵌入的形式嵌入)让每个 token 携带其在 x、y、z 三个轴上的坐标信息,使语言模型在跨层传播注意力时能感知解剖结构的空间邻近关系,而不是把所有 token 视为无序集合。
训练数据与强化学习微调
模型的训练规模相当可观:约 55 万个问答样本,来自大约 7 万个 CT 体数据,推理过程由放射科医生实际记录的阅片结果来引导。
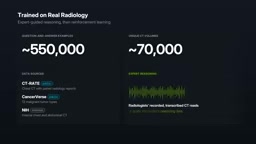
训练分为两个阶段:先进行监督微调,再用强化学习进一步优化——奖励信号直接针对“是否正确识别出影像所见”。这种以诊断准确性为导向的强化学习,意味着模型优化的目标与临床关注点高度一致,而非单纯追求语言流畅度。
这里提到的强化学习微调在大语言模型领域通常指 RLHF(基于人类反馈的强化学习)或其变体,但在医学影像场景中奖励信号的来源有所不同:不再依赖人工偏好打分,而是直接以结构化报告中的"影像所见"字段作为可量化的参考答案,计算模型输出与放射科医生记录之间的匹配程度来给出奖励。这种"基于结果的强化学习"(Outcome-Based RL)的优势在于,它迫使模型优化最终的诊断结论是否正确,而非优化语言是否通顺或篇幅是否合理。近期在推理模型(如 DeepSeek广告-R1)上的研究表明,这类以可验证结果为奖励的强化学习能够显著提升模型的逻辑推理链质量,医学影像报告生成任务也具备类似的可验证性,因此这一策略在此处的迁移有较强的方法论依据。
实际推理表现与基准成绩
在官方演示中,用户可以要求模型对一次胸部扫描做完整分析。模型会逐步走过各个解剖部位,依次指出肺气肿、微小钙化结节、食管裂孔疝等发现,最后给出一组确定的结论。
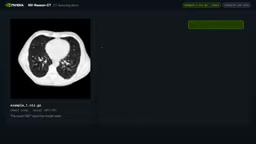
模型支持灵活的交互模式:可以关闭“思考”过程获得快速的是/否回答,也可以针对同一次扫描持续追问。在 CT-RATE Abnormality 基准测试中,NV-Reason-CT 仅凭一个简单的是/否提示、不依赖任何分类头,就取得了对比中最高的 macro F1 分数。这说明它的异常检测能力并非来自专门的分类模块,而是源于语言模型本身的推理。
CT-RATE 是一个公开的大规模胸部 CT 数据集与基准,包含配对的放射学报告和多标签异常标注,常用于评估模型对肺结节、气胸、肺气肿等病变的检测能力。Macro F1 分数对每个类别赋予相同权重后取平均,因此对罕见病变类别同样敏感——这与临床实践高度吻合,因为漏诊低频但高危的病变后果往往比误诊常见病变更严重。NV-Reason-CT 无需在输出层附加专用分类头就能取得最高 macro F1,说明其对"异常"的识别能力完全内化在语言模型的生成概率中,具有较好的零样本泛化潜力,也为后续在其他影像模态或病变类型上的迁移提供了参考。
开源生态与可获取性
NV-Reason-CT 目前已经全面开放:模型权重托管在 Hugging Face,代码和微调脚本连同一个配套 skill 发布在 GitHub,相关论文则可在 arXiv 查阅。对于希望在医学影像领域构建应用或开展研究的团队而言,这种完整的开源配套降低了复现与二次开发的门槛。
从技术意义上看,NV-Reason-CT 代表了多模态模型从“适配平面图像”向“原生理解三维医学数据”的转变。它既保留了可解释的逐步推理,又在客观基准上验证了准确性,为后续的医学 AI 研究提供了一个值得参考的架构范式。
相关推荐

DeepSeek开源DeepInfer:推理框架到底有什么用?
DeepSeek开源推理框架DeepInfer,采用Apache 2.0许可证,支持DeepSeek V4.1 Flash离线推理。本文解析其请求调度、FlashMLA/DeepGEMM计算优化、DSPark投机验证加速以及对开发者和普通用户的实际意义。

开源AI学习智能体:从拓扑图到试卷生成的全流程体验
探索开源AI学习智能体:基于DeepSeek API,通过拓扑图构建知识体系,支持自动文档生成、笔记、超级文档和试卷考试。了解其Agent工作流与设计亮点。

开源大肥鱼Pro桌宠:集成AI对话与音乐联动,全平台安装指南
大肥鱼Pro版开源桌宠集成AI对话、唱歌分声与音乐软件联动,支持Windows、Linux、macOS全平台。本文介绍其核心功能与两种安装方式,包括直接通过GitHub部署和借助AI助手代装,适合桌面美化与AI应用爱好者参考。