英伟达Rubin让Devin吞吐提升4.8倍,但它真的更快了吗?

英伟达Rubin服务器让Devin每GPU吞吐量提升4.8倍,但这主要是容量与成本的故事,而非用户体验的直接提速。
AI编程公司Cognition在英伟达最新Rubin服务器上测得单GPU token吞吐量提升4.8倍,但这个数字的真实含义远比字面更复杂。4.8倍衡量的是在两代系统用户响应速度完全相同的基准点上,单块GPU每秒处理的总token之比——本质上是容量和成本的提升,而非单用户加速。由于编程智能体以"模型输出→工具执行→结果返回"的循环方式工作,token吞吐量直接决定了Cognition能服务多少用户、以多低的成本运行。然而实际节省尚不确定,因为Rubin的租用价格至今未公布;而即便节省真实存在,任务中发生在模型之外的构建与测试环节仍会限制端到端加速幅度,Devin完成任务的速度不会同比提升4.8倍。
9月30日,AI编程公司Cognition成为首个在英伟达最新AI服务器Vera Rubin上运行其编程智能体Devin的客户。这批服务器从云厂商CoreWeave租用而来。Cognition宣称,相比上一代服务器,Rubin每秒处理的token数量最高提升至4.8倍——而token正是AI模型读写的最小文本单元。
英伟达早在年初就承诺,Rubin将把token成本压低至多10倍。但一个关键问题随之而来:Devin会因此变得更快、更便宜,还是两者兼得?而这个被反复引用的"4.8倍",到底测的是什么?
4.8倍到底衡量了什么
Cognition自己的说明给出了第一条线索:在Rubin上,每个用户得到答案的输出速度与旧系统相同。这意味着单块GPU如今能同时为更多用户完成远超以往的工作量。换句话说,这主要是一个关于容量和成本的故事,而非单纯的提速。
理解这一点需要知道GPU的工作机制:一块服务模型的GPU会在众多用户之间分配时间,接入的用户越多,每个人收到答案的速度就越慢。这就构成了每个系统的核心权衡——整体token吞吐量与单用户响应速度之间的取舍。
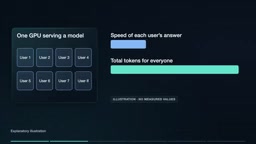
CoreWeave发布的对比图清晰展示了这条曲线:横轴是单用户答案的输出速度(由低到高),纵轴是Rubin每GPU相比旧款GB200多处理的token倍数。在慢速端,Rubin优势约为3倍;在快速端则攀升至7倍以上。而4.8这个数字标注在曲线中段——在该点上,两套系统的单用户响应速度完全相同,所有增益都体现在一块GPU为全体用户产出的总token数上。
值得关注的是,当用户需要快速响应时,Rubin的优势会进一步放大——这恰恰是编程智能体的典型场景,因为它必须等到每一次回复才能执行下一步。
这里涉及的核心技术概念是批处理(batching)。GPU并不是每次只服务一个用户,而是将多个用户的请求打包成一批同时处理,以最大化硬件利用率。批量越大,单块GPU每秒吐出的总token数越多,但每个用户等待的时间也相应拉长。这就是"整体吞吐量"与"单用户延迟"之间此消彼长的根本原因。Rubin的架构改进使得它在处理同等批量时占用的时间更短,或者说在保持相同用户延迟的前提下能撑起更大的批量——两种表述本质上是同一件事的两个侧面。理解这个机制,才能明白为什么"4.8倍"既不是说你的答案快了4.8倍,也不是说服务器能同时接待4.8倍的用户,而是特指在某个特定延迟点上,单GPU每秒处理的token总量之比。
编程智能体为何对token吞吐如此敏感
像Devin这样的编程智能体以循环方式工作:模型读取你的代码请求,写出一条指令,由代码编辑器或测试运行器等工具执行,结果再返回给模型。
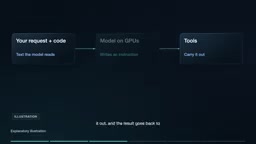
Cognition给出的示例任务是:让智能体为一个软件项目添加一个共享的警告函数,并在所有地方调用它。这类任务需要在循环中往返多次,每一趟都要向模型发送更多文本去读、去写——这些来回传递的小段代码,正是"4.8倍"所统计的token。
承担这项工作的模型是SWE-2,由Cognition基于中国AI公司月之暗面(Moonshot AI)的Kimi K2模型构建,于9月10日发布,主打卖点正是成本。Cognition表示,SWE-2在其自有编程测试中的得分与Anthropic的Claude模型仅相差一分,成本却低64%。创始团队成员Silas Alberti直言:"每token的成本决定了我们能交付什么。"
SWE-2所基于的Kimi K2是月之暗面于2025年发布的开源混合专家(MoE)模型,激活参数约320亿、总参数超1万亿,在代码和工具调用任务上表现突出。混合专家架构的特点是每次推理只激活一小部分参数,因此在同等性能下计算量更小、推理成本更低——这也正是Cognition选择它作为SWE-2底座的核心逻辑:在编程测试得分与顶级闭源模型相当的前提下,把每token的价格打下来。值得注意的是,Kimi K2以开放权重形式发布,允许企业在自有基础设施上部署,这给了Cognition在CoreWeave上直接运行并针对硬件调优的空间,而不必通过月之暗面的API付费调用。
省钱是真的吗?价格尚未公开
逻辑并不复杂:如果一块GPU每小时产出更多token,只要租用这块GPU的小时费用没有同比例上涨,每个token的成本就会下降。
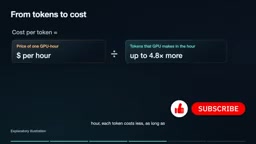
CoreWeave公开的旧款GB200价格为每GPU每小时10.5美元。按此推算,只要Rubin的租金低于约50美元/小时,它在4.8倍这个点上就能把token做得更便宜。但问题在于:CoreWeave尚未公布Rubin在限量供应期的价格,Cognition自己的费率也是私密的——所以实际节省究竟有多少,目前仍是未知数。
假如节省真实存在,Cognition有三种选择:服务更多客户、削减成本,或让每个用户获得更快的答案。它尚未透露将如何取舍这三者的组合。
为什么Devin不会"快4.8倍"
这是全文最关键的认知纠偏。即便Cognition把全部增益都投入提速,你交给Devin的任务也不会因此快那么多,因为每个编程任务中有一部分发生在模型之外。

用一组虚构的整数来说明:假设一个10分钟的任务,5分钟花在等待模型,5分钟花在运行构建、测试等工具。即便模型耗时完全归零,工具仍需要5分钟——所以无论GPU多快,这个任务最多只能快一倍。
英伟达也在攻克另一半。据报道,在CoreWeave的测试中,运行代码的隔离沙箱环境在其新款Vera CPU上启动速度提升超过3倍。这是在另一块芯片上的独立测试,不会叠加进4.8倍,但它瞄准的正是GPU提速够不到的那部分任务。
此外,CoreWeave表示其工程师与Cognition团队共同调优了服务模型的软件,因此部分增益可能来自软件优化,而非单纯依赖新芯片。
这一瓶颈在计算机科学中有一个正式名称:阿姆达尔定律(Amdahl's Law)。它描述的是:当你只能加速一个系统中的某一部分时,整体速度提升幅度受限于那些无法被加速的部分所占的比例。极端情形下,如果一个任务有一半时间花在不可加速的环节上,无论可加速部分提升多少倍,整体加速上限永远不超过2倍。这正是文中虚构数字所演示的场景。英伟达同时在Vera CPU上提速沙箱启动、Cognition持续缩短智能体循环中的工具调用耗时,都可以视作在拓展"可加速部分"的边界——这也是为什么单一硬件指标永远不能直接等同于用户感知到的任务完成速度。
对使用者意味着什么
对Devin用户而言,4.8倍对Cognition的容量来说是实打实的好消息,它给了公司在不作承诺的前提下让Devin更快或更便宜的空间。
第一个信号可能很快到来:Devin的定价页面显示,SWE-2在其桌面应用和命令行中免费使用至10月16日。此后Cognition如何收费,将是观察这波硬件红利如何转化为真实价值的关键风向标。
相关推荐
用生活场景看懂竞态条件:从咖啡机到银行取款的并发难题
通过咖啡机、买牛奶、银行取款、三向环岛等生活化例子,深入浅出讲解竞态条件、死锁、活锁、幂等性与锁机制等并发编程核心概念,帮你建立对并发问题的直觉理解。
亚马逊Alexa平板上手:NanoMAT屏幕叫板iPad Pro?
亚马逊推出全新Alexa平板系列,起售价499美元,升级铝合金机身并运行完整Android。重点体验NanoMAT抗眩光屏幕,对比iPad Pro的Nano Texture屏幕,解析其是否构成威胁。
5个比问ChatGPT更好用的CSS生成器工具
介绍5个比问ChatGPT更高效的CSS生成器工具:Mesher网格渐变、Fuel的SVG纹理、Temani Afif的CSSGenerators、Easing Wizard缓动曲线和Dice Bear头像生成,快速搞定难写的CSS效果。