用AI做SaaS?这5个架构决策AI替不了你

AI能写SaaS代码,但租户模型、隔离、扩展、控制平面、计量五个架构决策必须由人做出。
文章以AI编程智能体构建B2B发票SaaS为背景,指出代码生成能力不等于增长能力。当第二家客户到来时,五个架构决策决定产品能否规模化:租户模型选择孤岛还是池化;隔离需用租户ID加数据库行级安全双重保障;扩展要应对服务器瓶颈和吵闹邻居问题,按套餐设置限额;控制平面负责租户生命周期自动化,与应用平面分离;计量按租户追踪用量以支撑计费和成本分析。五个决策在第一天做成本最低,日后补做代价高昂;大客户提出隔离、区域和身份提供商要求时,前期决策能让应对变成一次新部署而非重写。
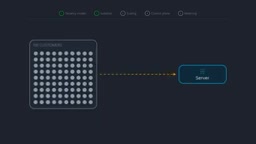
AI编程智能体让“周末做出一个SaaS”从段子变成了现实:应用能跑、能演示,甚至能卖出第一个客户。但增长从来不是代码量的线性叠加。当一个B2B发票管理工具迎来第二家客户——比如第一家是面包店,第二家是管道公司——一个AI不会替你回答的问题就摆上了桌面:这两个客户的数据放在哪?同一套应用、同一个数据库,还是各给一份完整副本?
据YouTube技术频道关于SaaS构建的系统分析,这类决策一共有五个,它们共同决定增长是“可控扩张”还是“推倒重写”。下面按视频中的发票SaaS案例逐一拆解。
决策一:租户模型——Silo还是Pool
在SaaS语境里,每一家客户公司就是一个租户(tenant),拥有自己的用户和业务数据。第一个分岔口是:给新客户一套独立的应用和数据库(Silo,孤岛模型),还是让所有租户共享同一套应用和数据库(Pool,池化模型)。
孤岛模型隔离性极好,代价是每多一个客户就多一套要付费、要维护的环境。池化模型运行成本低得多,也是多数SaaS产品的起点。但共享有代价:面包店的发票和管道公司的发票躺在同一批表里,此时阻止面包店看到管道公司数据的,只有代码本身。一条忘了按客户过滤的查询,就能让面包店老板看到别人家的账单。
决策二:隔离——别只靠代码自觉
这就是第二个决策要解决的问题。做法是:每一条属于租户的数据行都携带租户ID;登录后,令牌里写明“你是谁、当前在哪个租户下工作”;所有租户数据查询都被限定在该租户范围内。
更关键的一层是数据库层面的行级安全(row-level security)。代码会忘,但数据库不会。配置正确时,即使某条查询漏写了过滤条件,行级安全依然能兜住隔离边界。这是把“纪律”从开发者大脑转移到基础设施上的典型手法。
行级安全(Row-Level Security,RLS)是数据库提供的一种访问控制机制:管理员为表定义策略(policy),指定哪些行对当前执行上下文可见。在PostgreSQL中,通常配合 current_setting('app.tenant_id') 或会话变量使用,应用在每次查询前设置当前租户ID,数据库自动为所有查询追加过滤条件。RLS 的优势在于它是声明式的、集中管理的,即使应用代码存在遗漏或注入风险,也无法越过策略边界。实现时需注意:数据库连接池复用时必须重置会话变量,避免租户上下文串号;超级用户和表所有者默认可能绕过RLS,需显式启用 FORCE ROW LEVEL SECURITY。
决策三:扩展——服务器之外还有“吵闹邻居”
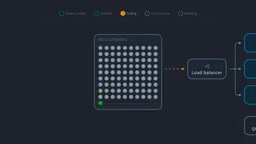
隔离稳住、口碑扩散,客户数来到一百。某个周一上午9点,大量客户同时打开应用,单台服务器扛不住了,客户开始抱怨变慢。
扩展的常规手段是在负载均衡后面加服务器,或迁移到按请求自动伸缩的云函数。但无论哪种,请求可能落到任意实例上,因此会话状态和上传文件必须放到共享存储。压力随后转移到数据库:连接池限制到达数据库的连接数,缓存吸收重复读取。
问题并没结束。十分钟后,一家印刷公司一次性导入八年的发票——两百万行——整个应用对所有人变慢。这就是“吵闹邻居”问题,单纯加服务器解决不了。按定价套餐为每个租户设置请求、存储、并发重任务的限额,才是SaaS让客户彼此不伤害的方式。
“吵闹邻居”(Noisy Neighbor)是多租户架构中的经典反模式:某个租户的突发负载(大量导入、复杂查询、高频API调用)耗尽共享资源,导致其他租户服务质量下降。在池化模型中,这种影响尤为直接,因为所有租户共享同一数据库连接池、CPU和I/O带宽。缓解手段通常包括:按租户维度设置速率限制(rate limiting)和配额(quota);为后台批处理任务使用独立队列并限制并发;在数据库层使用资源组或工作负载管理(如PostgreSQL的 statement_timeout、连接池的每租户最大连接数);对高价值租户可迁移至独立实例。计量数据是识别吵闹邻居的前提。
决策四:控制平面——把租户生命周期自动化
客户每天新增,谁来开通?每个注册都需要账号、套餐、设置和首个管理员用户;还有升级、降级、取消订阅,以及停止付费的客户。全靠手工,创始人很快会顶不住。
第四个决策是把系统分成两层:发票应用本身是应用平面,服务客户;控制平面则管理租户本身——开通、套餐、整个生命周期。新客户注册后自动获得一个可用的租户,无需任何人工配置。
控制平面(Control Plane)与应用平面(Data Plane/Application Plane)的分离是云原生架构的核心模式之一。控制平面负责“管理资源本身”——租户的创建、配置、套餐变更、隔离环境开通、区域路由、计费关联等;应用平面负责“处理业务请求”——发票的增删改查、文件上传、AI分析等。分离的好处是:控制平面可以独立演进和扩缩容,故障隔离更清晰,且能统一管理跨区域、跨环境的租户。实现上,控制平面通常维护一张租户目录(tenant registry),记录每个租户的路由信息(如数据库连接串、区域、身份提供商配置),应用平面在请求入口处查询该目录完成路由。
决策五:计量——知道谁在花钱
月底云账单比上月高出三成,哪家客户造成的?没有按租户切分的数据,没人答得上来。第五个决策是计量:把API调用、存储、后台任务等驱动成本的用量,全部打上租户标签,喂给按量计费,同时识别出“服务成本高于付费”的客户。
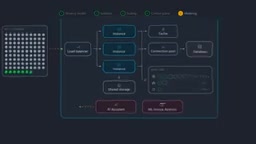
一旦给应用加上AI能力——比如助手或自动发票分析——计量就更要命了。每个回答都消耗token,没有计量和限额,一个重度用户就能吃掉整个套餐的毛利。
用量计量(Metering)与计费(Billing)是两个不同层次:计量是采集和聚合每个租户的资源消耗数据(API调用次数、存储字节数、后台任务执行时长、AI token数等),计费则是根据定价模型将用量转化为账单金额。在AI功能场景下,token计量尤为关键,因为大语言模型的调用成本与输入输出token数直接挂钩,且单次请求成本可能远高于传统API。缺乏计量时,固定套餐定价极易被重度用户击穿毛利。实践中,计量数据应打上租户ID、时间戳、资源类型标签,写入独立的计量事件流,再通过聚合管道生成账单和成本分析报表。
五个决策的复利:大客户来了不用重写
一年后,最大的项目上门:一家大型企业客户,条件是独立隔离环境、数据存储在加拿大、通过自己的身份提供商登录。
这正是五个决策兑现的时刻。给它一个位于加拿大区域的孤岛,接上它的身份提供商,其他人继续留在现有池子里。应用本来就会把每个租户路由到对应环境,控制平面能开通新环境,计量继续按租户追踪用量。结果是一次新部署,而不是一次重写。
租户模型、隔离、扩展、控制平面、计量——AI能写其中大部分代码,但这五个决策仍然属于人。而且它们在第一天做出的成本,远低于日后补做的成本。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。