Eflow Base观察Claude Code每一步执行细节:全链路追踪配置指南

为什么需要观察AI Agent的每一步?
当我们使用Claude Code这类AI编程助手时,往往只能看到最终输出结果,却无法了解中间发生了什么——模型调用了哪些工具、每步消耗了多少Token、系统提示词是如何拼接的。这种"黑盒"状态让优化变得无从下手。
在传统软件工程中,可观测性(Observability)已经是成熟概念,包括日志(Logging)、指标(Metrics)和追踪(Tracing)三大支柱。但AI Agent领域的可观测性面临独特挑战:模型推理过程本身是非确定性的,工具调用链路可能动态变化,Token消耗与任务复杂度之间的关系难以预测。LangSmith、Helicone、Braintrust等工具正在尝试解决这一问题,而Eflow Base作为本地可控的中间层方案,特别适合对数据隐私有要求的开发者。
Eflow Base正是为解决这个问题而生的中间层工具。它能完整记录你与Claude Code的每一次对话,不仅包括最终回答,还包括每次工具回调、系统提示词拼接、Token消耗等细节数据。本文将详细介绍如何配置和使用Eflow Base来实现对Claude Code的全链路观测。
配置模型供应商API Key
所有后续接入的基础是在Eflow Base的模型供应商中配置你的API Key。目前Eflow Base支持多种接口协议:
- DeepSeek广告:安装对应插件,常规文本任务选择Chat接口,基础地址填写
api.deepseek.com - 阿里百炼广告:通过兼容接口接入
- Anthropic兼容接口:可以把地址配置为DeepSeek的兼容路口
- OpenAI接口:检测模型时可直接拉取官方模型列表确认连通性
- Gemini接口
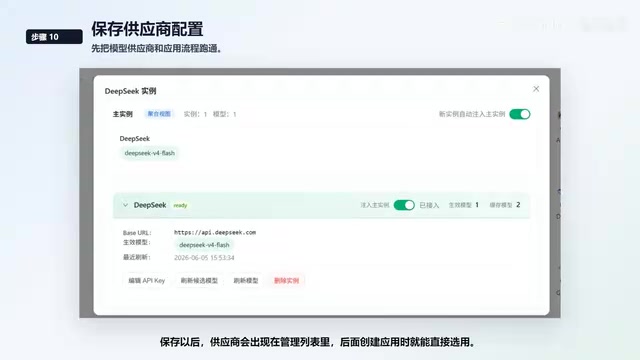
保存后供应商会出现在管理列表里,后续创建应用时可以直接选用。
创建应用作为中间层
创建一个新的应用,让它作为Claude Code访问大模型的中间层。Eflow Base采用的中间层(Middleware/Proxy)架构是一种经典的软件设计模式——它位于客户端(Claude Code)和上游模型API之间,对双方透明地拦截、记录和转发请求。这种架构的优势在于无需修改客户端或服务端代码,只需将API请求地址指向中间层即可。类似的设计在API网关(如Kong、Envoy)中广泛应用,Eflow Base将这一理念专门适配到了LLM调用场景。
Eflow Base会自动生成三个基础节点:
- 开始节点:包含内置变量,可按Agent场景重新组织上下文
- LLM节点:核心推理节点
- 回复节点:输出最终结果
关键配置要点
这里需要特别注意上下文和History变量的处理。Eflow Base已经将它们封装成前端变量,简化了配置流程。
关于推理强度,有两种策略可选:
- 追随外部请求:让Claude Code传来的设置继续传给LLM
- 固定推理强度:让应用始终按你设定的策略运行
配置完成后,先检查流程有没有报错,确认模型节点和变量都能正常连接。然后进入预览对话,用一次简单请求验证整条链路。
发布接口并配置Claude Code
预览没问题后,点击发布将应用暴露成外部客户端可访问的接口。发布后进入API页面,Eflow Base会给出兼容OpenAI和Anthropic的接口入口。
创建API密钥
创建一个新的API密钥供Claude Code本地配置使用。注意:密钥只显示一次,生成后要马上保存,之后页面不会再展示完整内容。
请求地址按部署方式填写:
- 本地Docker部署:默认
127.0.0.1:3100 - 源码部署:通常使用
7800端口
如果还没有安装Claude Code,可以用NPM安装最新版,再回到配置继续验证。
观察日志与全链路追踪
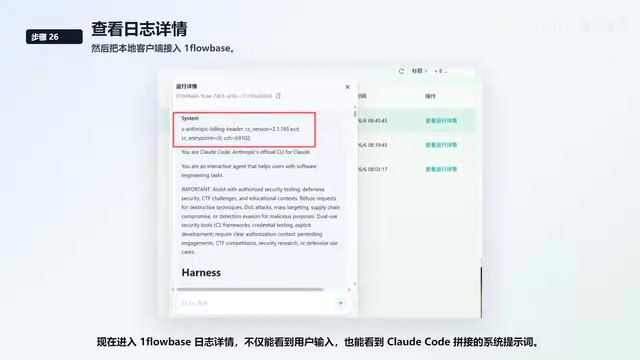
这是Eflow Base最核心的价值所在。进入日志详情后,你能看到:
- 用户输入:原始请求内容
- 系统提示词:Claude Code拼接的完整system prompt
- 工具调用记录:每一次tool call的详细信息
- 每步返回结果:包括中间推理过程
理解Claude Code的工具调用机制
Claude Code基于Anthropic的Tool Use(函数调用)能力构建,它能够在对话过程中自主决定调用文件读写、命令执行、代码搜索等工具。每次工具调用都遵循一个循环:模型生成tool_use请求→客户端执行工具→将tool_result返回给模型→模型决定下一步动作。一个复杂编程任务可能涉及数十次这样的循环,每次循环都会消耗Token并产生延迟,这就是为什么中间过程的可观测性如此重要。
系统提示词的动态拼接
Claude Code的系统提示词(System Prompt)并非静态文本,而是根据当前项目上下文、用户配置、可用工具列表等信息动态拼接而成。这个拼接过程通常包括:基础人设指令、项目特定的CLAUDE.md文件内容、当前可用工具的schema描述、以及各种行为约束规则。完整的系统提示词可能长达数千Token,理解其构成对于调试Agent行为异常至关重要。通过Eflow Base的日志,你可以完整查看每次请求中实际发送给模型的system prompt全文。
复杂任务的完整记录
当Claude Code执行复杂任务时,日志里会继续出现模型请求、工具调用和每一步返回。右侧提供三个操作按钮:
- 复制输出
- 查看具体日志详情
- 查看回调历史
打开详情和回调历史后,两个面板会并列展示,方便直接对照每一步发生了什么。
Token消耗的精确统计
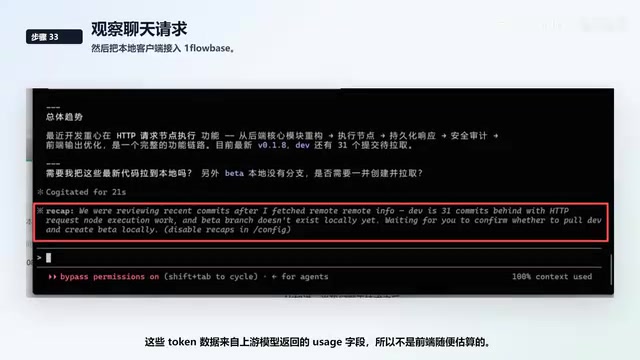
每一次工具执行的回调结果和Token消耗都会作为步骤数据留下来。这些Token数据来自上游模型返回的usage字段,不是前端随便估算的,保证了数据的准确性。
Token是大语言模型计费的基本单位,包括输入Token(prompt tokens)和输出Token(completion tokens)。在Agent场景下,由于多轮工具调用,上下文会不断膨胀——每次调用都需要携带之前的对话历史和系统提示词,导致输入Token呈累积增长。一个看似简单的代码重构任务,可能因为反复读取文件和执行命令而消耗数万甚至数十万Token。精确的Token统计能帮助开发者识别哪些步骤是成本大户,从而优化提示词设计或调整工具调用策略。
有意思的是,即使是客户端自动发起的总结请求也会被记录。当Claude Code自动做会话总结时,你同样可以在日志里看到这次请求的完整信息。
数据报表与趋势分析
除了步骤日志,Eflow Base还提供完整的数据报表功能:
- 日志报表:字段列支持动态配置
- 应用活动监控:实时展示应用状态,包括正在执行什么、使用什么协议、监控状态如何
- 历史数据报表:分析调用趋势、消耗变化和异常情况
- 历史统计图:观察调用分布,快速定位哪类请求最频繁
通过这些报表,你可以把成本、次数和异常放到同一个复盘链路里,形成完整的优化闭环。
总结
Eflow Base的核心价值不是替你调用一次模型,而是把Claude Code的每一步执行都变成可观察、可复盘、可优化的数据。
对于想要优化AI Agent工作流的开发者来说,"观察"是优化的第一步。只有清楚知道每一步发生了什么、消耗了多少资源、哪里出现了异常,才能有针对性地进行调优。Eflow Base提供的全链路追踪能力,正是连接"使用AI"和"优化AI"之间的关键桥梁。
核心要点
相关推荐

GitHub日报·11月04日: Agent 生态大爆发,技能包与记忆层成新战场

My precious RAM:内存条被咬下主板引热议
Reddit热帖“My precious RAM”记录了一条内存条被从主板上咬下来的意外事故。本文还原事件、分析传播点,并给出硬件安装与防护的实用提醒。

深入PostgreSQL内核:一本免费开源的数据库原理指南
《The Internals of PostgreSQL》是一本免费在线书籍,系统讲解PostgreSQL的进程架构、存储布局、查询处理、MVCC并发控制和WAL日志机制,适合DBA和后端工程师深入理解数据库内核原理。