用非周期序研究打造AI推理阶梯:可验证奖励问题的开放数据集
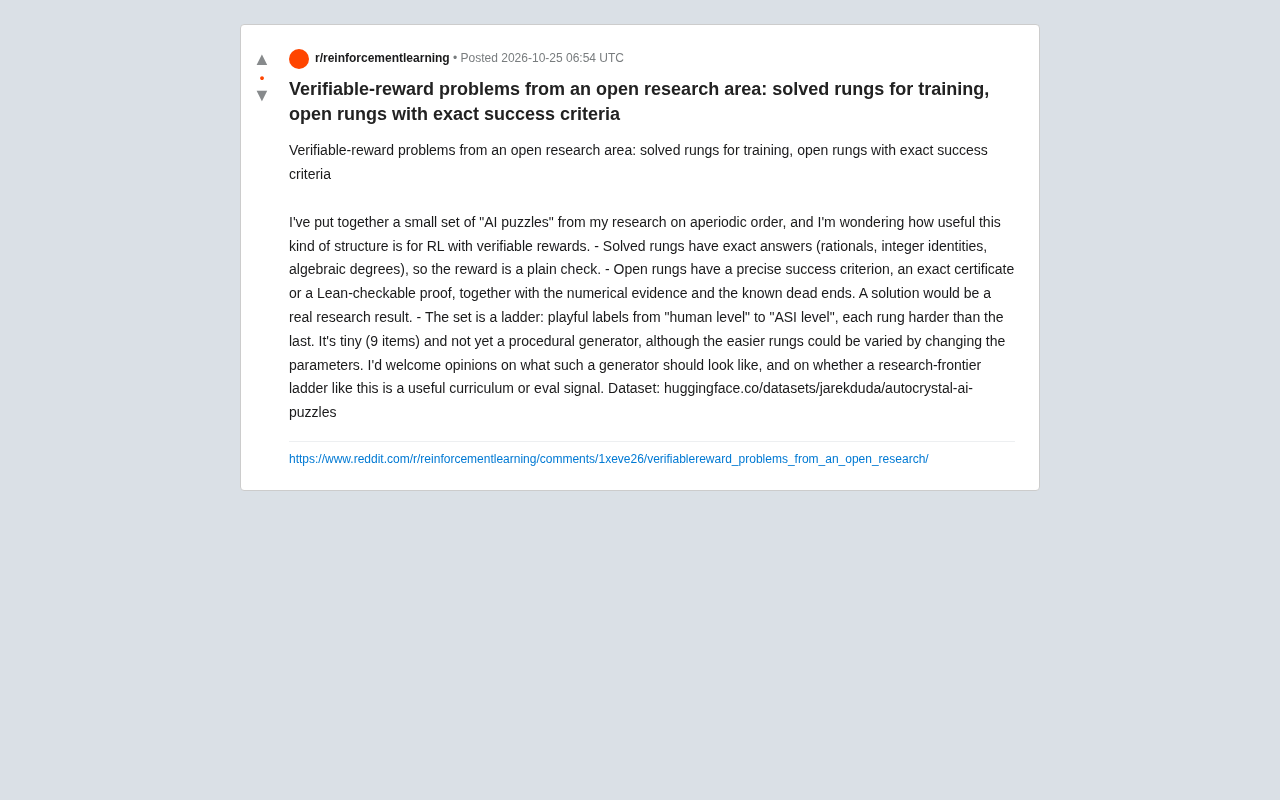
研究者发布9道非周期序谜题,探索用真实数学前沿构建RLVR课程。
一位非周期序领域的研究者在Reddit上发布了一个仅含9道题的迷你数据集,试图探索可验证奖励强化学习(RLVR)的新路径。这些谜题源自其真实数学研究,分为两类:已解梯级拥有精确答案,可直接用于RL训练;开放梯级则设定了精确成功标准——提供确切证书或Lean可检验证明,解出即构成真实数学成果。作者认为非周期序问题「答案可精确表述但发现路径非平凡」,恰好契合RLVR对客观奖励与非平凡问题的双重需求。数据集已发布在Hugging Face,但规模很小且非程序化生成,作者公开征询社区关于生成器设计与研究前沿阶梯作为课程或评估信号的意见。
从数学研究到AI训练场:一个可验证奖励的谜题阶梯
一位研究非周期序(aperiodic order)的研究者,在Reddit上发布了一个仅包含9个问题的迷你数据集,试图探索可验证奖励强化学习(RLVR) 的新可能。据其描述,这些“AI谜题”源自其真实的数学研究,每道题都有精确的成功标准——要么是确切的数值答案,要么是可被Lean证明器检验的形式化证明。
这个数据集的设计思路与当前主流的RLVR训练集形成鲜明对比。大多数可验证奖励问题来自数学竞赛或编程题,答案已知且训练信号密集。而这位研究者提供的是一个阶梯结构:底层“已解”的题目用于训练,顶层“开放”的题目则对应真实的研究前沿,解出来就是一项数学成果。
双层结构:可训练的“已解梯级”与可评估的“开放梯级”
据数据集作者介绍,整个谜题集分为两类梯级:
已解梯级(Solved rungs) 拥有精确答案,例如有理数、整数恒等式或代数次数。奖励函数就是一个简单的答案校验器,无需复杂评分模型。这类题目适合直接用于RL训练,且“较容易的梯级可以通过改变参数来生成变体”,暗示了程序化扩展的潜力。
开放梯级(Open rungs) 则设定了精确的成功标准——要么提供一个确切的证书,要么给出一个Lean可检验的证明,同时附带数值证据和已知的死胡同。作者明确表示:“解出一个开放梯级将是一个真正的研究结果。”这意味着这类题目不仅是评估信号,更是与真实数学研究接轨的桥梁。
这种双层设计在RLVR语境下颇具新意:训练信号来自底层已解问题,而评估信号则指向尚未解决的研究问题。作者将梯级从“人类水平”一直标注到“ASI水平”,用游戏化的标签暗示了难度递增的路径。
Lean 证明器是一种基于依赖类型论的交互式定理证明器,同时也可作为编程语言使用。在数学领域,Lean 及其数学库 Mathlib 被用于形式化验证定理证明的正确性——每一步推理都必须符合逻辑规则,最终由计算机内核机械地检查整个证明。这使得 Lean 成为「可验证奖励」的理想载体:如果一个命题的 Lean 证明通过编译,那么该命题为真这一点就得到了最高程度的保证,无需人类专家复核。近年来,Lean 社区已形式化了大量现代数学结果(如菲托里斯同调、完美空间猜想等),使其逐渐成为连接前沿数学研究与机器验证的桥梁。对于 RLVR 而言,Lean 提供的奖励信号是二值的、不可篡改的,这比基于答案匹配的校验器更为严格,但也对模型的形式化推理能力提出了更高要求。
为什么非周期序适合做RLVR的试验田?
非周期序是数学中一个相对小众但内涵丰富的领域,研究的是既非完全周期又具有高度有序结构的系统,与准晶体、符号动力学和谱理论密切相关。这类问题的特点在于:答案往往可以精确表述,但发现路径高度非平凡。
这恰好契合了可验证奖励RL的核心需求——奖励必须客观可查,但问题本身不能太简单。据作者描述,开放梯级的成功标准包括“精确证书或Lean可检验的证明”,这意味着即便答案未知,验证过程仍然是机械化的、无需人类主观判断的。
从更广的视角看,这个数据集触及了RLVR领域的一个关键瓶颈:高质量可验证问题的稀缺。当前社区大量依赖竞赛数学题库,但这些题目与真实研究之间存在鸿沟。一个来自活跃研究领域的“问题阶梯”,或许能为课程学习和评估信号设计提供新的思路。
符号动力学研究的是由离散符号序列构成的动力系统,典型例子包括有限字母表上的移位空间及其子移位。非周期序(如 Sturmian 序列、替换序列)常在此框架下被刻画:它们既不是最终周期的,又具有低复杂度和一致重复性等强有序特征。谱理论则关注与这些序列关联的算子(如薛定谔算子)的谱测度——非周期序对应的谱往往是奇异连续的,这与其「有序但非周期」的结构深刻相关。准晶体(如谢赫特曼发现的 Al-Mn 合金)的衍射图样正是这种结构的物理体现。这些背景意味着,非周期序中的许多问题可以精确陈述为关于整数序列、代数次数或有理逼近的命题,答案可被机械验证,但发现证明需要深刻的数学洞察——这正是 RLVR 所渴求的「可验证但非平凡」的问题类型。
社区反馈与待解问题:从9道题到程序化生成器
作者坦承这个数据集“很小(9项),还不是程序化生成器”,并主动向社区征求意见:这样的生成器应该长什么样?研究前沿的阶梯是否可以作为一种有用的课程或评估信号?
这些问题直指RLVR数据工程的核心挑战。一个理想的研究前沿阶梯需要满足几个条件:底层梯级能提供足够密集的训练信号,梯级之间的难度过渡平滑,顶层梯级确实对应未解问题。而程序化生成则要求对问题空间有足够的形式化理解,才能参数化地产生变体。
作者将数据集发布在Hugging Face上(jarekduda/autocrystal-ai-puzzles),供社区试验。从单一来源的讨论来看,这个项目尚处于概念验证阶段,其实际训练效果和评估价值还有待验证。但它提出的问题——能否用真实研究前沿构建RLVR课程——值得关注可验证奖励RL的研究者认真思考。
对于AI编程和AI应用方向的实践者,这个数据集也提供了一个具体案例:如何将领域知识转化为机器可验证的奖励结构,同时保留与真实研究问题的连接。这或许比单纯扩大竞赛题规模更有长远价值。
课程学习(Curriculum Learning) 在强化学习中指按照难度递增的顺序安排训练样本,使智能体逐步掌握复杂技能。在 RLVR 语境下,课程设计尤为关键:如果问题始终过难,奖励信号过于稀疏,模型难以学习;如果问题过于简单,则无法推动能力边界。一个理想的「研究前沿阶梯」本质上就是一种课程——底层已解梯级提供密集奖励,顶层开放梯级提供评估基准。然而,构建这样的课程面临「难度校准」难题:梯级之间的难度跃迁需要平滑,且每一级的成功率应落在模型可学习的区间内(通常认为成功率在 20%-80% 之间信号最有效)。此外,程序化生成器需要形式化地参数化问题空间,这要求对非周期序的构造有足够统一的理解,才能保证生成的变体既保持可验证性又不失研究价值。
相关推荐
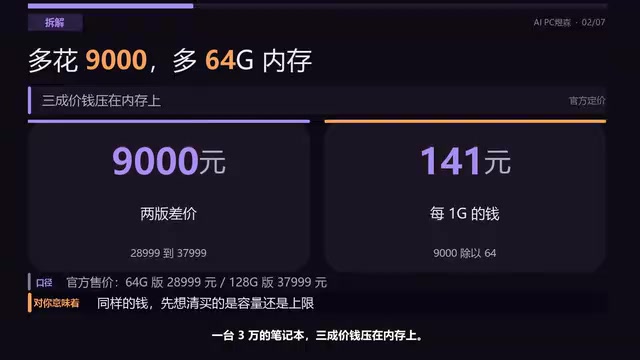
64G内存笔记本跑大模型,实际可用仅46.7G
华硕ProArt创16实测:64G内存标称值下模型可用仅46.7G,128G版官方上限1200亿参数。本文拆解9000元内存差价、统一内存占用真相、续航表现,并给出三步自查方法,帮你判断本地跑大模型该买多大内存。
Ollama零基础教程:本地部署大模型入门指南
Ollama零基础入门教程:了解Ollama是什么、核心特点与本地部署大模型的价值。涵盖开源免费、跨平台、CPU/GPU调度、API集成等关键信息,助你快速上手本地大模型管理工具。

LangGraph 实战:开发者真实工作流与技术栈剖析
从 Reddit 开发者提问切入,剖析 LangGraph 在实际生产中的工作流设计、技术栈组合、图结构模式与调试痛点,总结从教程走向落地的关键实践与可观测性需求。