用GitHub Copilot自动化Dependabot依赖更新审查

依赖更新:开发者绑不开的重复劳动
在现代软件开发中,几乎每个项目都依赖着数十甚至上百个第三方库。这些依赖并非一劳永逸——安全补丁、功能迭代和bug修复会不断催生新的版本。现代软件开发普遍采用语义化版本控制规范(SemVer),版本号格式为「主版本号.次版本号.修订号」(如 2.3.1)。SemVer规范最初由GitHub联合创始人Tom Preston-Werner于2011年正式提出,其核心理念是通过版本号编码API的兼容性承诺,使依赖管理从「猜测」变为「契约」。主版本号(major)变更意味着可能存在不兼容的API修改;次版本号(minor)增加表示向下兼容的功能性新增;修订号(patch)更新通常是向下兼容的问题修正。这种约定帮助开发者快速判断更新的风险等级。
然而,SemVer虽然提供了清晰的版本号约定,现实中的依赖管理远比表面规则复杂。各语言生态的包管理器对版本范围的处理方式各不相同:npm使用脱字符(^)和波浪号(~)语法来定义兼容版本范围——^1.2.3表示允许>=1.2.3且<2.0.0的任何版本,而~1.2.3则限制为>=1.2.3且<1.3.0,这种灵活性在提供便利的同时也引入了不确定性,因为同一份package.json在不同时间点执行npm install可能解析出不同的依赖版本。Go modules采用最小版本选择(MVS)策略,这是Go语言设计者Russ Cox提出的一种独特哲学——不同于其他包管理器「尽可能选择最新兼容版本」的做法,MVS总是选择满足约束的最小(即最旧的)版本,从而实现高度可重复的构建结果,减少因依赖自动升级而引入意外行为的风险。Python的pip则依赖requirements.txt中的版本约束表达式(如>=1.0,<2.0),但由于其历史包袱较重,Python生态正在从传统pip向更现代的工具如Poetry(使用pyproject.toml和lock文件)和PDM等迁移,以获得更可靠的依赖锁定和解析能力。更关键的是,并非所有开源项目都严格遵守SemVer——一些项目可能在minor版本中引入破坏性变更,或在patch版本中加入新功能。这种不确定性正是依赖更新审查不能完全机械化的根本原因之一。
为了帮助开发者跟上这些变化,GitHub推出了Dependabot,它能够自动检测过时的依赖并创建相应的Pull Request(PR)。Dependabot的前身是一个独立的开源项目,由Grey Baker于2017年创建,GitHub于2019年将其收购并深度集成到平台中,使其成为GitHub原生供应链安全工具链的核心组件,与GitHub Advisory Database(安全公告数据库)和Dependency Graph(依赖关系图谱)形成联动。Dependabot的核心引擎dependabot-core是开源的,以Ruby编写,通过模块化的「ecosystem backend」架构支持不同语言的包管理器。它通过定期扫描项目的依赖清单文件(如package.json、requirements.txt、pom.xml等),与各语言生态的包管理仓库(npm、PyPI、Maven Central等)进行版本比对,一旦发现新版本就自动创建PR。截至2024年,Dependabot已支持超过20种包管理生态系统,包括npm、pip、Maven、Gradle、NuGet、Cargo、Bundler、Docker、Terraform、GitHub Actions等。具体而言,Dependabot支持三种核心功能:Dependabot Alerts(检测已知漏洞并发出警报,数据源来自GitHub Advisory Database、National Vulnerability Database等多个安全公告数据库)、Dependabot Security Updates(针对安全漏洞自动创建修复PR,仅升级到修复漏洞的最小兼容版本以减少破坏性)和Dependabot Version Updates(定期检查所有依赖的最新版本并创建升级PR,无论是否涉及安全问题)。开发者可以通过仓库根目录下的.github/dependabot.yml配置文件来定制扫描频率(daily/weekly/monthly)、目标目录、版本更新策略(如increase仅升级到最低满足版本、increase-if-necessary仅在需要时升级、widen扩展版本范围)、自动分配审查者、添加标签、设置PR数量上限等行为。此外,Dependabot可以与GitHub Actions深度协作——开发者可以编写workflow监听pull_request事件并筛选来自Dependabot的PR,实现自动化的测试运行、标签管理甚至条件合并。
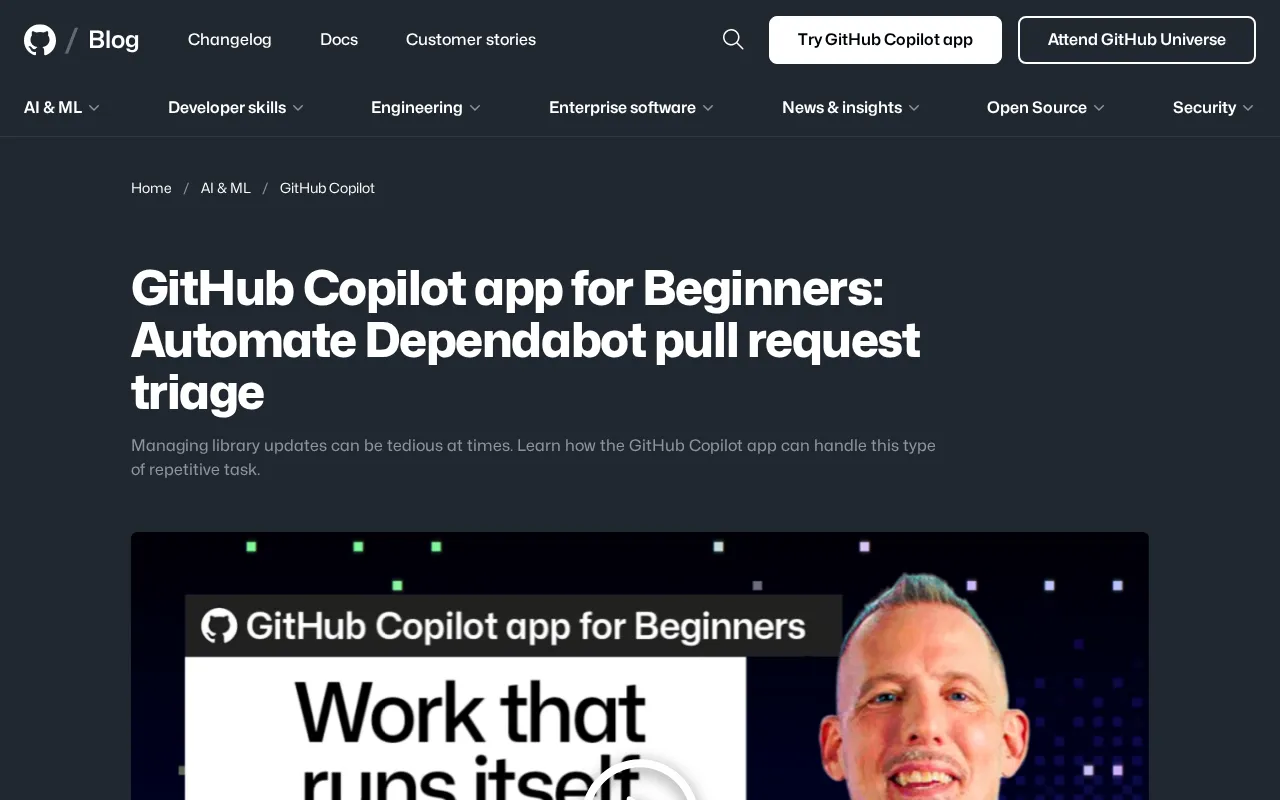
然而,Dependabot带来的便利也伴随着新的负担。对于活跃的项目而言,一个中等规模的项目可能有100+个直接和间接依赖,每周产生10-30个更新PR并不罕见。Dependabot可能每天生成大量PR,逐个审查这些更新——判断是否为破坏性变更、是否需要立即合并、是否可以安全批准——成为一项耗时且枯燥的重复性工作。这个问题在业界被称为「Dependabot疲劳」(Dependabot fatigue),甚至催生了一些第三方工具如Renovate Bot(由Mend公司维护的开源替代品,支持更灵活的分组更新和自动合并策略)来尝试缓解。GitHub官方博客近期发布的这篇面向初学者的教程,正是聚焦于如何借助GitHub Copilot应用来自动化这一流程。
GitHub Copilot如何介入依赖审查
从代码补全到任务代理
这里所讨论的GitHub Copilot已经超越了传统意义上的代码补全工具。它正在演进为一个能够执行具体任务的"代理型"(agentic)助手。GitHub Copilot最初于2021年6月作为技术预览版推出,基于OpenAI Codex模型(GPT-3的代码优化版本),在GitHub上数十亿行公开代码上进行微调。2022年6月正式商用后,Copilot迅速成为全球最广泛使用的AI编程助手,截至2024年已拥有超过180万付费用户。2023年,GitHub推出Copilot Chat,引入对话式交互,底层模型也升级为GPT-4系列。2024年起,GitHub加速推进产品矩阵的扩展:Copilot Workspace(2024年4月预览)允许开发者从Issue出发,由AI自动分析问题、制定计划、生成代码并创建PR;Copilot Extensions开放了第三方扩展生态,允许Sentry、Docker、Azure等工具以插件形式接入Copilot Chat;Copilot Autofix则专注于安全领域,能够自动为Code Scanning发现的漏洞生成修复补丁。这些产品共同将能力边界从「辅助编写代码」扩展到「执行开发任务」——不仅能写代码,还能读Issue、审查PR、运行测试、甚至直接操作仓库。
这种演进背后是**代理型AI(Agentic AI)技术范式的兴起。与传统的问答式AI交互不同,代理型AI具备自主规划、工具调用和多步骤任务执行的能力。其理论基础可追溯至2022年Yao等人提出的ReAct(Reasoning + Acting)**范式——该框架证明了让大语言模型交替进行「思维链推理」和「外部工具调用」能够显著提升复杂任务的完成质量。在此基础上,OpenAI的Function Calling机制(2023年6月发布)为LLM提供了结构化调用外部API的标准接口,使模型能够输出符合预定义schema的JSON来触发特定工具,而非仅生成自然语言文本。代理型AI的技术架构通常包含四个核心模块:**规划器(Planner)**负责将复杂任务分解为可执行的子步骤,常见实现包括Chain-of-Thought提示和Tree-of-Thought搜索;**记忆模块(Memory)**维护任务上下文和历史信息,分为短期记忆(对话上下文窗口)和长期记忆(向量数据库存储的历史知识);**工具调用层(Tool Use)**允许AI调用外部API、执行代码、读写文件等,GitHub Copilot在此层面集成了GitHub REST/GraphQL API、代码搜索索引、CI系统触发器等能力;**反思机制(Reflection)**则让AI评估自身输出的质量并进行自我纠正,例如检查生成的代码是否通过lint检查或单元测试。在GitHub Copilot的PR审查场景中,这意味着AI不仅能「阅读」PR的diff和changelog,还能主动调用GitHub API查询相关Issue、触发CI测试运行、在PR中留下结构化评论,甚至根据审查结果执行合并操作——形成一个完整的自主工作流闭环。
传统的CI/CD自动化依赖预定义的规则和脚本,例如「如果是patch更新且测试通过则自动合并」。这种方式缺乏灵活性——无法理解变更日志的语义,不能根据项目上下文做出判断。AI代理型工具如GitHub Copilot则引入了大语言模型的理解能力,它能够:阅读依赖的CHANGELOG并提取关键风险信息(如「包含breaking change」或「修复关键安全漏洞CVE-2024-xxxx」);分析项目代码中对该依赖的实际使用方式,判断升级影响范围;甚至检索相关Issue和讨论,综合评估社区对新版本的反馈。值得注意的是,这种基于LLM的语义理解能力与传统的静态分析工具形成了互补关系——静态分析工具如Snyk和Socket擅长基于已知漏洞数据库进行精确匹配和依赖树遍历,而LLM擅长理解非结构化文本(如changelog、commit message)中的隐含信息和上下文语义。两者的结合代表了依赖审查工具的未来方向。
在依赖审查这一场景中,Copilot应用可以被配置去处理Dependabot产生的PR队列,自动完成初步的分类(triage)工作。
所谓分类,指的是对每个更新PR进行快速评估:
- 这是一个补丁级别(patch)的小改动,还是一个可能引入不兼容变更的主版本升级(major)?
- 变更日志中是否包含值得警惕的信息?
- 依赖的下游影响范围有多大?
这些判断原本需要人工逐一进行,而现在可以交由Copilot辅助甚至自动完成。
面向初学者的实践路径
这篇教程的定位是"Beginners",意味着它致力于降低自动化的入门门槛。对于许多刚接触GitHub生态的开发者来说,Dependabot的PR洪流往往令人望而生畏。通过Copilot应用,开发者无需编写复杂的脚本或CI/CD配置,就能让AI处理这类重复性任务,从而将精力集中在真正需要人类判断的核心开发工作上。这种低门槛的设计理念也反映了GitHub「让安全成为默认状态」(security by default)的产品哲学——通过降低安全实践的执行成本,让更多项目能够实际维护其依赖的健康状态,而不是让安全更新在PR列表中无限堆积直到被忽视。
自动化审查的价值与边界
效率提升的直接收益
将Dependabot PR的分类工作自动化,带来的收益是显而易见的:
- 时间成本节约:开发者不再需要每天花费数十分钟乃至数小时处理更新通知。据GitHub 2024年的研究数据,使用AI辅助工具的开发者在处理依赖管理类任务时效率提升了约40-60%,这些节省的时间可以重新投入到功能开发和架构优化中。
- 安全响应加速:涉及安全漏洞的依赖更新能够被更快地识别和处理,缩短项目暴露在已知风险下的时间窗口。依赖更新不仅是功能维护问题,更是软件供应链安全的核心环节。近年来,针对开源生态的供应链攻击频发:攻击者可能通过入侵维护者账号发布恶意版本(如2021年的ua-parser-js事件),或通过「typosquatting」(域名/包名仿冒)发布名称相似的恶意包诱导误装。软件供应链攻击已成为网络安全领域最严峻的威胁之一。据Sonatype《2024年软件供应链状况报告》统计,仅2023年就发现了超过24.5万个恶意开源包,同比增长200%以上。除了上述攻击手法外,典型威胁还包括:依赖混淆攻击(Dependency Confusion,利用内部包名与公共仓库包名的冲突进行劫持,如2021年安全研究员Alex Birsan披露的攻击手法影响了Apple、Microsoft、PayPal等35家以上的科技公司,其原理是当企业内部使用的私有包名称未在公共仓库注册时,攻击者可以在npm/PyPI上抢注同名包并设置更高的版本号,包管理器在解析时可能优先拉取公共仓库的恶意版本)、维护者社会工程学攻击(如2024年3月曝光的xz-utils后门事件,化名Jia Tan的攻击者花费近两年时间通过持续贡献代码取得维护者信任、最终获得提交权限后植入精心设计的后门代码,该后门可能影响几乎所有主流Linux发行版的SSH远程登录安全,被广泛认为是有国家背景的长期渗透行动)、以及构建系统入侵(如2020年SolarWinds事件,攻击者入侵了SolarWinds的Orion软件构建管道,在合法更新中植入了SUNBURST后门,影响了约18,000个客户组织,包括美国多个联邦政府机构)。为应对这些威胁,业界已发展出多层次的防御体系:SLSA框架(Supply-chain Levels for Software Artifacts,由Google提出,定义了从L1到L4四个等级的软件供应链安全成熟度标准);SBOM(Software Bill of Materials,软件物料清单,美国2021年行政令EO-14028要求关键基础设施供应商提供SBOM,常见格式包括SPDX和CycloneDX);Sigstore(Linux基金会项目,为软件工件提供免费的代码签名和验证服务,npm从2023年起已集成Sigstore签名)。Dependabot的Security Updates功能专门针对已知CVE(Common Vulnerabilities and Exposures,通用漏洞披露)编号的安全问题创建紧急PR,但开发者仍需判断该漏洞在自己项目中的实际可利用性——这涉及到CVSS评分(Common Vulnerability Scoring System,通用漏洞评分系统,从0到10评估漏洞严重程度)和可达性分析(reachability analysis,判断漏洞代码路径是否在项目中被实际调用)等更深入的安全评估。这些案例凸显了依赖更新审查不仅是效率问题,更是安全防线的关键环节。
- 维护者负担减轻:对于开源项目维护者而言,这种自动化尤为宝贵。许多热门开源项目由少数志愿者维护,Dependabot的PR堆积常常成为沉重负担——开源社区将这种现象称为「维护者倦怠」(maintainer burnout)。据GitHub 2024年Octoverse报告,超过60%的开源项目由1-2名核心维护者支撑。让Copilot承担初步审查,可以显著减轻维护者的心智消耗。
需要保持的谨慎态度
不过,自动化审查并不意味着可以完全撒手不管。依赖更新本质上仍是一件需要工程判断的事情。一个看似无害的补丁更新,也可能因传递依赖或运行时行为的微妙变化而引入问题。
传递依赖(transitive dependencies)问题是现代软件工程中的一个深层挑战。一个典型的Node.js项目在安装少量直接依赖后,node_modules目录中可能包含数百甚至上千个间接依赖包——据统计,一个仅声明了10个直接依赖的Express.js项目,其完整依赖树可能包含超过300个包。从计算机科学的角度看,依赖解析本质上是一个NP完全问题(Boolean Satisfiability的变体),即在存在大量版本约束时,找到一组满足所有约束的版本组合在理论上是计算困难的。不同的包管理器采用了不同的启发式策略来应对这一挑战:npm早期使用嵌套的node_modules结构(每个包维护自己的依赖副本),后来引入扁平化(hoisting)策略和package-lock.json来减少重复和提高确定性;Maven使用「最近定义优先」(nearest definition wins)策略解决版本冲突;而Cargo(Rust的包管理器)则允许在同一项目中同时存在一个crate的多个不兼容版本,通过类型系统隔离避免冲突。2016年的「left-pad事件」——一个仅11行代码的npm包被作者Azer Koçulu因与npm公司的商标纠纷撤下后,导致React、Babel等数千个项目构建失败——生动展示了传递依赖链的脆弱性,也直接促使npm修改了包撤回(unpublish)政策,规定发布超过72小时的包不可随意撤下。在安全层面,npm audit、Snyk、Socket(专注于检测供应链攻击行为模式而非仅匹配已知CVE)等工具能够扫描完整的依赖树以发现已知漏洞,但「零日」(0-day)漏洞和尚未被CVE收录的安全问题仍然是盲区。Lock文件(如package-lock.json、Gemfile.lock、poetry.lock、Cargo.lock)通过锁定完整依赖树的精确版本来提供可重复构建的保证——这是可重复构建运动(Reproducible Builds)的核心实践之一,Debian、NixOS等项目在这一方向上进行了深入探索——但也意味着每次更新都需要重新评估整个依赖树的变化。即便是合法更新,也可能意外引入有漏洞的传递依赖——你直接依赖的A库更新到新版本,而新版本的A又依赖了存在漏洞的B库。这种「依赖链传导效应」是自动化工具最难以完全覆盖的风险场景,因为它要求对整个依赖图谱进行全局性的安全评估。
因此,更合理的实践是让Copilot承担"初筛"角色:
- 自动批准低风险更新:如补丁版本的安全修复、无破坏性变更的小版本升级。实际操作中,可以结合GitHub Actions编写规则:当Copilot判定为低风险且CI测试全部通过时,自动添加
approved标签并触发合并。 - 标记高风险变更交由人工复核:如主版本升级、涉及核心依赖(如Web框架、ORM、认证库等)的更新、或changelog中包含「breaking」「deprecated」「migration required」等关键词的变更。
这种"人机协作"的模式,正是当前AI辅助开发工具的主流方向——AI负责处理规模化的重复劳动,人类负责关键决策,两者各司其职。学术界将这种模式称为「人在回路中」(Human-in-the-Loop, HITL),其核心原则是在自动化效率与人类监督之间找到最优平衡点。
AI代理正在重塑开发工作流
这篇教程虽然聚焦于一个具体而微的场景,但它折射出一个更大的趋势:GitHub正在把Copilot从一个"写代码的助手"扩展为一个"管理项目的伙伴"。依赖审查只是众多重复性工程任务中的一个缩影,未来我们有理由期待Copilot在Issue分类、代码审查、测试生成等更多环节发挥类似的作用。事实上,这种扩展已经在发生:GitHub已经推出了Copilot for Pull Requests(自动生成PR描述摘要)、Copilot Autofix(为代码扫描发现的安全漏洞自动生成修复方案)、以及Copilot在GitHub Mobile中的集成(允许开发者通过自然语言在移动端管理仓库)。这标志着AI工具正在从被动响应转向主动执行,从「副驾驶」(Copilot)到「自主代理」(Autonomous Agent)的转变。
这一转变也与更广泛的行业趋势相呼应。Microsoft(GitHub的母公司)在2024年Build大会上提出了「AI-native开发」的愿景,Google推出了Gemini Code Assist和Project IDX,Anthropic的Claude也通过MCP(Model Context Protocol)协议探索AI与开发工具的深度集成。整个行业正在从「AI辅助编码」向「AI参与全流程软件工程」演进,而依赖管理的自动化只是这场变革中最早落地的场景之一。
对于希望提升开发效率的团队和个人来说,尽早熟悉这类AI代理的能力边界与配置方式,无疑是一项值得投入的技能。正如这篇教程所倡导的,从自动化一个具体的痛点开始,是理解和拥抱AI辅助开发的最佳切入点。
想要深入了解具体的配置步骤,可以参阅GitHub官方博客的原文教程。
相关推荐
企业级AI Agent全栈开发实战:从零搭建可上线智能体的学习路径
一份企业级AI Agent全栈开发课程导学解析:涵盖为什么学Agent、适合人群、LangChain与CrewAI框架学习路径,以及从单智能体到多智能体的实战落地方案,助你搭建可上线的智能体应用。
从真实项目拆解AI智能体:基于LangGraph的学习助手架构实践
以真实上线的AI学习助手为例,拆解基于LangGraph、Neo4j知识图谱、Redis与MinIO的智能体架构实践,解析为何面试官偏爱复杂真实项目,以及FDE岗位的求职方向。
LangChain 1.3 入门指南:大模型与Agent核心概念解析
LangChain 1.3入门教程:解析大语言模型的三大局限、框架的统一接口与模块化架构,以及LLM、Agent、DeepAgent与Harness架构的层级关系,助你理解大模型应用开发核心概念。