用GPT和Grok搓出本地AI视频生成器,真能跑起来吗?
非工程师博主纯靠AI工具搭出本地视频生成应用,跑通「威尔·史密斯吃意面」测试,但算力与模型质量仍是不可绕过的护城河。
一位海外博主接受挑战,完全不写专业代码,仅借助GPT、Grok等大模型与Cursor编辑器,从零搭建了一套可本地运行的AI视频生成应用。项目分三阶段完成,产出了带前端界面的完整Python包,并集成了基于Kokoro 82M的离线语音旁白模块。以「威尔·史密斯吃意面」这一经典测试为基准,初版模型效果诡异,换用14B参数骨干后画面质量出现质变,但手指等解剖细节仍是通病。实验揭示了「用AI造AI」的真实边界:搭建应用脚手架的门槛已大幅降低,但生成质量的天花板依然由底层模型规模和硬件算力决定,12GB显存只够推理、无法训练,与商业主流模型的差距仍然显著。
一位海外博主接受了粉丝的挑战:不写一行专业代码,纯靠 GPT、Grok 等主流大模型加上 Cursor,尝试从零搭建一个能在本地运行的 AI 视频生成应用。最终的结果出人意料——这个由 AI「拼」出来的项目,竟然真的跑通了整套流程,生成了那段经典的「威尔·史密斯吃意大利面」测试视频。
从提示词到硬件约束:先摸清自己的底
博主的第一步是用 ChatGPT 梳理需求,而不是急着写代码。模型先反问了一系列关键问题:你的硬件是什么?采用哪种视频生成路径?音频怎么处理?
最终方案定为:文本到视频(text-to-video)的本地生成,配合 AI 语音旁白。这里出现了整个项目最现实的一道坎——博主的显卡只有 12GB 显存。模型给出的判断很直接:「12GB 足够跑一个像样的本地推理管线,但绝不足以从头训练一个现代视频基础模型。」
这个结论其实点出了 AI 视频生成的核心门槛。博主坦言自己并非 AI 工程师,对图像生成的理解停留在「高斯去噪」的层面——模型在每个时间步给图像加噪,再学着把它还原;而视频生成则是在此基础上处理多帧图像。这种朴素的认知恰恰代表了大量普通用户的起点,也说明了为什么「用 AI 造 AI」听起来诱人,实际却处处是坑。
高斯去噪与扩散模型简介
博主提到的「高斯去噪」实际上指的是扩散模型(Diffusion Model)的核心机制。扩散模型的训练分为两个过程:前向过程(forward process)逐步向原始图像添加高斯噪声,直至图像变成纯噪声;反向过程(reverse process)则让神经网络学习如何一步步去除噪声、还原图像。推理时,模型从随机噪声出发,通过若干「去噪步骤」生成全新的图像内容。视频生成在此基础上引入了时间维度,需要同时保证帧间的运动连贯性,计算量呈数量级增长——这也是为什么 12GB 显存可以跑推理,却远不足以从头训练:一个现代视频基础模型的参数量动辄数十亿,训练一次需要数百块高端 GPU 运行数周。
分阶段构建:Cursor 里跑出一个完整应用
确定提示词后,博主把「构建一个能从文本提示生成完整旁白视频的生产级本地应用」这句需求丢进 Cursor,然后进入了漫长的等待。整个项目被拆成了三个阶段(Phase 1/2/3),中途还换用了 GPT-5.6 等不同模型来推进。
让博主意外的是产出的完整度:不只是一个孤零零的 Python 脚本,而是一个可安装的 Python 包,配齐了各类文件,甚至还带了一个前端界面。到第三阶段完成时,系统验证信息显示:Kokoro 旁白完全离线运行、在浏览器中就位、验收脚本确认 TTS 在视频模型卸载后能干净地运行。
成品应用界面相当朴素,主要包含几个模块:生成片段(Generate Clips)、旁白(Narration)、模型与设置、硬件诊断,以及一个用于测试编码器的 Mock 生成页。硬件诊断里还提示 PyTorch 缺失、需要安装 FFmpeg——这些依赖环境问题,也是本地部署绕不开的麻烦。
第一次生成:熟悉的「诡异 AI 视频」味道
博主选择了 AI 视频界的标志性测试题——「Will Smith eating spaghetti」,这是最早的视频生成基准之一。设置 5 秒时长、9:16 竖屏、480p 标准画质后,点击生成。
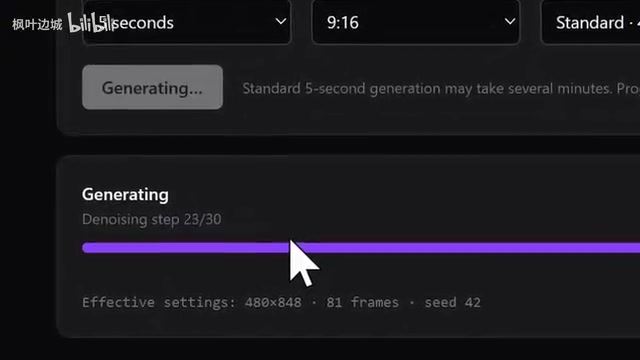
结果一言难尽:生成的人物「首先根本不是威尔·史密斯」,画面透着一股早期 AI 视频特有的诡异感。博主的评价很到位——模型知道人类有头、有脸、有两条胳膊,但对手指、嘴巴这些细节始终处理不好,人体解剖结构依然是难以攻克的痛点。他还尝试生成带文字的视频,结果同样失败,这在意料之中:连意面都搞不定,文字渲染更是奢望。
升级骨干网络:14B 模型带来质变
真正的转折点是更换更大的模型骨干。博主把后端换成了拥有 140 亿参数(14B)的模型版本。这个过程并不顺利——他熬了一整晚都没能成功生成视频,第二天更新系统和驱动后却莫名其妙跑通了,连他自己都说不清到底是什么修好了问题。
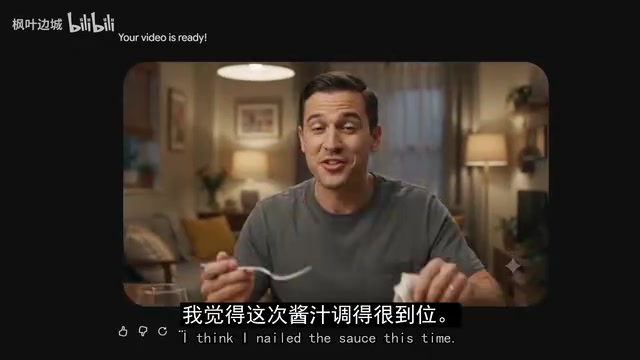
换用大模型后的效果肉眼可见地进步。同样是「威尔·史密斯吃意面」的提示词,新版本的细节丰富得多:画面里出现了一个瓶子,模型「理解」了这是在用餐场景、桌上该有饮品;甚至自作主张多加了一位女性角色。更让博主惊讶的是,虽然提示词只写了「Will Smith」,生成人物的种族竟与威尔·史密斯一致。食物这次看起来相当有食欲,博主直言「我真的会吃这个」。
不过老问题依旧存在——手指的处理还是别扭。这也印证了一个规律:模型规模上去了,整体表现会有跨越式提升,但那些最细微的物理与解剖细节,仍是当前技术的共同短板。
模型参数量与生成质量的关系
「14B」指的是该模型拥有约 140 亿个可学习参数。参数量是衡量模型容量的重要指标:参数越多,模型能编码的视觉模式、语义关联和物理规律就越丰富。在视频生成领域,更大的参数量通常意味着更强的「世界理解能力」——模型能更准确地推断场景构成(如餐桌上应有饮品)、人物外貌特征(如种族一致性)以及动态细节。然而参数量的增加也带来显存占用的线性乃至超线性增长,这正是消费级 GPU 的瓶颈所在。手指、牙齿等解剖细节之所以在更大模型下仍难以完美呈现,是因为这些局部结构在训练数据中变化极大、形变复杂,需要极高的模型容量和数据量才能可靠建模,目前属于整个领域的共同难题。
旁白模块:本地 TTS 的惊喜与局限
应用还有一个尚未展示的旁白页面,基于 Kokoro 82M 参数模型实现。它的运行逻辑很讲究:引擎按请求加载、合成、卸载,绝不在视频任务占用 GPU 时抢资源。
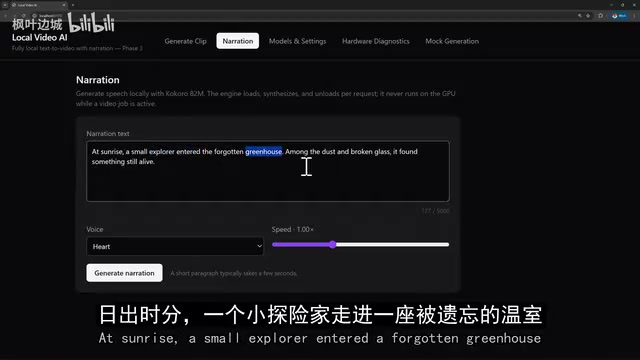
博主用一段示例文本(「日出时分,一位小探险家走进了被遗忘的温室……」)测试合成,8 秒的旁白效果「出乎意料地好」。但他也点出一个认知落差:原本以为能上传视频后自动配音甚至对口型(lip-sync),实际它只是像 ElevenLabs 那样单纯生成音频,与画面并不同步。在试听多个音色后,他认为名为 Nicole 的声音最稳定,其他音色有的表现相当跑偏。
Kokoro 与本地 TTS 技术背景
Kokoro 是一款轻量级的开源文本转语音(TTS)模型,82M 参数的体量使其能在 CPU 甚至低端 GPU 上流畅运行,非常适合与视频推理任务错峰使用。它基于流式声学模型架构,能够合成多种音色和语调风格。与 ElevenLabs 等云端服务相比,本地 TTS 的核心优势在于完全离线、无调用费用、数据不出本机;局限则在于音色稳定性参差不齐,且不具备「对口型」(lip-sync)能力——后者需要额外的驱动网络(如 SadTalker、Wav2Lip)将音频波形与人脸关键点动画对齐,属于独立的研究方向,远比单纯的语音合成复杂。
这个实验说明了什么
抛开娱乐性,这次尝试给出了几点值得琢磨的启示。用 AI 编排、Cursor 落地,一个非工程师背景的人确实能搭出一个功能完整、前后端俱全的本地视频生成应用——这在几年前几乎不可想象。但成品质量与 Nano Banana 等当下主流模型仍有明显差距,博主也承认,受限于自己的硬件,想在此基础上继续训练优化几乎不可能。
换句话说,「用 AI 造 AI」降低了搭建脚手架的门槛,却没有绕开算力与数据这两道真正的护城河。生成质量的天花板,最终还是由底层模型和硬件决定的。对于想动手实验的爱好者来说,这是个有趣的周末项目;但要产出可用级别的成果,距离还很远。
相关推荐
Boox Palma 3发布:新增手写笔支持与全新设计
Boox Palma 3正式发布,新增手写笔支持并采用全新简洁设计。作为口袋尺寸的黑白电子墨水屏阅读器,它在功能升级的同时价格明显上涨。本文解析Palma 3的核心变化与升级价值。
Cursor 3.0 完整入门指南:从零上手 AI 编程 IDE
Cursor 3.0 完整入门教程:从下载安装、创建项目到并行子代理、云端开发、技能与自动化等高级功能。零基础也能上手这款 AI 编程 IDE,掌握模型选择、设计模式与 Git 版本控制的实用技巧。
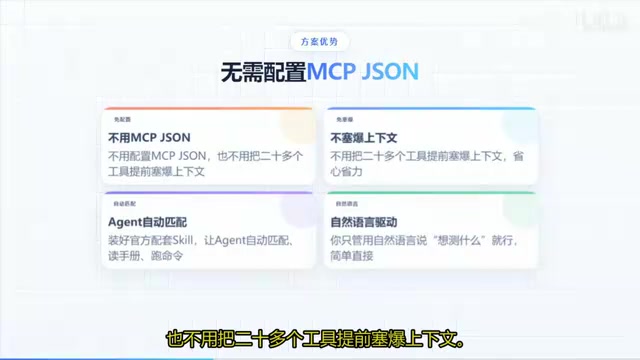
Codex+Playwright封装测试Skill:UI自动化不再手敲命令
把 Playwright 封装成 Codex Skill,让 AI Agent 通过自然语言完成 UI 自动化测试。本文详解安装加载、Sauce Demo 实战、PO 分层模板,以及 MCP 与 CLI+Skill 的选型对照。